
Xử lý dữ liệu bằng SPSS: từ codebook đến một quy trình có thể tái lập
Một tệp output đẹp chưa chứng minh quy trình đúng. Người khác phải biết dữ liệu đã được mã hóa, kiểm tra và biến đổi như thế nào trước khi mô hình được ước lượng.
Quy trình SPSS có thể tái lập cần giữ dữ liệu gốc bất biến, định nghĩa missing rõ ràng, thực hiện các bước quyết định bằng syntax và lưu dấu vết từ dữ liệu đến báo cáo. Syntax giúp kiểm tra lại thứ tự lệnh và tái chạy phân tích khi dữ liệu thay đổi (IBM, n.d.-a; Wilson et al., 2017).
Một quy trình phân tích có thể tái lập
- Codebook
Tên biến, mã hóa và missing
- Xử lý
Lưu các bước làm sạch dữ liệu
- Phân tích
Giữ cấu hình và mã lệnh
- Hồ sơ
Lưu kết quả và phiên bản
Sơ đồ khái niệm. Giữ dữ liệu gốc và dấu vết thay đổi để có thể kiểm tra lại.
Nguồn: Lê Minh biên soạn · Minh họa khái niệm, không phải đầu ra phần mềm.1. Xác định đầu ra trước khi mở SPSS
Xử lý dữ liệu không đồng nghĩa với sửa một vài ô trong Data View. Mục tiêu là tạo được một tập dữ liệu phân tích có nguồn gốc rõ ràng, một tập lệnh tái chạy được và một bộ kết quả khớp với câu hỏi nghiên cứu.
Trước khi nhập dữ liệu, hãy ghi biến phụ thuộc, biến giải thích, biến kiểm soát, thang điểm và quy tắc loại trường hợp. Những quyết định này đi vào codebook. Nếu chúng chỉ nằm trong trí nhớ của người phân tích, việc kiểm tra sau đó gần như không thể.
| Đầu ra | Nội dung cần có | Cách kiểm tra |
|---|---|---|
| Codebook | Tên biến, nhãn, mã giá trị, missing, mức đo | Đối chiếu bảng hỏi và Variable View |
| Dữ liệu phân tích | Các biến đã làm sạch và biến dẫn xuất | Tạo lại được từ dữ liệu gốc bằng syntax |
| Syntax | Nhập, kiểm tra, biến đổi và phân tích | Chạy từ đầu trong một phiên mới |
| Output | Bảng, biểu đồ, cảnh báo và mô hình | Khớp với syntax và phiên bản dữ liệu |
| Nhật ký quyết định | Lý do recode, loại trường hợp hoặc đổi mô hình | Có ngày, người thực hiện và căn cứ |
2. Tổ chức thư mục và bảo vệ dữ liệu gốc
Dữ liệu gốc nên ở trạng thái chỉ đọc. Mọi chỉnh sửa phải tạo thành dữ liệu dẫn xuất. Cách tổ chức này phù hợp với nguyên tắc tách dữ liệu, mã lệnh và kết quả trong nghiên cứu tái lập (Wilson et al., 2017).
Tên thư mục và tên tệp nên ổn định. Tránh các tên như final, final2 hoặc final_moi vì chúng không cho biết tệp nào đã tạo ra kết quả trong luận văn.
| Đường dẫn | Vai trò |
|---|---|
| data/raw/ | Tệp nhận ban đầu, không chỉnh sửa |
| data/derived/ | Tệp .sav được tạo bằng syntax |
| syntax/ | Tệp .sps theo thứ tự 01, 02, 03 |
| output/ | Tệp .spv và bản xuất PDF |
| docs/ | Codebook, nhật ký quyết định và README |
Nếu phát hiện một giá trị sai, hãy ghi quy tắc sửa trong syntax và lưu sang tệp dẫn xuất. Cách này giữ được dấu vết kiểm toán.
3. Chuyển bảng hỏi thành codebook
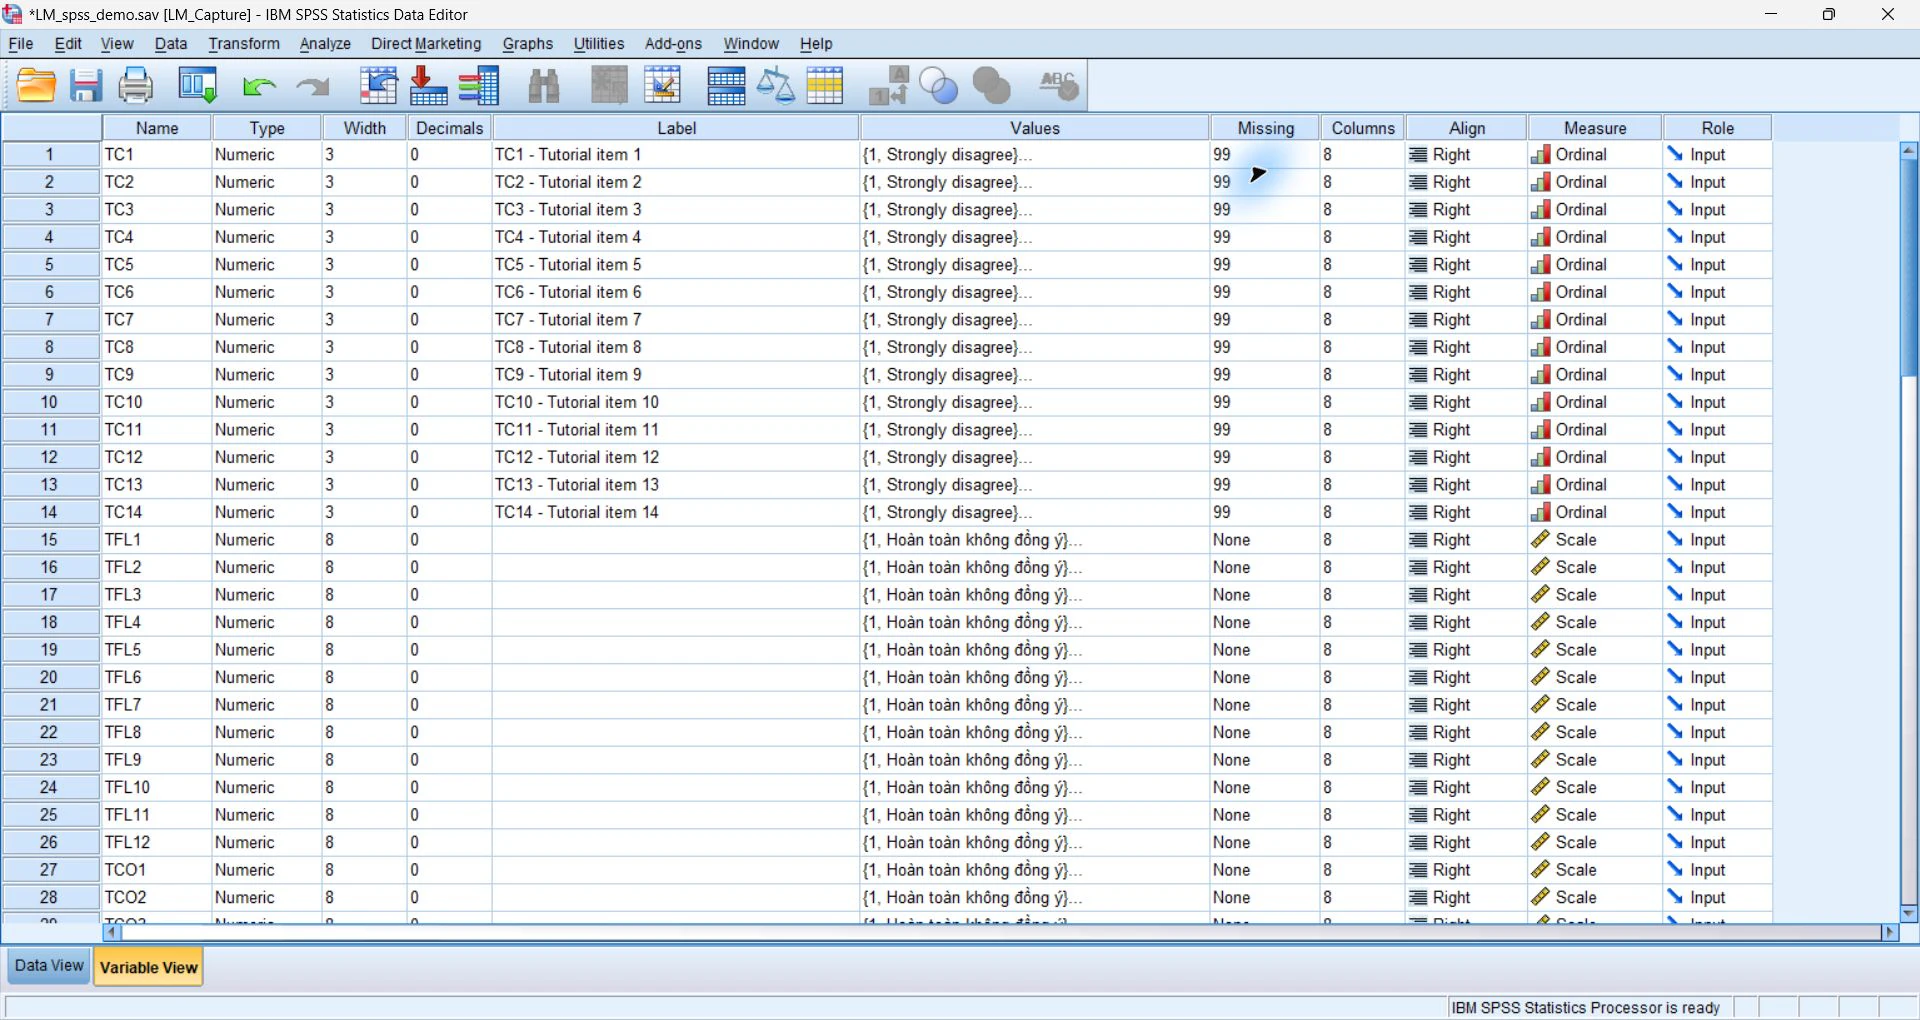
Variable View là biểu diễn kỹ thuật của codebook, nhưng codebook nên tồn tại độc lập trong một bảng có thể đọc được. Mỗi dòng mô tả một biến. Các cột tối thiểu gồm tên biến, câu hỏi, kiểu dữ liệu, nhãn giá trị, mã missing, phạm vi hợp lệ và vai trò trong phân tích.
Cần phân biệt system-missing với user-missing. System-missing xuất hiện khi SPSS không có giá trị số. User-missing là một mã có chủ đích, chẳng hạn 99 cho câu trả lời không áp dụng. SPSS chỉ xử lý đúng user-missing sau khi người phân tích khai báo mã đó (IBM, n.d.-b).
| Biến | Nhãn | Mã hợp lệ | Missing | Mức đo |
|---|---|---|---|---|
| id | Mã người trả lời | Duy nhất | Không | Nominal |
| gender | Giới tính tự khai báo | 1, 2, 3 | 99 | Nominal |
| satisfaction1 đến satisfaction4 | Bốn chỉ báo hài lòng | 1 đến 5 | 99 | Ordinal |
| trust1 đến trust4 | Bốn chỉ báo niềm tin | 1 đến 5 | 99 | Ordinal |
| outcome | Kết quả liên tục minh họa | Theo thiết kế | 99 | Scale |
4. Nhập dữ liệu và kiểm tra cấu trúc
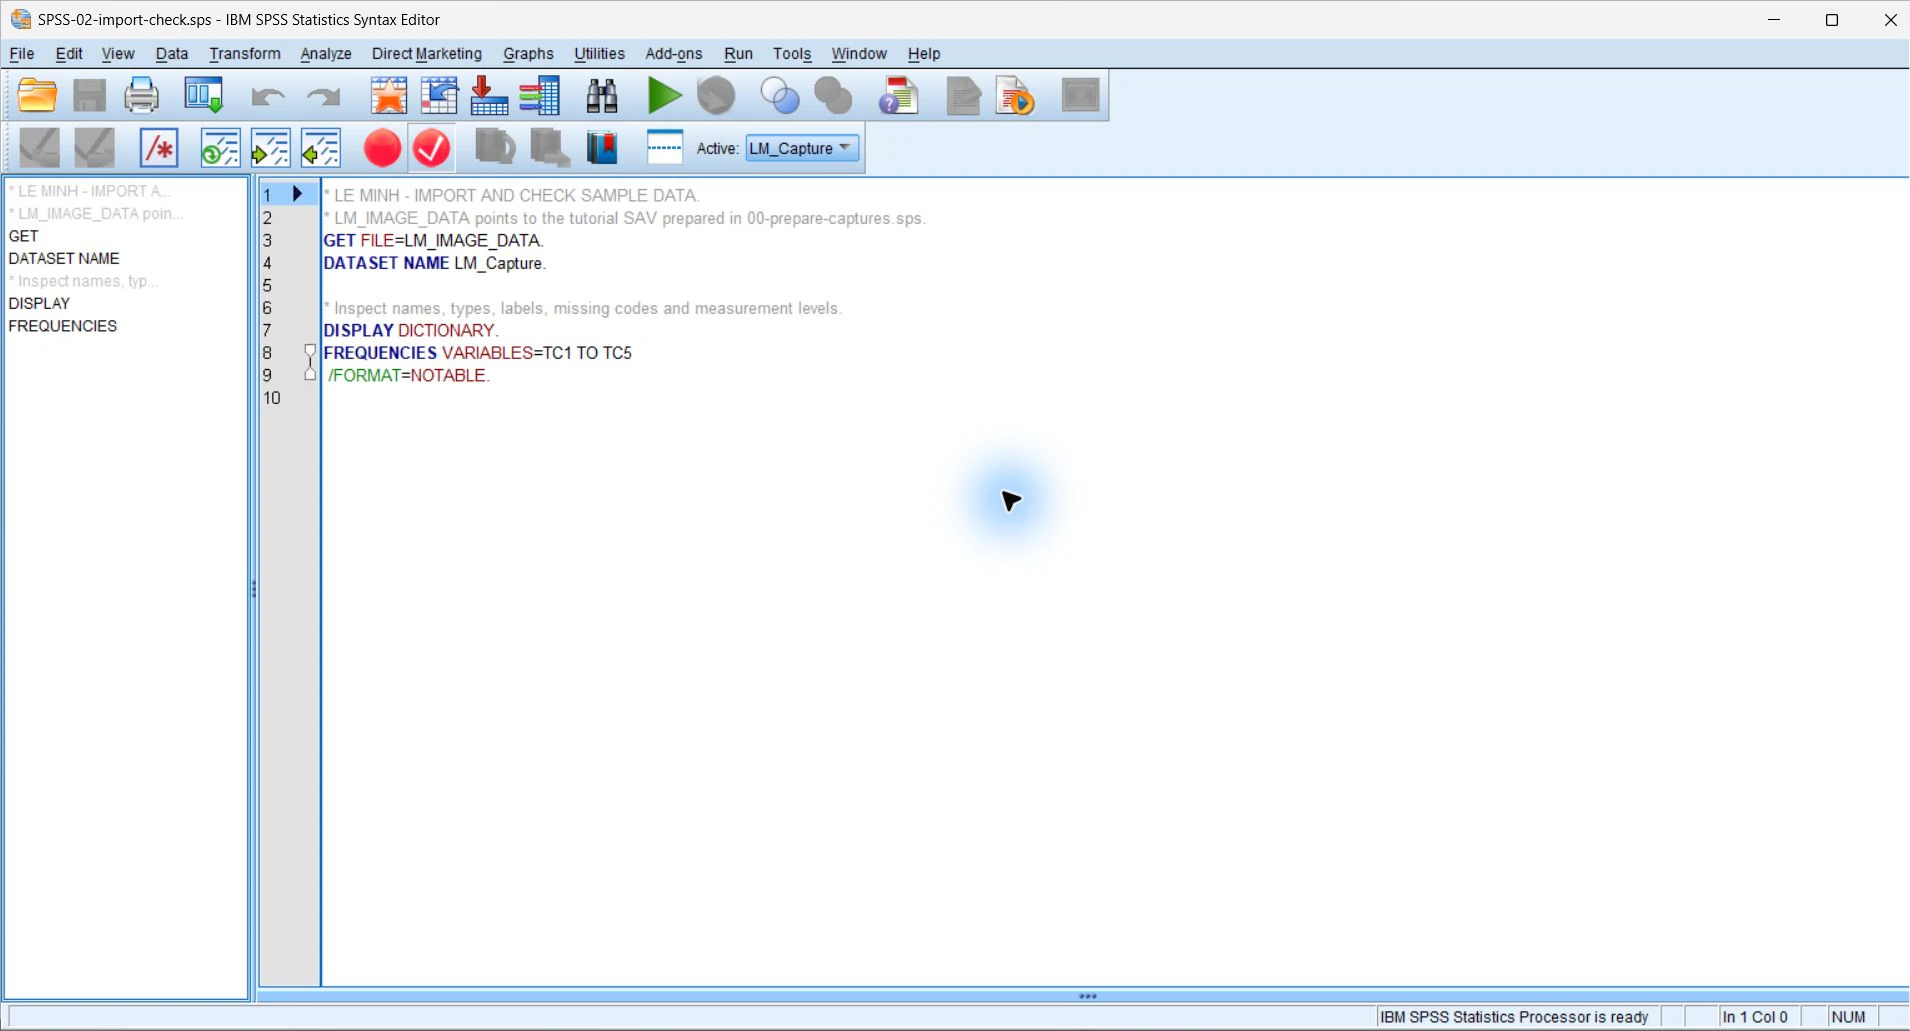
Sau khi nhập, hãy kiểm tra số dòng, số biến, kiểu biến, ID trùng và phạm vi giá trị trước khi tính điểm thang đo. Một tệp mở được không có nghĩa là dữ liệu đã được đọc đúng.
Lệnh dưới đây minh họa quy trình với tệp CSV giả lập. Tên tệp và quy tắc mã hóa phải được điều chỉnh theo codebook thật.
GET DATA
  /TYPE=TXT
  /FILE='data/raw/survey.csv'
  /ENCODING='UTF8'
  /DELCASE=LINE
  /DELIMITERS=","
  /QUALIFIER='"'
  /ARRANGEMENT=DELIMITED
  /FIRSTCASE=2
  /IMPORTCASE=ALL.
DATASET NAME survey.

DISPLAY DICTIONARY.
FREQUENCIES VARIABLES=gender age
  satisfaction1 TO satisfaction4
  /STATISTICS=MINIMUM MAXIMUM.

SORT CASES BY id.
MATCH FILES FILE=* /BY id /FIRST=first_id.
FREQUENCIES VARIABLES=first_id.Nếu ID không duy nhất, dừng quy trình và truy nguyên trước khi gộp tệp hoặc chạy mô hình.
5. Khai báo và đánh giá dữ liệu thiếu
Missing phải được định nghĩa trước khi tính điểm. Nếu mã 99 bị giữ như một giá trị hợp lệ trong thang 1 đến 5, trung bình, độ lệch chuẩn và tương quan đều bị sai.
Missing Value Analysis cung cấp mô tả mẫu thiếu và một số thủ tục chẩn đoán, nhưng khả năng sử dụng phụ thuộc phiên bản hoặc module của SPSS (IBM, n.d.-c). Cơ chế thiếu không nên được kết luận từ một bảng phần trăm đơn lẻ. Cần xem thiết kế thu thập, logic bỏ qua câu hỏi và mối liên hệ giữa thiếu với các biến quan sát.
MISSING VALUES gender age
  satisfaction1 TO satisfaction4
  trust1 TO trust4 outcome (99).

FREQUENCIES VARIABLES=gender age
  satisfaction1 TO satisfaction4
  trust1 TO trust4 outcome
  /ORDER=ANALYSIS.

MVA VARIABLES=satisfaction1 TO satisfaction4
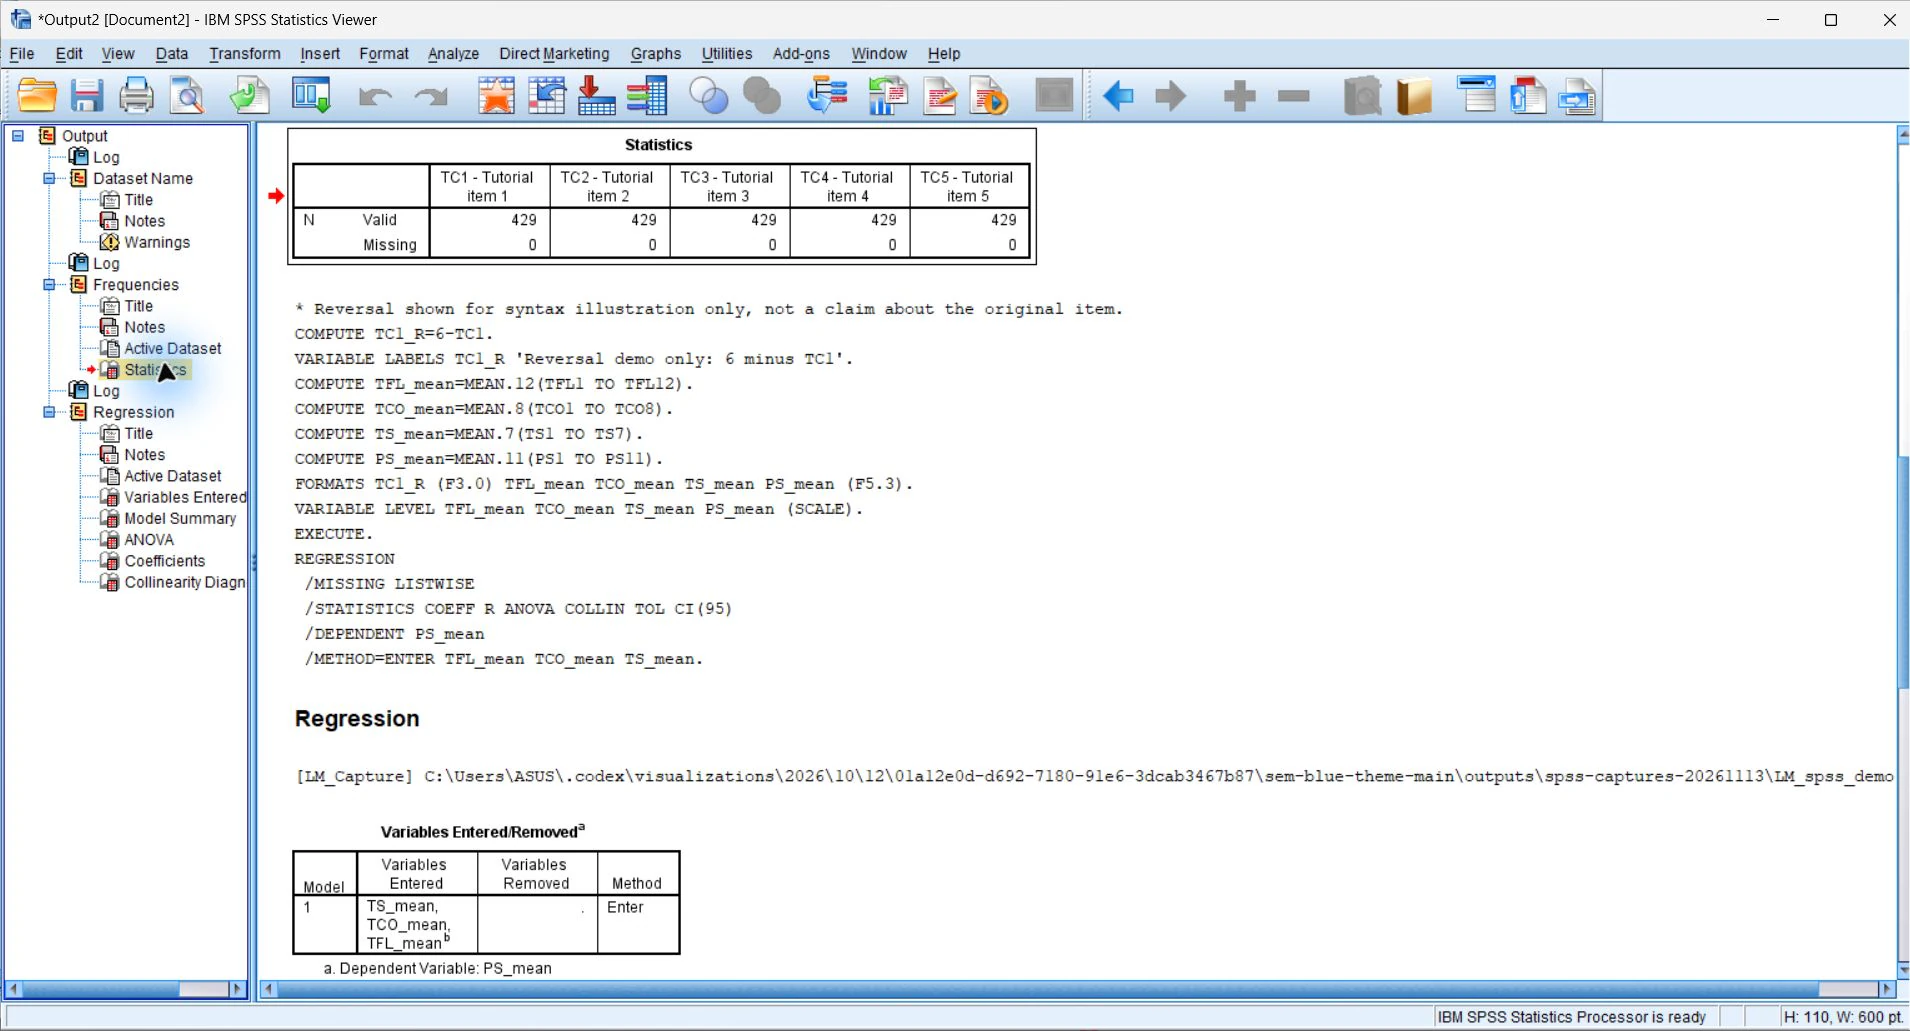
trust1 TO trust4 outcome.Cách xử lý phải phù hợp với cơ chế thiếu, mục tiêu phân tích và estimator. Hãy báo cáo tỷ lệ thiếu, quy tắc xử lý và phân tích độ nhạy khi quyết định có thể ảnh hưởng kết luận.
6. Tạo biến dẫn xuất bằng syntax
RECODE nên tạo biến mới bằng INTO khi cần giữ giá trị ban đầu. COMPUTE dùng cho điểm trung bình, tổng điểm hoặc biến tương tác. Sau mỗi biến đổi, hãy chạy FREQUENCIES hoặc DESCRIPTIVES để kiểm tra phạm vi.
Ví dụ dùng hàm MEAN.3, nghĩa là điểm hài lòng chỉ được tạo khi có ít nhất ba trong bốn chỉ báo hợp lệ. Đây là quy tắc minh họa, không phải chuẩn chung. Số lượng tối thiểu phải được quyết định từ cấu trúc thang đo và kế hoạch phân tích.
RECODE satisfaction2 (1=5) (2=4) (3=3) (4=2) (5=1)
  INTO satisfaction2_r.
VARIABLE LABELS satisfaction2_r
  'Satisfaction item 2, reverse scored'.

COMPUTE satisfaction_mean =
  MEAN.3(satisfaction1, satisfaction2_r, satisfaction3, satisfaction4).
COMPUTE trust_mean =
  MEAN.3(trust1, trust2, trust3, trust4).
EXECUTE.

DESCRIPTIVES VARIABLES=satisfaction_mean trust_mean
  /STATISTICS=MEAN STDDEV MIN MAX.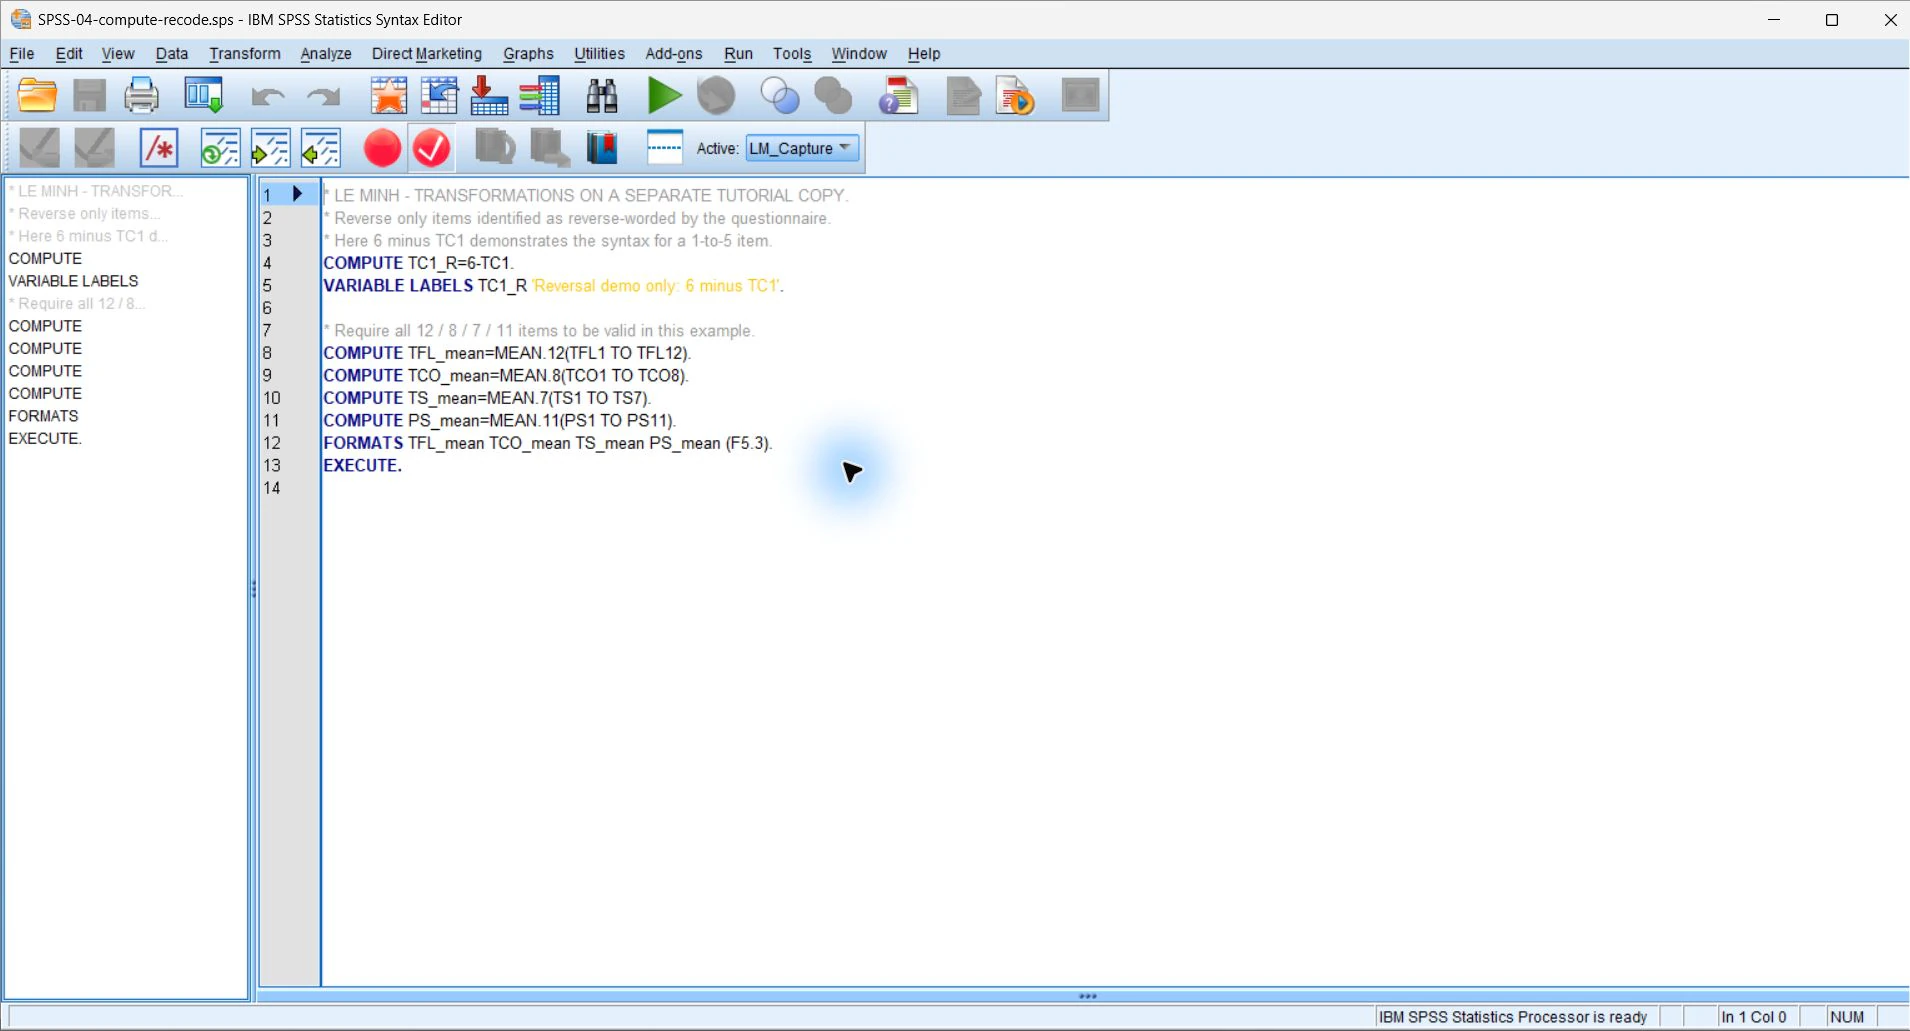
7. Kiểm tra mô tả và độ tin cậy trước mô hình chính
Hãy xem phân phối, giá trị ngoài phạm vi và quan hệ giữa các chỉ báo trước khi chạy mô hình. Cronbach's alpha không thay thế đánh giá cấu trúc thang đo. Nó chỉ là một phần của bằng chứng độ tin cậy.
Nếu một chỉ báo bị loại, lý do phải dựa trên nội dung, chất lượng đo lường và kết quả chẩn đoán. Không nên loại chỉ báo chỉ vì alpha tăng nhẹ.
EXAMINE VARIABLES=satisfaction_mean trust_mean outcome
  /PLOT=HISTOGRAM NPPLOT
  /STATISTICS=DESCRIPTIVES
  /MISSING=LISTWISE.

RELIABILITY
  /VARIABLES=satisfaction1 satisfaction2_r satisfaction3 satisfaction4
  /SCALE('Satisfaction') ALL
  /MODEL=ALPHA
  /STATISTICS=DESCRIPTIVE SCALE CORR.
8. Ước lượng mô hình và giữ đúng câu hỏi nghiên cứu
Phân tích hồi quy dưới đây chỉ minh họa đường đi của dữ liệu. Việc chọn mô hình, sai số chuẩn và biến kiểm soát phải dựa trên thiết kế nghiên cứu. Kết quả cần trình bày hệ số, khoảng tin cậy và điều kiện áp dụng, thay vì chỉ báo p-value.
Thứ tự lệnh và subcommand trong syntax có quy tắc cụ thể. Tài liệu Command Syntax Reference là nguồn cần đối chiếu khi một lệnh không chạy hoặc khi cần biết giá trị mặc định (IBM, n.d.-a).
| Đầu ra | Câu hỏi cần trả lời | Giới hạn cần ghi |
|---|---|---|
| Coefficients | Hệ số có chiều và độ lớn ra sao? | Phụ thuộc mã hóa, thang đo và đặc tả |
| 95% CI | Khoảng giá trị tương thích với dữ liệu là gì? | Không phải xác suất tham số nằm trong khoảng |
| Residual plots | Có dấu hiệu sai dạng hàm hoặc phương sai thay đổi không? | Chẩn đoán bằng hình cần kết hợp lý thuyết |
| R squared | Mô hình giải thích bao nhiêu biến thiên trong mẫu? | Không đồng nghĩa dự báo ngoài mẫu |
REGRESSION
  /STATISTICS=COEFF OUTS R ANOVA CI(95)
  /DEPENDENT=outcome
  /METHOD=ENTER satisfaction_mean trust_mean age
  /RESIDUALS=HISTOGRAM(ZRESID) NORMPROB(ZRESID)
  /SAVE=PRED RESID.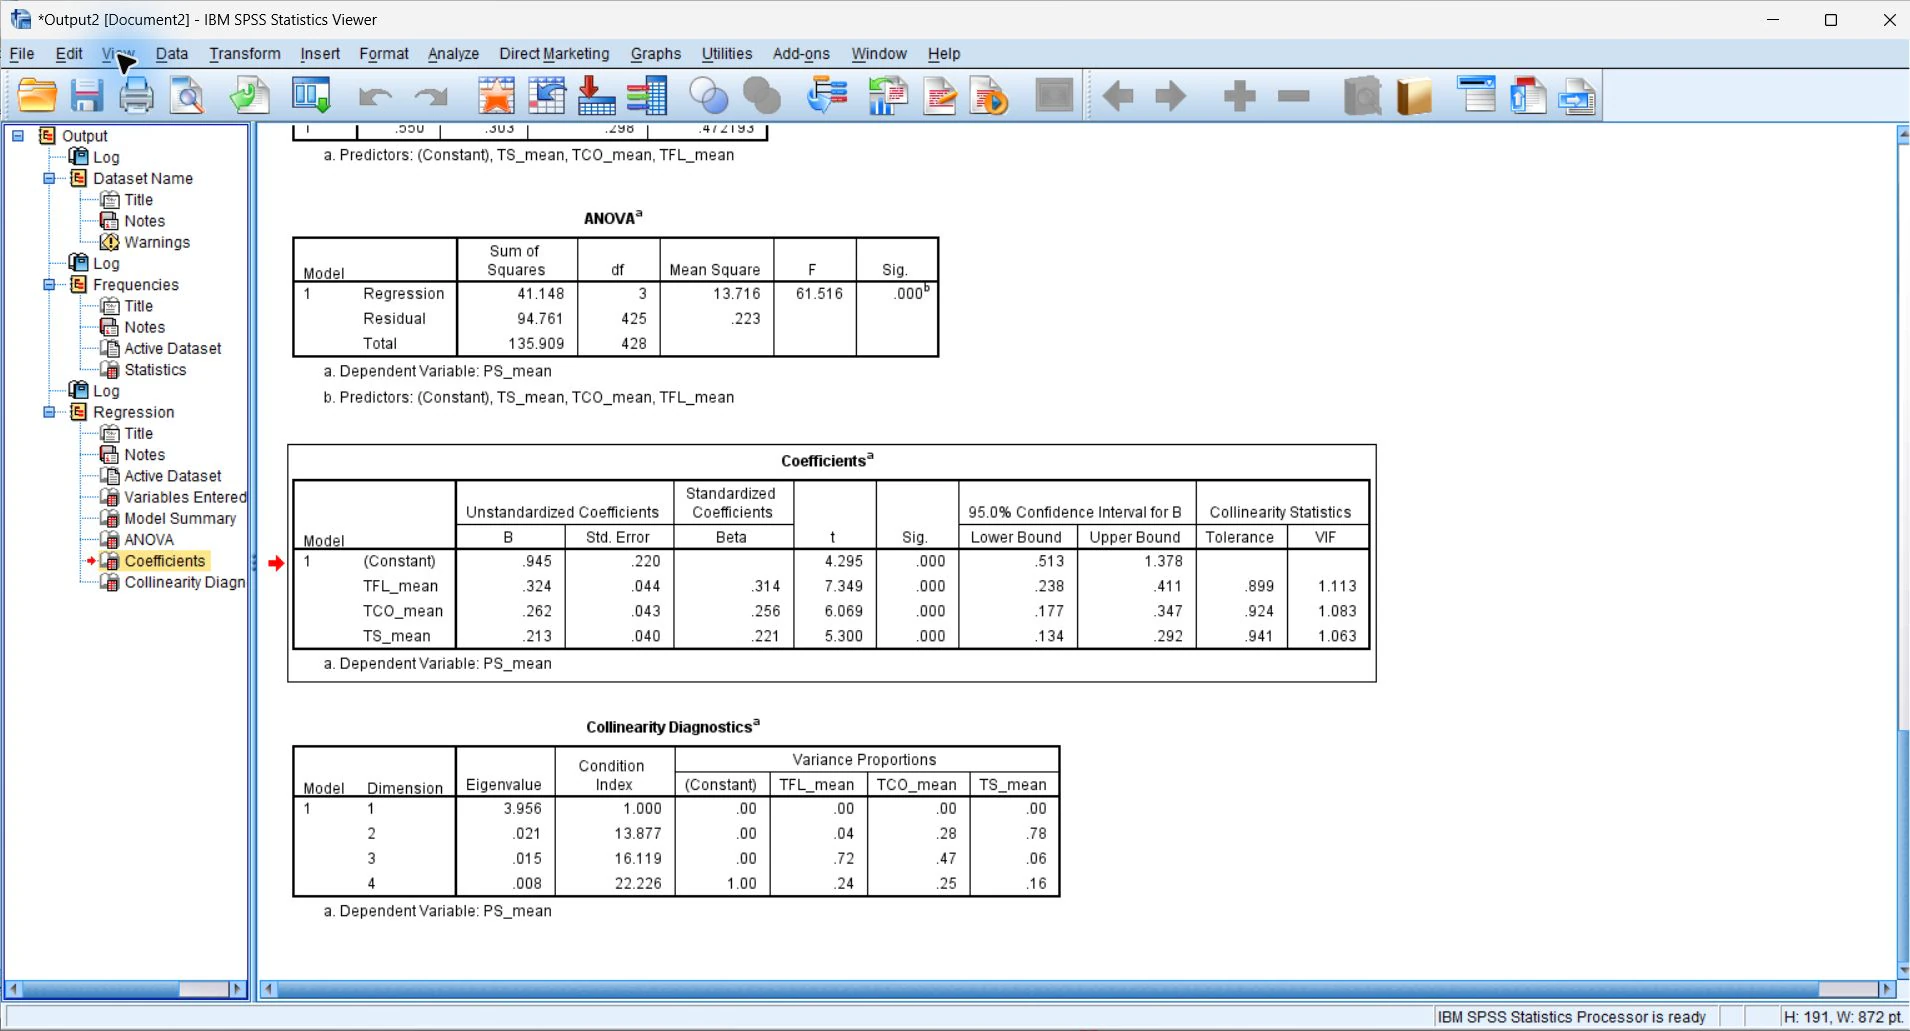
9. Chạy lại từ đầu và lưu dấu vết
Đóng tệp dữ liệu, mở một phiên SPSS mới và chạy syntax từ dòng đầu. Nếu output không thể tạo lại, quy trình chưa hoàn tất. Hãy lưu cả output gốc và bản PDF để có định dạng bền vững.
Paste từ hộp thoại sang Syntax Editor hữu ích khi học lệnh. Trước khi chạy, cần đọc lại syntax vì tùy chọn mặc định trong hộp thoại có thể không trùng với kế hoạch phân tích.
Đóng phiên làm việc
Bảo đảm không dựa vào biến tạm hoặc thao tác chưa ghi.
Chạy toàn bộ syntax
Theo dõi warning, số trường hợp và thay đổi kích thước mẫu.
Đối chiếu output
Kiểm tra bảng dùng trong bài báo có đúng lần chạy cuối.
Lưu phiên bản
Gắn ngày hoặc mã phiên bản cho syntax, dữ liệu dẫn xuất và output.
10. Mẫu báo cáo và bảng kiểm bàn giao
Mẫu báo cáo tiếng Việt
Dữ liệu được xử lý trong IBM SPSS Statistics [phiên bản]. Dữ liệu gốc được giữ bất biến; các mã thiếu [mô tả] được khai báo trước khi tạo biến. Điểm [tên thang đo] được tính khi có tối thiểu [số] chỉ báo hợp lệ theo quy tắc đã đăng ký. Mô hình [tên mô hình] được ước lượng trên [N] trường hợp. Hệ số của [X] là b = [ ], SE = [ ], 95% CI [ , ], p = [ ]. Các kiểm tra chẩn đoán cho thấy [mô tả ngắn và giới hạn].
- Dữ liệu gốc chưa bị ghi đè.
- Codebook khớp với bảng hỏi và Variable View.
- Mã missing được khai báo trước khi tính điểm.
- ID trùng, phạm vi và logic bỏ qua đã được kiểm tra.
- Mọi recode và compute đều có syntax.
- Số trường hợp ở mỗi phân tích được ghi lại.
- Bảng báo cáo truy được về output và syntax tương ứng.
- Phiên bản SPSS và module sử dụng được nêu rõ.
Kết luận
Một workflow SPSS tốt cho phép người khác đi từ dữ liệu gốc đến đúng bảng kết quả bằng cùng một tập lệnh. Giao diện giúp thao tác nhanh, còn syntax, codebook và nhật ký quyết định tạo ra khả năng kiểm tra.
Tài liệu tham khảo
- IBM. (n.d.-a). Introduction to the Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-introduction-guide-command-syntax
- IBM. (n.d.-b). Missing values: Overview (MISSING VALUES command). https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=values-overview-missing-command
- IBM. (n.d.-c). Missing Value Analysis. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=values-missing-value-analysis
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), e1005510. https://doi.org/10.1371/journal.pcbi.1005510
Ghi chú học thuật: Lệnh MVA và một số thủ tục phụ thuộc phiên bản hoặc license. Hãy đối chiếu tài liệu đúng với phiên bản IBM SPSS Statistics đang sử dụng. Dữ liệu và kết quả trong ví dụ chỉ dùng để minh họa quy trình.