
Xử lý dữ liệu bằng R: một workflow chạy được từ đầu đến cuối
Mã lệnh chỉ có giá trị khi chạy được trong một phiên sạch, đọc đúng dữ liệu đầu vào và tạo lại đúng bảng hoặc hình đã báo cáo.
Một workflow R đáng tin cậy tách dữ liệu gốc, dữ liệu dẫn xuất, mã lệnh và đầu ra; dùng đường dẫn tương đối trong RStudio Project; kiểm tra giả định bằng code; ghi lại phiên bản R và package. Các thực hành này giúp giảm phụ thuộc vào trạng thái ẩn của máy người phân tích (Posit Software, PBC, n.d.-a; Wilson et al., 2017).
Một quy trình phân tích có thể tái lập
- Codebook
Tên biến, mã hóa và missing
- Xử lý
Lưu các bước làm sạch dữ liệu
- Phân tích
Giữ cấu hình và mã lệnh
- Hồ sơ
Lưu kết quả và phiên bản
Sơ đồ khái niệm. Giữ dữ liệu gốc và dấu vết thay đổi để có thể kiểm tra lại.
Nguồn: Lê Minh biên soạn · Minh họa khái niệm, không phải đầu ra phần mềm.1. Từ script rời rạc đến một dự án phân tích
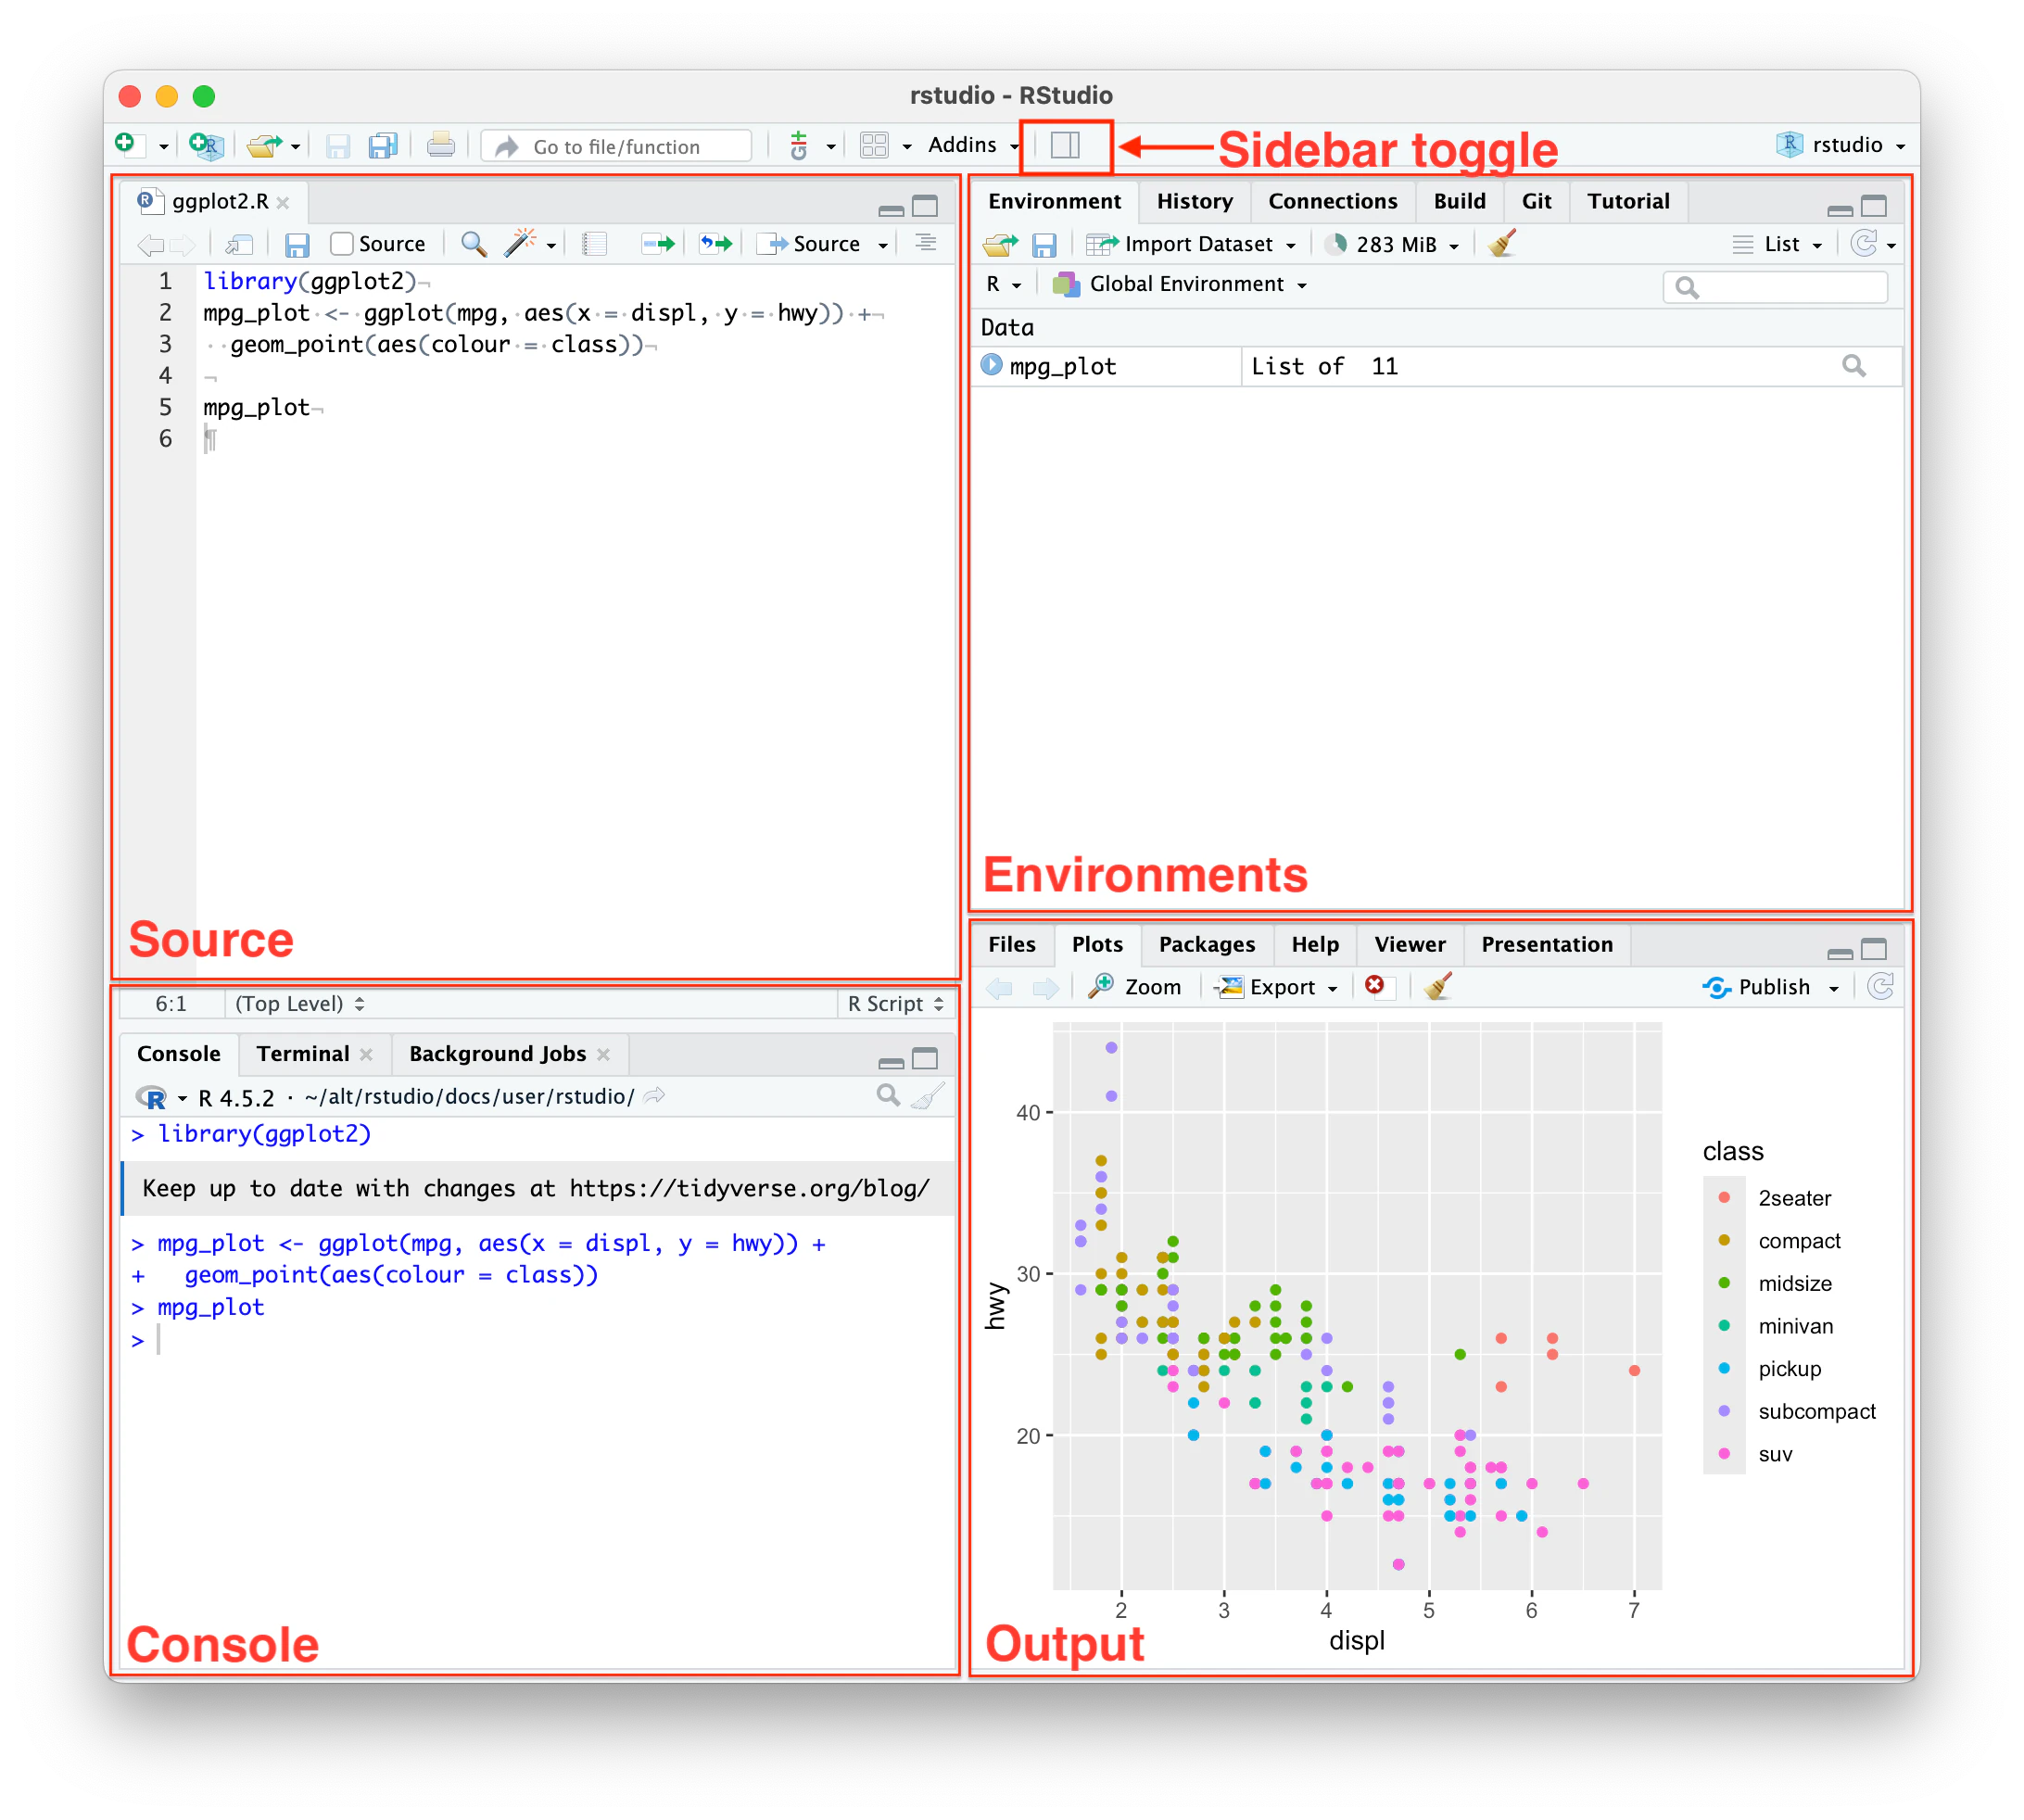
Một script chạy được trên máy người viết chưa chắc chạy được ở máy khác. Nguyên nhân thường nằm ở đường dẫn tuyệt đối, object còn sót trong Environment, package chưa được ghi phiên bản hoặc dữ liệu đã bị sửa ngoài code.
RStudio Project tạo một thư mục gốc ổn định cho mã, dữ liệu và đầu ra. Tài liệu của Posit khuyến nghị dùng project để tách bối cảnh làm việc và quản lý tệp liên quan (Posit Software, PBC, n.d.-a).
Hãy khởi động một phiên R sạch, mở project và chạy script chính. Nếu kết quả được tạo lại mà không thao tác bằng tay, workflow đã qua được kiểm tra cơ bản.
2. Cấu trúc thư mục và nguyên tắc dữ liệu bất biến
Dữ liệu gốc nằm trong data/raw và không bị ghi đè. Script tạo dữ liệu phân tích trong data/derived. Bảng và hình được sinh tự động vào output. Cấu trúc này giữ ranh giới rõ giữa đầu vào, biến đổi và sản phẩm.
Không lưu mật khẩu, API key hoặc dữ liệu nhận diện cá nhân trong kho mã. Nếu dữ liệu nhạy cảm, file dữ liệu cần nằm ngoài kho công khai và README phải giải thích cách cấp quyền.
| Thư mục hoặc tệp | Nội dung |
|---|---|
| data/raw/ | Dữ liệu nhận ban đầu, chỉ đọc |
| data/derived/ | Dữ liệu do script tạo |
| R/ | Hàm dùng lại |
| scripts/ | 01_import.R, 02_clean.R, 03_analysis.R |
| output/tables và output/figures | Bảng và hình sinh tự động |
| README.md | Thứ tự chạy, đầu vào và đầu ra |
| renv.lock hoặc mô tả môi trường | Phiên bản package cần thiết |
3. Khởi động từ một phiên sạch
RStudio có thể khôi phục workspace cũ. Cơ chế này tiện trong khám phá, nhưng object ẩn có thể làm script chạy thành công dù thiếu một bước tạo dữ liệu. Hãy tắt tự động khôi phục .RData và viết script tự tạo mọi object cần thiết.
Tài liệu RStudio mô tả cách cấu hình workspace và startup. Nhóm nghiên cứu nên thống nhất cài đặt này trong README (Posit Software, PBC, n.d.-b).
# Chạy sau khi mở đúng RStudio Project
getwd()

required_dirs <- c(
  "data/raw",
  "data/derived",
  "output/tables",
  "output/figures"
)

for (path in required_dirs) {
  if (!dir.exists(path)) dir.create(path, recursive = TRUE)
}

set.seed(20261025)Đường dẫn như C:/Users/TenNguoiDung chỉ hoạt động trên một máy. Đường dẫn tương đối trong project giúp mã có thể di chuyển.
4. Nhập và kiểm tra schema dữ liệu
Kiểm tra schema ngay sau khi nhập: số dòng, tên biến, kiểu dữ liệu, tính duy nhất của ID, phạm vi và số giá trị thiếu. Không đợi đến khi mô hình báo lỗi mới quay lại bước này.
Ví dụ dùng hàm có sẵn của R để người đọc có thể chạy mà chưa cần cài package. Mã 99 được chuyển thành NA ngay khi nhập vì codebook quy định đây là user-missing.
raw <- read.csv(
  "data/raw/survey.csv",
  na.strings = c("", "NA", "99"),
  stringsAsFactors = FALSE
)

stopifnot("id" %in% names(raw))
stopifnot(!anyDuplicated(raw$id))

str(raw)
summary(raw)
colSums(is.na(raw))

likert_items <- c(
  paste0("satisfaction", 1:4),
  paste0("trust", 1:4)
)

range_errors <- vapply(
  raw[likert_items],
  function(x) sum(!is.na(x) & !(x %in% 1:5)),
  integer(1)
)

range_errors
5. Khai báo kiểu dữ liệu và nhãn phân loại
Một cột số không nhất thiết là biến liên tục. Mã 1, 2 và 3 của giới tính là nhãn phân loại. Chuyển thành factor giúp R không tự coi chênh lệch giữa các mã là khoảng cách định lượng.
Thứ tự của factor ảnh hưởng nhóm tham chiếu trong mô hình. Vì vậy levels và labels cần được khai báo bằng code, không dựa vào thứ tự xuất hiện trong tệp.
analysis <- raw

analysis$gender <- factor(
  analysis$gender,
  levels = c(1, 2, 3),
  labels = c("Woman", "Man", "Self-described")
)

analysis$satisfaction2_r <-
  ifelse(
    is.na(analysis$satisfaction2),
    NA,
    6 - analysis$satisfaction2
  )
6. Tạo điểm thang đo với quy tắc thiếu minh bạch
rowMeans với na.rm = TRUE có thể tạo điểm từ chỉ một chỉ báo còn lại. Điều đó thường không phù hợp nếu thang đo dự kiến phản ánh nhiều nội dung. Ví dụ dưới đây yêu cầu ít nhất ba trong bốn chỉ báo hợp lệ.
Quy tắc ba trên bốn chỉ là minh họa. Nghiên cứu phải xác định quy tắc từ thiết kế thang đo, mức độ thiếu và kế hoạch phân tích trước khi xem kết quả.
score_if_enough <- function(data, variables, min_valid) {
  values <- data[variables]
  n_valid <- rowSums(!is.na(values))
  score <- rowMeans(values, na.rm = TRUE)
  score[n_valid < min_valid] <- NA_real_
  score
}

analysis$satisfaction_mean <- score_if_enough(
  analysis,
  c("satisfaction1", "satisfaction2_r",
    "satisfaction3", "satisfaction4"),
  min_valid = 3
)

analysis$trust_mean <- score_if_enough(
  analysis,
  paste0("trust", 1:4),
  min_valid = 3
)
7. Mô tả dữ liệu và tạo hình kiểm tra
Bảng mô tả cần cho biết số quan sát hợp lệ, trung bình, độ lệch chuẩn, giá trị nhỏ nhất và lớn nhất. Hình phân phối giúp thấy giá trị bất thường hoặc cấu trúc mà một con số tóm tắt không biểu diễn.
Không nên dùng hình như một phép kiểm định tự động. Hãy đọc hình cùng với thiết kế đo lường và mục tiêu mô hình.
describe_one <- function(x) {
  c(
    n = sum(!is.na(x)),
    mean = mean(x, na.rm = TRUE),
    sd = sd(x, na.rm = TRUE),
    min = min(x, na.rm = TRUE),
    max = max(x, na.rm = TRUE)
  )
}

descriptives <- sapply(
  analysis[c("satisfaction_mean", "trust_mean", "outcome")],
  describe_one
)

write.csv(
  descriptives,
  "output/tables/descriptives.csv"
)

png("output/figures/outcome_histogram.png",
    width = 1600, height = 900, res = 150)
hist(analysis$outcome,
     main = "Distribution of outcome",
     xlab = "Outcome")
dev.off()
8. Ước lượng mô hình, khoảng tin cậy và chẩn đoán
Mô hình hồi quy minh họa dưới đây dùng outcome liên tục. Đây không phải lựa chọn mặc định cho mọi dữ liệu. Công thức, biến kiểm soát và cách xử lý missing phải khớp với câu hỏi nghiên cứu.
summary cung cấp ước lượng và sai số chuẩn theo giả định của mô hình. confint bổ sung khoảng tin cậy. Các hình chẩn đoán giúp rà dạng hàm, phần dư và điểm ảnh hưởng, nhưng kết luận cần dựa trên nhiều bằng chứng.
fit <- lm(
  outcome ~ satisfaction_mean + trust_mean + age,
  data = analysis
)

summary(fit)
confint(fit, level = 0.95)

png("output/figures/model_diagnostics.png",
    width = 1600, height = 1600, res = 150)
par(mfrow = c(2, 2))
plot(fit)
dev.off()

model_table <- cbind(
  estimate = coef(fit),
  confint(fit, level = 0.95)
)

write.csv(
  model_table,
  "output/tables/model_coefficients.csv"
)
9. Ghi lại môi trường và chạy lại toàn bộ
Phiên bản R và package là một phần của phương pháp. sessionInfo ghi hệ điều hành, phiên bản R và các package đã nạp; manual chính thức là điểm đối chiếu cho hành vi của hàm base R (R Core Team, n.d.). Nếu dự án dùng nhiều package, lockfile giúp mô tả phiên bản phụ thuộc.
Thực hành tái lập còn cần kiểm tra bằng một phiên sạch. Wilson và cộng sự (2017) khuyến nghị tự động hóa các bước lặp và ghi rõ phụ thuộc của phân tích.
write.csv(
  analysis,
  "data/derived/survey_analysis.csv",
  row.names = FALSE,
  na = ""
)

capture.output(
  sessionInfo(),
  file = "output/session-info.txt"
)

# Kiểm tra cuối:
# 1. Khởi động lại R
# 2. Mở project
# 3. Chạy lần lượt các script trong README
# 4. So sánh bảng và hình được tạo lại
10. Mẫu báo cáo và bảng kiểm bàn giao
Mẫu báo cáo tiếng Việt
Phân tích được thực hiện trong R [phiên bản] bằng các package [tên và phiên bản]. Dữ liệu gốc được giữ bất biến; dữ liệu phân tích được tạo bằng các script [tên]. Mã thiếu [mô tả] được chuyển thành NA trước khi tạo điểm. Mô hình [tên] được ước lượng trên [N] trường hợp. Hệ số của [X] là b = [ ], SE = [ ], 95% CI [ , ], p = [ ]. Mã lệnh, session information và đầu ra được lưu cùng phiên bản phân tích.
- Script chạy được từ một phiên R sạch.
- Không có đường dẫn tuyệt đối tới máy cá nhân.
- Dữ liệu gốc không bị ghi đè.
- Kiểu biến, phạm vi, ID và missing được kiểm tra bằng code.
- Quy tắc tạo điểm được ghi rõ.
- Bảng và hình được sinh từ object phân tích.
- Seed được đặt khi có bước ngẫu nhiên.
- sessionInfo và phiên bản package được lưu.
- Dữ liệu nhạy cảm và thông tin đăng nhập không nằm trong kho mã.
Kết luận
R phát huy giá trị khi mỗi kết quả là sản phẩm của một chuỗi lệnh có thể đọc và chạy lại. Một project gọn, dữ liệu gốc bất biến và đầu ra sinh tự động giúp người phân tích tìm lỗi sớm hơn và bàn giao công việc rõ hơn.
Tài liệu tham khảo
- Posit Software, PBC. (n.d.-a). RStudio projects. https://docs.posit.co/ide/user/ide/guide/code/projects.html
- Posit Software, PBC. (n.d.-b). RStudio IDE user guide. https://docs.posit.co/ide/user/index.html
- R Core Team. (n.d.). R manuals. https://cran.r-project.org/manuals.html
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), e1005510. https://doi.org/10.1371/journal.pcbi.1005510
Ghi chú học thuật: Mã lệnh minh họa dùng base R để giảm phụ thuộc. Với dự án thật, hãy ghi phiên bản các package bổ sung và kiểm tra manual của hàm đang dùng. Dữ liệu và kết quả trong ví dụ là giả lập.