
Thống kê mô tả bằng JASP: kiểm tra dữ liệu, chọn chỉ số và viết kết quả
Bảng trung bình và độ lệch chuẩn chưa phải là thống kê mô tả đầy đủ. Người phân tích phải xác nhận kiểu biến, dữ liệu thiếu, hình dạng phân phối và các trường hợp bất thường trước khi chọn con số để báo cáo.
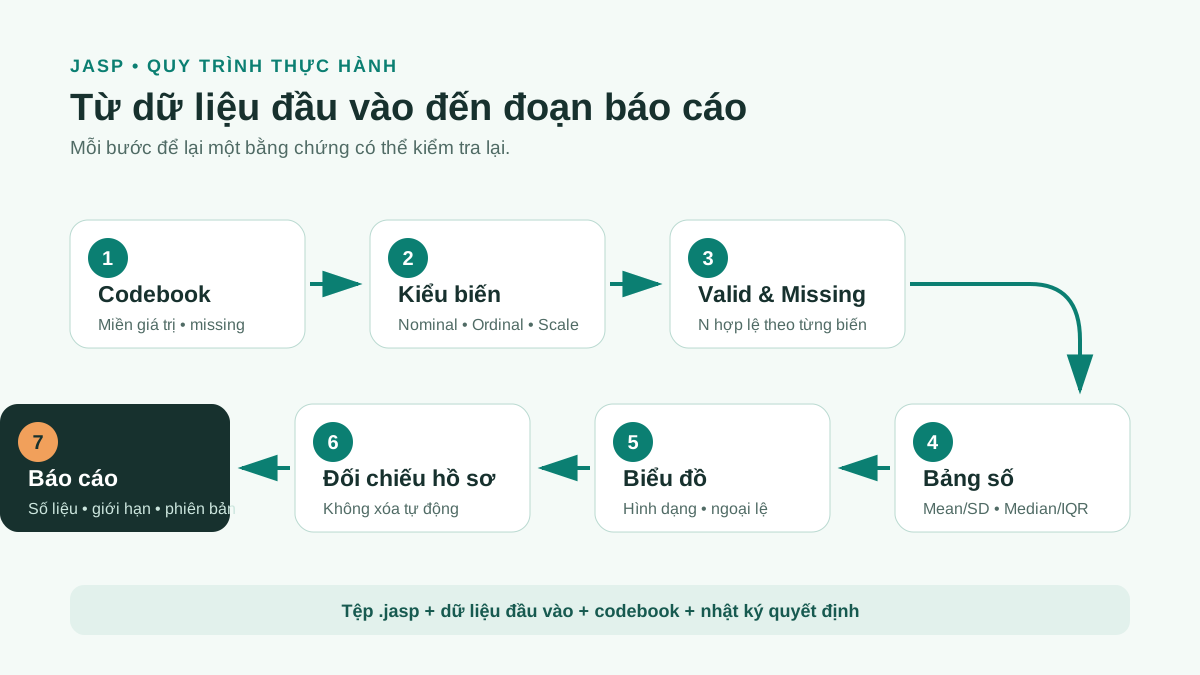
Quy trình thực hành bắt đầu bằng một codebook và bản dữ liệu đóng băng, tiếp tục với khai báo nominal, ordinal hoặc scale trong JASP, rồi đối chiếu số liệu tóm tắt với biểu đồ. Mỗi quyết định xử lý phải được ghi lại và tệp .jasp cần lưu cùng phiên bản phần mềm.
1. Mục tiêu phân tích và đầu vào cần chuẩn bị
Thống kê mô tả trả lời ba câu hỏi: mẫu phân tích gồm những ai, từng biến phân bố như thế nào và dữ liệu có vấn đề gì cần xử lý trước khi suy luận. Đây là bước kiểm tra dữ liệu, không phải thủ tục tạo một bảng mở đầu.
Trước khi mở JASP, cần có tệp dữ liệu gốc, codebook và quy tắc mã hóa missing. Mỗi dòng biểu diễn đúng một đơn vị quan sát theo thiết kế; mỗi cột có tên duy nhất, nhãn rõ và miền giá trị dự kiến. Giữ một bản dữ liệu gốc không chỉnh sửa để mọi thay đổi sau đó có thể đối chiếu.
JASP cập nhật kết quả khi người dùng thay đổi tùy chọn và lưu dữ liệu cùng phân tích trong tệp .jasp. Khả năng này giúp kiểm tra lại lựa chọn, nhưng không thay thế nhật ký làm sạch dữ liệu hoặc codebook (Love và cộng sự, 2019).
- Có codebook khớp với bảng hỏi hoặc nguồn dữ liệu.
- Biết đơn vị quan sát và biến định danh.
- Đã quy định mã nào là giá trị hợp lệ và mã nào là missing.
- Giữ bản dữ liệu gốc bất biến.
- Biết biến nào sẽ được mô tả cho toàn mẫu và theo nhóm.
2. Khai báo đúng nominal, ordinal và scale
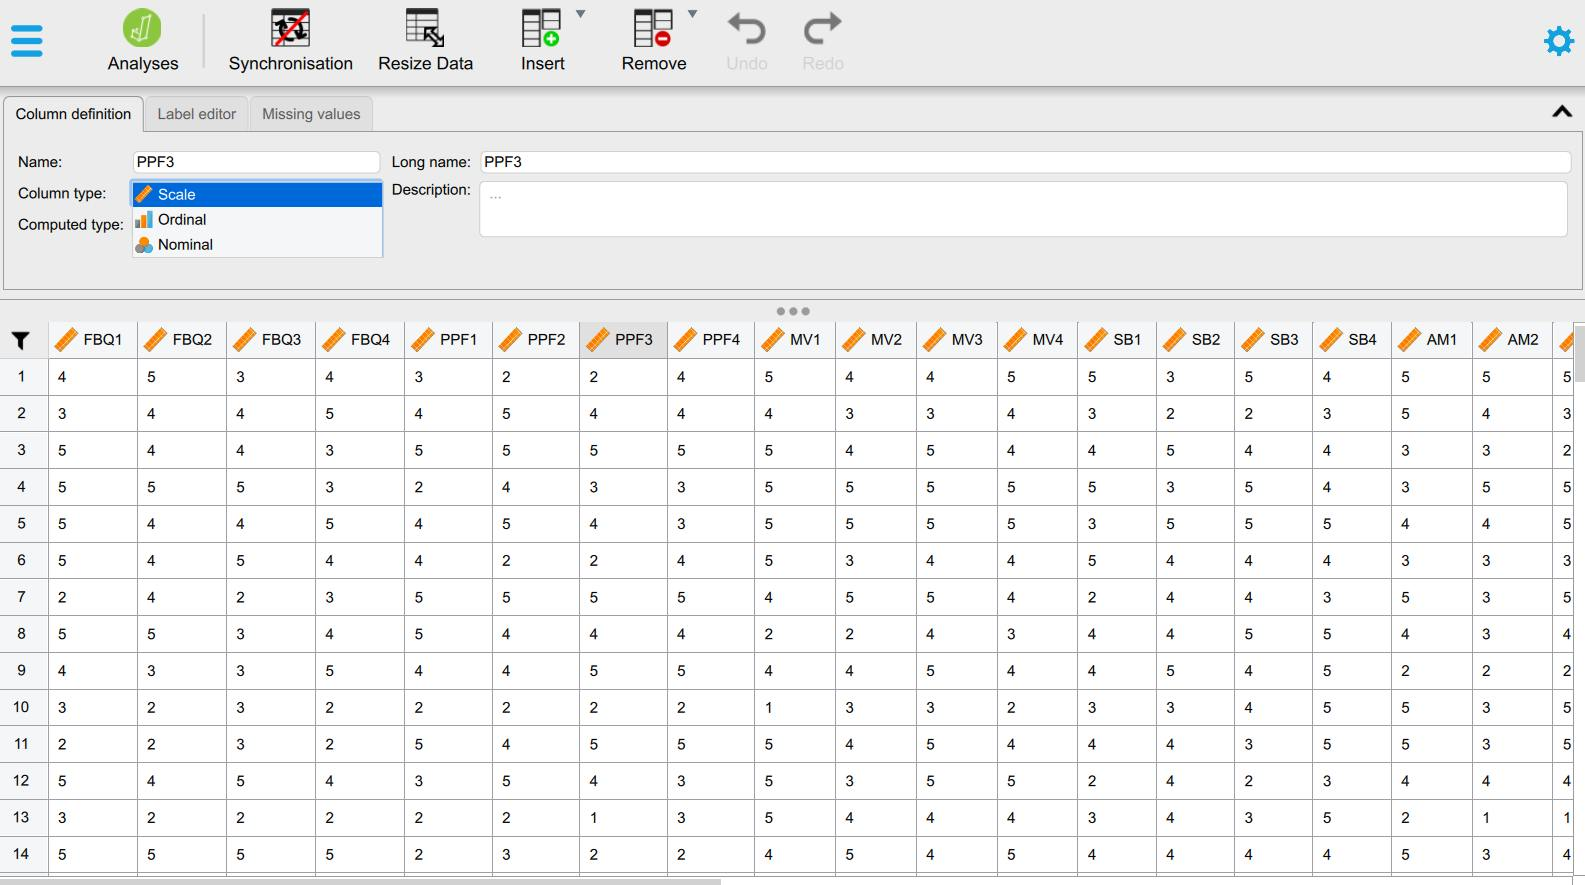
JASP phải biết vai trò đo lường của từng cột. Nominal biểu diễn các nhóm không có thứ tự, ordinal có thứ tự nhưng khoảng cách giữa các mức chưa được bảo đảm, còn scale dành cho biến số được phân tích như liên tục. Mã 1, 2 và 3 không làm một biến phân loại trở thành biến liên tục.
Biến Likert đơn lẻ về bản chất là ordinal. Điểm tổng hoặc điểm trung bình từ nhiều item đôi khi được xử lý như scale, nhưng quyết định đó cần dựa trên thiết kế thang đo, số mức, phân phối và mô hình phân tích. Không đổi kiểu biến chỉ để mở được một tùy chọn trong phần mềm.
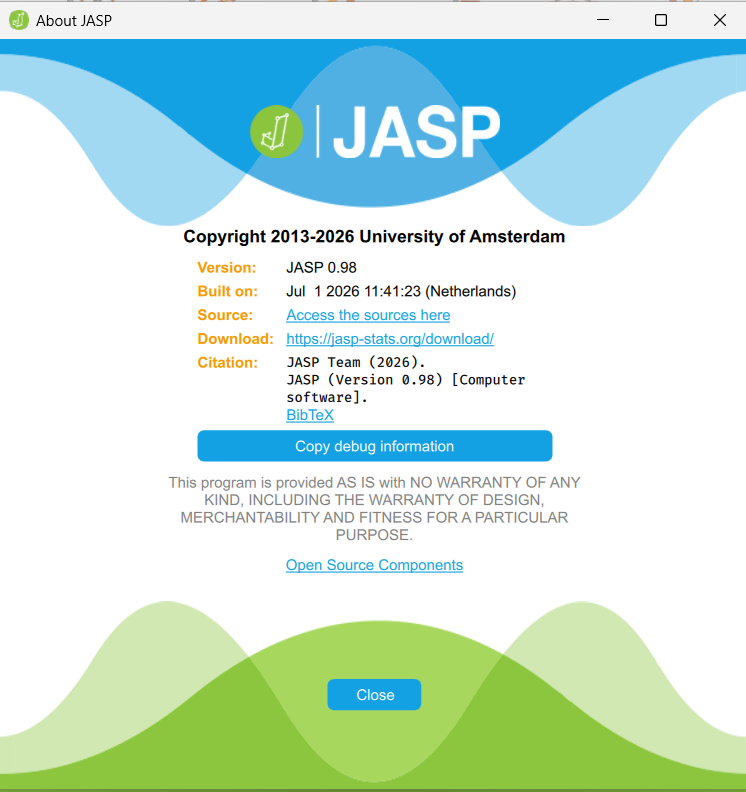
Ở JASP 0.98, biểu tượng kiểu biến nằm cạnh tên cột. Giao diện có thể thay đổi theo phiên bản, vì vậy cần ghi phiên bản phần mềm và kiểm tra lại release notes khi ảnh chụp không giống màn hình đang dùng (JASP Team, 2026).
| Ví dụ | Kiểu trong JASP | Mô tả chính | Lỗi cần tránh |
|---|---|---|---|
| Giới tính, khu vực | Nominal | n và % | Tính mean của mã nhóm |
| Mức học vấn có thứ tự | Ordinal | n, %, median và quantiles khi phù hợp | Giả định khoảng cách bằng nhau |
| Tuổi theo năm | Scale | Mean, SD hoặc median, IQR | Bỏ qua giá trị ngoài miền |
| Item Likert 1 đến 5 | Ordinal | Phân bố từng mức, median hoặc tóm tắt có căn cứ | Gọi item là liên tục theo thói quen |
| Điểm trung bình nhiều item | Scale nếu có lý giải | Mean, SD, median, IQR và hình | Quên quy tắc tính điểm khi thiếu item |
3. Nhập dữ liệu và đối chiếu trước khi phân tích
Mở tệp CSV, Excel, SPSS hoặc định dạng được JASP hỗ trợ, sau đó đối chiếu số dòng, số cột và vài trường hợp đầu với nguồn. Với CSV, kiểm tra dấu phân cách, dấu thập phân và encoding. Một cột số bị đọc thành text thường báo hiệu ký tự lạ, dấu phẩy thập phân không thống nhất hoặc mã missing chưa được xử lý.
Không chỉnh hàng loạt trong bảng dữ liệu mà không lưu dấu vết. Nếu phải sửa ở JASP, ghi biến, giá trị cũ, giá trị mới, lý do và ngày sửa vào nhật ký. Với dự án lớn, nên làm sạch bằng syntax hoặc công cụ có lịch sử thao tác rồi nhập lại bản dữ liệu dẫn xuất.
Tệp .jasp không nên là bản duy nhất của dữ liệu. Lưu riêng dữ liệu đầu vào, codebook và tệp phân tích. Goss-Sampson (2022) trình bày quy trình JASP theo hướng giữ dữ liệu, lựa chọn và output trong cùng một phiên phân tích, nhưng người dùng vẫn phải quản lý phiên bản tệp bên ngoài phần mềm.
Mở bản sao dữ liệu
Không phân tích trực tiếp trên tệp raw duy nhất.
Đối chiếu kích thước
Ghi số dòng, số cột và số ID duy nhất mong đợi.
Kiểm tra kiểu cột
Xác nhận nominal, ordinal hoặc scale theo codebook.
Kiểm tra mã missing
Bảo đảm 99, 999 hoặc chuỗi NA không bị xem là giá trị thật.
Lưu tệp phân tích
Dùng tên có ngày hoặc phiên bản, chẳng hạn survey_descriptives_v01.jasp.
4. Thao tác trong Descriptives theo một thứ tự có kiểm soát
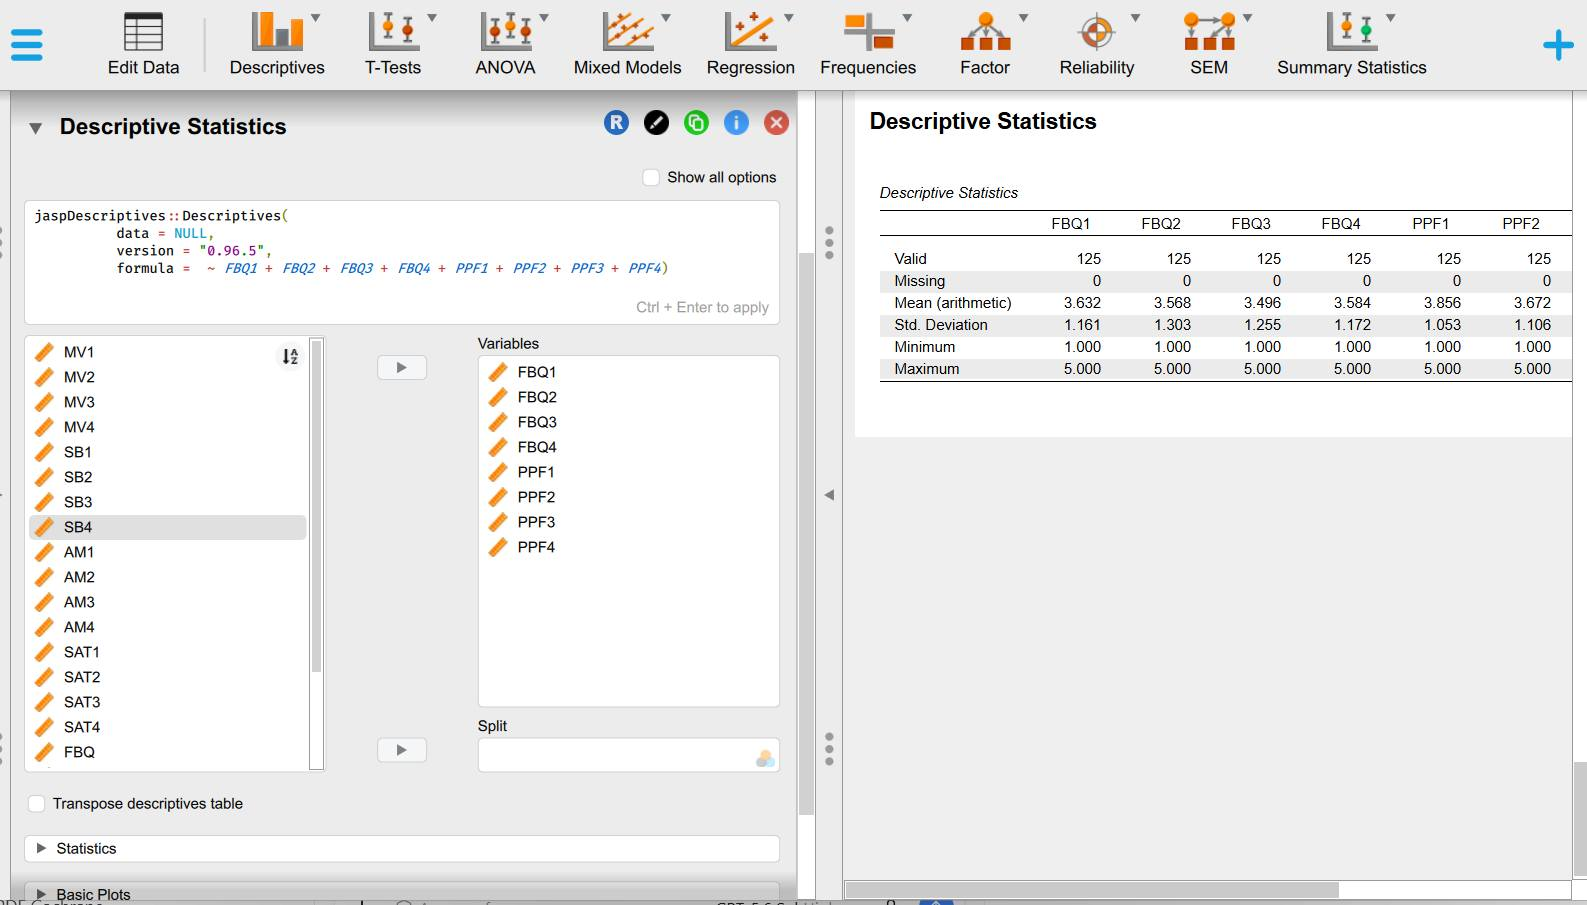
Vào Descriptives, chuyển các biến cần kiểm tra sang ô Variables và đưa biến nhóm vào Split khi cần. Chọn Valid, Missing, Mean, Median, Standard deviation, IQR, Minimum, Maximum và các quantiles phù hợp. Không cần đánh dấu mọi tùy chọn vì một bảng dày số sẽ che mất vấn đề chính.
Hãy chạy toàn mẫu trước, sau đó mới tách theo nhóm. Nếu một nhóm có rất ít quan sát, số mô tả dao động mạnh và biểu đồ có thể gây ấn tượng sai. Báo số quan sát hợp lệ cho từng biến vì missing làm cỡ mẫu thay đổi giữa các cột.
Phần Features và tài liệu học tập chính thức cho thấy JASP hỗ trợ descriptive statistics, distribution plots và nhiều dạng biểu đồ. Tên tùy chọn có thể được cập nhật giữa các phiên bản (JASP, n.d.-a; Goss-Sampson, 2022).
Phiên minh họa đưa tám biến FBQ1 đến FBQ4 và PPF1 đến PPF4 vào cùng một bảng để kiểm tra nhất quán. Các cột đang hiển thị có 125 quan sát hợp lệ và không có missing; mean dao động từ 3,496 đến 3,856, còn độ lệch chuẩn dao động từ 1,053 đến 1,303. Sau bước đối chiếu này, người đọc tiếp tục chọn median, IQR, quartiles và biểu đồ phân phối theo đúng mục tiêu mô tả. Các con số chỉ minh họa quy trình đọc output, không phải ngưỡng tham khảo cho nghiên cứu khác.
Chọn biến
Đưa một nhóm biến cùng loại vào Variables để bảng dễ đọc.
Chọn số đếm
Luôn lấy Valid và Missing trước các chỉ số trung tâm.
Chọn trung tâm và phân tán
Kết hợp mean với SD; median với IQR hoặc quantiles.
Chọn giới hạn
Dùng minimum và maximum để phát hiện mã ngoài miền.
Thêm biểu đồ
Dùng histogram, density, boxplot, violin hoặc Q-Q plot theo mục tiêu.
Tách nhóm khi cần
Đưa biến phân nhóm vào Split và kiểm tra N của từng nhóm.
5. Chọn chỉ số theo kiểu biến và hình dạng phân phối
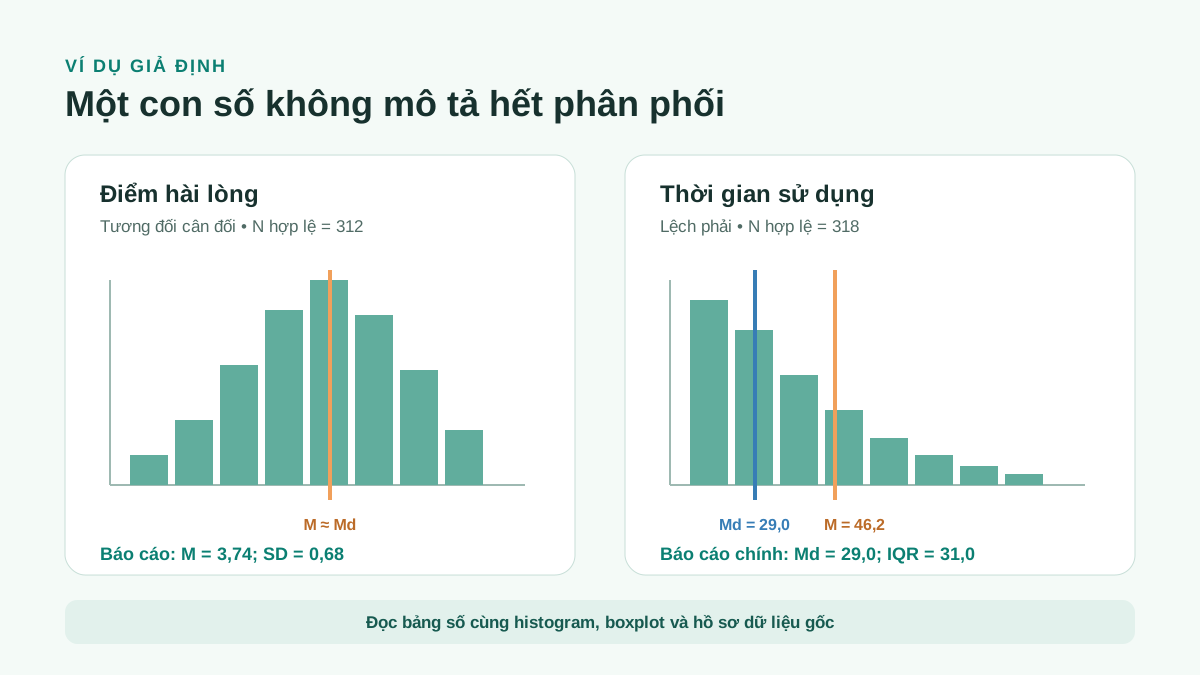
Mean và SD phù hợp khi biến được xử lý như scale và phân phối không bị một số giá trị cực đoan chi phối. Median và IQR mô tả vị trí cùng độ phân tán bền vững hơn khi phân phối lệch. Với biến nominal, số lượng và tỷ lệ phần trăm mới là đầu ra chính.
Không có một ngưỡng skewness hoặc kurtosis áp dụng cho mọi cỡ mẫu và mọi mô hình. Hãy đọc số mô tả cùng histogram, boxplot, Q-Q plot và yêu cầu của phân tích tiếp theo. NIST/SEMATECH (2012) xem biểu đồ là phần trung tâm của exploratory data analysis vì chúng bộc lộ vị trí, độ phân tán, lệch, ngoại lệ và nhiều mode mà một con số riêng lẻ không thể hiện đầy đủ.
Shapiro-Wilk kiểm định giả thuyết chuẩn của phân phối, nhưng p-value phụ thuộc cỡ mẫu. Với mẫu lớn, sai lệch nhỏ cũng có thể bị phát hiện; với mẫu nhỏ, kiểm định có thể thiếu lực. Không dùng một p-value duy nhất để quyết định xóa dữ liệu hoặc đổi estimator (Ghasemi & Zahediasl, 2012).
| Tình huống | Báo cáo chính | Bổ sung | Không nên làm |
|---|---|---|---|
| Nominal | n và % | Missing | Mean của mã nhóm |
| Ordinal ít mức | n, %, median | IQR hoặc quantiles | Chỉ báo mean mà không có phân bố mức |
| Scale gần đối xứng | Mean và SD | Min, max, CI hoặc histogram | Kết luận chuẩn chỉ từ mean gần median |
| Scale lệch | Median và IQR | Quantiles, histogram, violin | Xóa đuôi phân phối để mean đẹp |
| Scale có ngoại lệ | Cả bộ chỉ số bền vững và thông thường | Boxplot và kiểm tra hồ sơ | Xóa theo nhãn outlier tự động |
6. Mô tả dữ liệu thiếu trước khi quyết định xử lý
Báo số missing và tỷ lệ missing của từng biến. Tổng số trường hợp trong tệp không phải lúc nào cũng là N dùng để tính mean hoặc correlation. Khi missing khác nhau giữa các biến, bảng mô tả phải cho người đọc thấy N hợp lệ tương ứng.
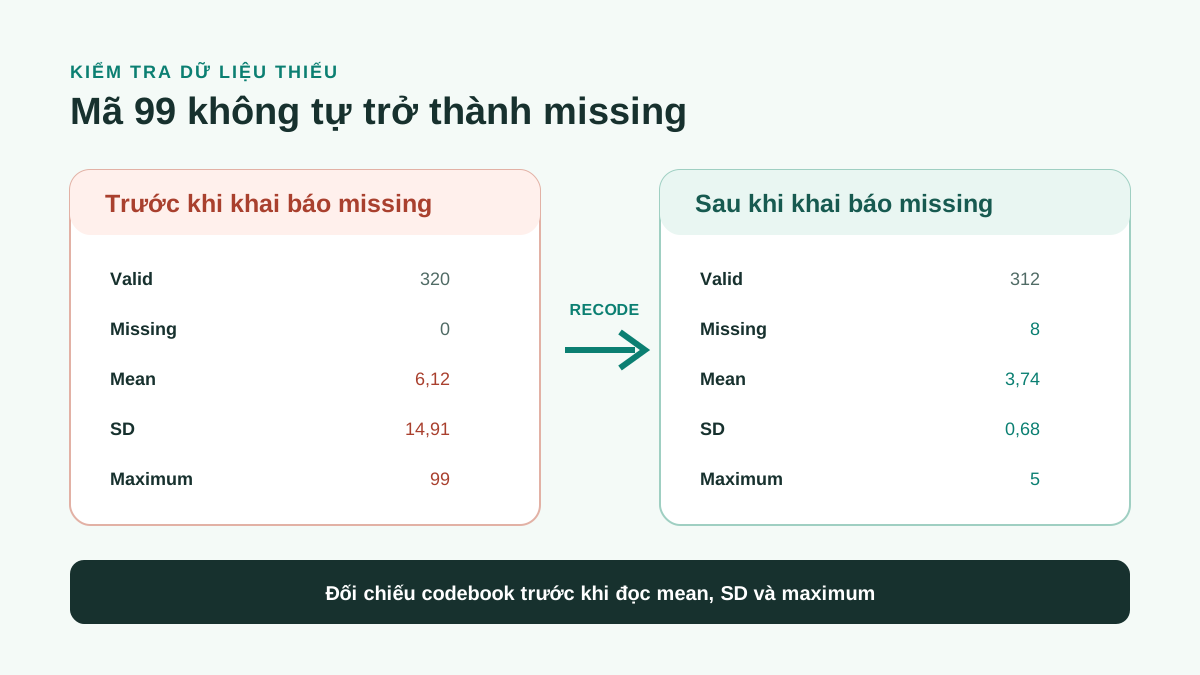
Một mã 99 chưa khai báo sẽ làm mean, SD và maximum sai. Kiểm tra maximum, bảng tần số và codebook trước khi xem phân phối. Sau khi đổi mã missing, chạy lại toàn bộ Descriptives và lưu tệp mới.
Thống kê mô tả chưa xác định cơ chế MCAR, MAR hay MNAR. Mẫu missing theo nhóm, theo thời điểm hoặc theo biến kết quả cần được điều tra riêng. Không thay missing bằng mean chỉ vì JASP cho phép tạo computed column.
Mức giữa của thang Likert là một phản hồi hợp lệ nếu bảng hỏi định nghĩa như vậy. Không trả lời là thiếu dữ liệu. Hai trạng thái này phải có mã khác nhau.
7. Dùng boxplot để tìm trường hợp cần kiểm tra, không để ra lệnh xóa
Boxplot thường đánh dấu các điểm nằm ngoài hàng rào dựa trên 1,5 lần IQR. Đây là quy tắc nhận diện để kiểm tra, không phải bằng chứng quan sát sai. Một giá trị có thể hợp lệ trong phân phối lệch hoặc thuộc nhóm con có thật (NIST/SEMATECH, 2012).
Truy về ID và hồ sơ gốc. Phân loại trường hợp thành lỗi nhập liệu, sai đơn vị, không phù hợp tiêu chí mẫu, quan sát hợp lệ nhưng hiếm hoặc chưa xác định. Chỉ sửa hoặc loại theo quy tắc có căn cứ; giữ nhật ký để người khác biết vì sao N thay đổi.
Nếu ngoại lệ hợp lệ ảnh hưởng mạnh tới kết quả, báo phân tích độ nhạy bằng đặc tả phù hợp. Không âm thầm loại trường hợp rồi chỉ trình bày mô hình thuận lợi.
| ID | Biến | Giá trị | Nguồn kiểm tra | Phân loại | Quyết định |
|---|---|---|---|---|---|
| A104 | Tuổi | 222 | Phiếu gốc ghi 22 | Lỗi nhập | Sửa bằng quy tắc có ghi nhận |
| B087 | Thu nhập | 350 | Đúng đơn vị triệu đồng/năm | Hợp lệ nhưng cao | Giữ và chạy độ nhạy |
| C015 | Thang 1 đến 5 | 9 | Không tìm được phiếu | Ngoài miền, chưa xác định | Đặt missing và ghi giới hạn |
8. Ví dụ giả định: mô tả điểm hài lòng và thời gian sử dụng
Ví dụ này dùng số liệu giả định để minh họa cách đọc, không phải kết quả nghiên cứu thật. Tệp có 320 người trả lời. Điểm hài lòng là trung bình của bốn item Likert, còn thời gian sử dụng được tính theo phút.
Hài lòng có N hợp lệ = 312, mean = 3,74, SD = 0,68, median = 3,75 và IQR = 1,00. Histogram tương đối cân đối, không có khoảng trống bất thường. Có thể báo mean và SD, đồng thời nêu tám trường hợp thiếu.
Thời gian sử dụng có N hợp lệ = 318, mean = 46,2 phút, SD = 51,8, median = 29,0 và IQR = 31,0. Histogram lệch phải, còn boxplot đánh dấu sáu trường hợp cao. Sau khi đối chiếu, năm trường hợp là hợp lệ và một trường hợp 1.440 phút do sai đơn vị. Median và IQR là tóm tắt chính trước khi sửa; dữ liệu sau chỉnh phải được mô tả lại.
Sự chênh lệch giữa mean và median không tự chứng minh sai dữ liệu. Nó là tín hiệu cần xem hình và hồ sơ. Wilkinson và Task Force on Statistical Inference (1999) khuyến nghị kiểm tra dữ liệu, đồ thị và các giả định thay vì phụ thuộc vào một thủ tục máy móc.
| Biến | N hợp lệ | Missing | Mean | SD | Median | IQR |
|---|---|---|---|---|---|---|
| Hài lòng | 312 | 8 | 3,74 | 0,68 | 3,75 | 1,00 |
| Thời gian sử dụng | 318 | 2 | 46,2 | 51,8 | 29,0 | 31,0 |
9. Mô tả theo nhóm mà không biến bảng thành kiểm định
Split cho phép xem bảng và hình theo giới tính, nhóm can thiệp, khu vực hoặc thời điểm. Trước hết kiểm tra N từng nhóm. Một nhóm nhỏ có thể tạo SD không ổn định và boxplot thưa điểm.
Chênh lệch mean mô tả trong mẫu chưa phải bằng chứng về khác biệt tổng thể. Nếu câu hỏi nghiên cứu yêu cầu suy luận, cần dùng mô hình phù hợp, báo effect size và khoảng tin cậy. Thống kê mô tả giúp hiểu dữ liệu trước khi chọn mô hình, không thay thế mô hình.
Nếu cùng một thang đo được so giữa nhóm, vấn đề tương đương đo lường có thể quan trọng. Một mean thấp hơn chưa chắc phản ánh mức construct thấp hơn nếu item hoạt động khác giữa các nhóm.
Bảng theo nhóm cho biết dữ liệu quan sát trong mẫu. Kết luận về quần thể cần một thiết kế lấy mẫu và mô hình suy luận phù hợp.
10. Xuất bảng, lưu tệp và tạo hồ sơ tái lập
Lưu tệp .jasp sau khi chốt dữ liệu và tùy chọn. Đặt tên có phiên bản, ghi phiên bản JASP và ngày chạy trong README hoặc nhật ký. JASP Team (2026) hướng dẫn trích dẫn phần mềm bằng tên nhóm phát triển, năm, phiên bản và loại phần mềm.
Có thể sao chép bảng hoặc hình sang Word, nhưng bảng trong bản thảo phải truy được về đúng tệp .jasp. Khi dữ liệu thay đổi, mở lại tệp, refresh phân tích và thay toàn bộ đầu ra liên quan thay vì sửa số thủ công.
Ảnh chụp màn hình dùng cho hướng dẫn cần che dữ liệu nhận diện, giữ độ phân giải đủ đọc và ghi phiên bản phần mềm. Ảnh minh họa không thay thế bảng số có thể sao chép hoặc nội dung thay thế cho người dùng trình đọc màn hình.
- Tên tệp dữ liệu và .jasp có phiên bản.
- Phiên bản JASP được ghi trong phương pháp hoặc README.
- Bảng và hình trong bản thảo truy được về tệp phân tích.
- Ảnh chụp không chứa dữ liệu cá nhân.
- Các quyết định sửa, loại hoặc recode có nhật ký.
11. Mẫu báo cáo APA 7 và bảng kiểm trước khi chuyển sang suy luận
Mẫu dưới đây dùng số giả định ở phần thực hành. Hãy thay bằng biến, N, số missing, chỉ số và lý do lựa chọn thật của nghiên cứu.
Mẫu báo cáo tiếng Việt
Dữ liệu được kiểm tra bằng JASP 0.98 (JASP Team, 2026). Điểm hài lòng có 312 quan sát hợp lệ và tám giá trị thiếu, với M = 3,74 và SD = 0,68. Histogram cho thấy phân phối tương đối cân đối. Thời gian sử dụng lệch phải nên được mô tả bằng Md = 29,0 phút và IQR = 31,0 phút. Sáu trường hợp được boxplot đánh dấu đã được đối chiếu với dữ liệu gốc; năm trường hợp hợp lệ được giữ lại, còn một lỗi đơn vị được sửa theo nhật ký dữ liệu. Số liệu trong đoạn này chỉ dùng để minh họa cách viết.
- Kiểu biến khớp codebook.
- N hợp lệ và missing được báo cho từng biến.
- Mean đi cùng SD; median đi cùng IQR hoặc quantiles.
- Bảng số được đọc cùng biểu đồ.
- Outlier được truy về hồ sơ, không xóa tự động.
- Nhóm có N nhỏ được nhận diện.
- Tệp .jasp, dữ liệu đầu vào và nhật ký được lưu cùng phiên bản.
- Phần mềm được trích dẫn đúng phiên bản.
Kết luận
Thống kê mô tả bằng JASP cần tạo ra một hồ sơ dữ liệu có thể kiểm tra: kiểu biến đúng, N hợp lệ rõ, missing được nhận diện, số tóm tắt phù hợp với phân phối và mọi trường hợp bất thường đều có quyết định được ghi lại.
Chỉ sau bước này mới nên chuyển sang kiểm định, hồi quy, phân tích nhân tố hoặc SEM. Nếu dữ liệu đầu vào còn sai kiểu hoặc sai mã, một mô hình phức tạp chỉ làm lỗi khó nhìn hơn.
Tài liệu tham khảo
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486-489. https://doi.org/10.5812/ijem.3505
- Goss-Sampson, M. A. (2025). Statistical analysis in JASP: A guide for students (7th ed., Version 0.19.3). https://jasp-stats.org/wp-content/uploads/2025/07/Statistical-Analysis-in-JASP-A-guide-for-students-2025.pdf
- JASP. (n.d.-a). Features. https://jasp-stats.org/features/
- JASP Team. (2026). JASP (Version 0.98) [Computer software]. https://jasp-stats.org/
- Love, J., Selker, R., Marsman, M., Jamil, T., Dropmann, D., Verhagen, J., Ly, A., Gronau, Q. F., Smíra, M., Epskamp, S., Matzke, D., Wild, A., Knight, P., Rouder, J. N., Morey, R. D., & Wagenmakers, E.-J. (2019). JASP: Graphical statistical software for common statistical designs. Journal of Statistical Software, 88(2), 1-17. https://doi.org/10.18637/jss.v088.i02
- NIST/SEMATECH. (2012). e-Handbook of statistical methods: Exploratory data analysis. https://www.itl.nist.gov/div898/handbook/eda/eda.htm
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594-604. https://doi.org/10.1037/0003-066X.54.8.594
Ghi chú học thuật: Các số liệu trong ví dụ là giả định. Giao diện và tên tùy chọn được kiểm tra theo JASP 0.98; người đọc dùng phiên bản khác cần đối chiếu release notes.