
Chọn CB-SEM, PLS-SEM hay PLSc theo mục tiêu nghiên cứu
Tên phần mềm không quyết định phương pháp. Lựa chọn hợp lý bắt đầu từ bản chất của cấu trúc, đại lượng cần ước lượng, đặc điểm dữ liệu và bằng chứng mà nghiên cứu muốn tạo ra.
CB-SEM thường phù hợp khi mô hình nhắm đến common factors, tham số và cấu trúc hiệp phương sai. PLS-SEM tạo điểm composite và hữu ích cho mục tiêu giải thích hoặc dự báo. PLSc hiệu chỉnh PLS Mode A khi cấu trúc được đặc tả như common factor. Cỡ mẫu nhỏ hoặc dữ liệu lệch không tự động quyết định PLS-SEM.
1. Bắt đầu từ cấu trúc, không bắt đầu từ phần mềm
Một common factor được giả định là nguyên nhân chung tạo ra tương quan giữa các chỉ báo. Chỉ báo là biểu hiện chưa hoàn hảo của biến tiềm ẩn, vì vậy mô hình phải xử lý sai số đo lường và tái tạo cấu trúc hiệp phương sai. CFA và phần lớn ứng dụng CB-SEM bắt đầu từ logic này.
Composite được tạo từ một tổ hợp các biến quan sát. Các thành phần xác định nội dung của composite, nên việc bỏ một thành phần có thể thay đổi khái niệm. Causal-formative model cũng đặt mũi tên từ chỉ báo vào cấu trúc, nhưng causal indicators không đồng nghĩa với composite indicators. Bollen và Bauldry (2011) chỉ ra rằng ba loại biến này cần được phân biệt khi đặc tả mô hình đo lường.
Composite có thể được mô hình hóa trong nhiều khuôn khổ SEM. Grace và Bollen (2008) đã trình bày vai trò của composite trong SEM, còn các phát triển gần đây cho thấy CB-SEM và PLSc đều có thể xử lý những mô hình kết hợp common factors với composites trong điều kiện đặc tả phù hợp (Henseler & Schuberth, 2025).
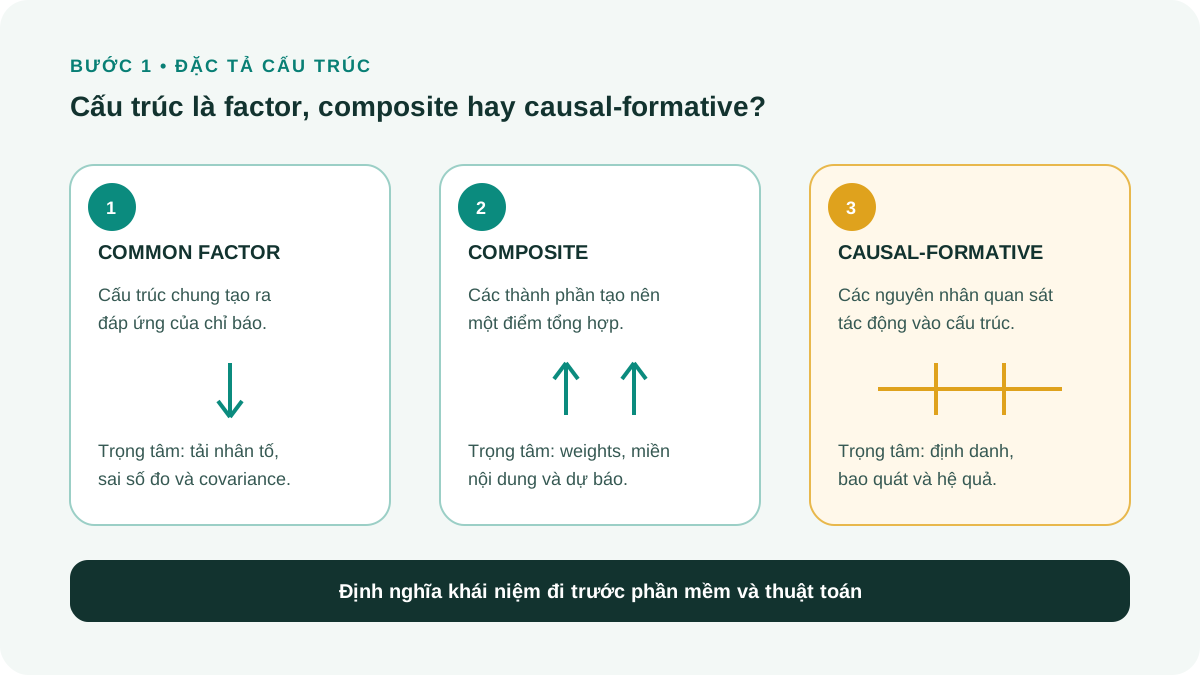
| Loại cấu trúc | Quan hệ với chỉ báo | Câu hỏi cần trả lời |
|---|---|---|
| Common factor | Cấu trúc chung tạo ra đáp ứng chỉ báo | Các chỉ báo có phản ánh cùng một biến tiềm ẩn không? |
| Composite | Các thành phần tạo nên điểm tổng hợp | Tổ hợp nào đại diện cho khái niệm được định nghĩa? |
| Causal-formative | Các nguyên nhân quan sát tác động vào cấu trúc | Các nguyên nhân có đủ miền nội dung và được định danh đúng không? |
2. CB-SEM, PLS-SEM và PLSc đang ước lượng điều gì?
CB-SEM thường ước lượng tham số của common-factor model sao cho ma trận hiệp phương sai do mô hình suy ra gần với ma trận quan sát. Người nghiên cứu có thể kiểm định ràng buộc, so sánh mô hình và đánh giá mức sai khác tổng thể. Kết luận vẫn phụ thuộc estimator, cỡ mẫu, phân phối, định danh và chất lượng đặc tả.
PLS-SEM tạo điểm composite bằng các trọng số rồi ước lượng quan hệ giữa các composite. Cách tiếp cận này phù hợp khi composite đúng với lý thuyết hoặc khi mục tiêu đặt trọng tâm vào giải thích và dự báo các biến đích. PLS-SEM không tự động biến một thang đo nhân tố thành composite hợp lệ (Rigdon, 2016; Hair & Alamer, 2022).
PLSc áp dụng hiệu chỉnh suy giảm cho các cấu trúc Mode A được đặc tả như common factors. Mục đích là làm cho ước lượng dựa trên PLS nhất quán hơn với common-factor model. PLSc không phải lựa chọn mặc định cho mọi mô hình và không được dùng để hiệu chỉnh một composite thành factor (Dijkstra & Henseler, 2015; SmartPLS, n.d.).
| Phương pháp | Đối tượng chính | Bằng chứng nên ưu tiên | Giới hạn cần ghi |
|---|---|---|---|
| CB-SEM | Common factors, covariance và tham số | Fit, tham số, CI, so sánh mô hình | Nhạy với đặc tả và estimator |
| PLS-SEM | Composite scores và quan hệ dự báo | Weights/loadings, R², f², PLSpredict, CVPAT | Không thay factor model nếu lý thuyết cần factor |
| PLSc | Common factors qua hiệu chỉnh PLS | Tải, đường dẫn, CI và kiểm tra độ bền | Chỉ hợp lý khi giả định common factor có căn cứ |
3. Năm lý do lựa chọn thường được viết sai
Quy tắc 10 lần không phải căn cứ đủ cho cỡ mẫu PLS-SEM. Kock và Hadaya (2018) cho thấy quy tắc này có thể cho ước lượng thiếu chính xác và đề xuất các phương pháp gắn với hệ số đường dẫn tối thiểu cần phát hiện. Với mô hình phức tạp hoặc mục tiêu kiểm định cụ thể, power analysis hoặc Monte Carlo thường giúp nêu rõ giả định hơn.
Dữ liệu Likert ít mức cũng không tạo ra một quyết định tự động. Khi mục tiêu là common-factor CFA hoặc SEM, estimator categorical như WLSMV có thể phù hợp hơn ML thường, nhất là với ít hơn năm mức và ngưỡng bất đối xứng. Hiệu năng còn phụ thuộc cỡ mẫu và phân phối tiềm ẩn (Rhemtulla và cộng sự, 2012).
| Lý do yếu | Vì sao chưa đủ | Cách biện minh tốt hơn |
|---|---|---|
| Dữ liệu lệch nên dùng PLS | CB-SEM có estimator robust và bootstrap | Nêu loại biến, mức lệch, estimator và mục tiêu |
| Mẫu nhỏ nên dùng PLS | Mọi estimator đều cần đủ thông tin và công suất | Dùng power hoặc mô phỏng theo hiệu ứng cần phát hiện |
| Có formative nên phải dùng PLS | CB-SEM có thể đặc tả composite hoặc causal indicators | Giải thích loại cấu trúc và điều kiện định danh |
| PLS không có giả định | PLS vẫn dựa vào đặc tả, dữ liệu và suy luận bootstrap | Báo cài đặt, collinearity, tính ổn định và dự báo |
| PLSc luôn tốt hơn PLS | Hiệu chỉnh chỉ nhằm common-factor model | Dùng PLSc khi cấu trúc phản ánh thật sự được xem là factor |
4. Cây quyết định thực hành
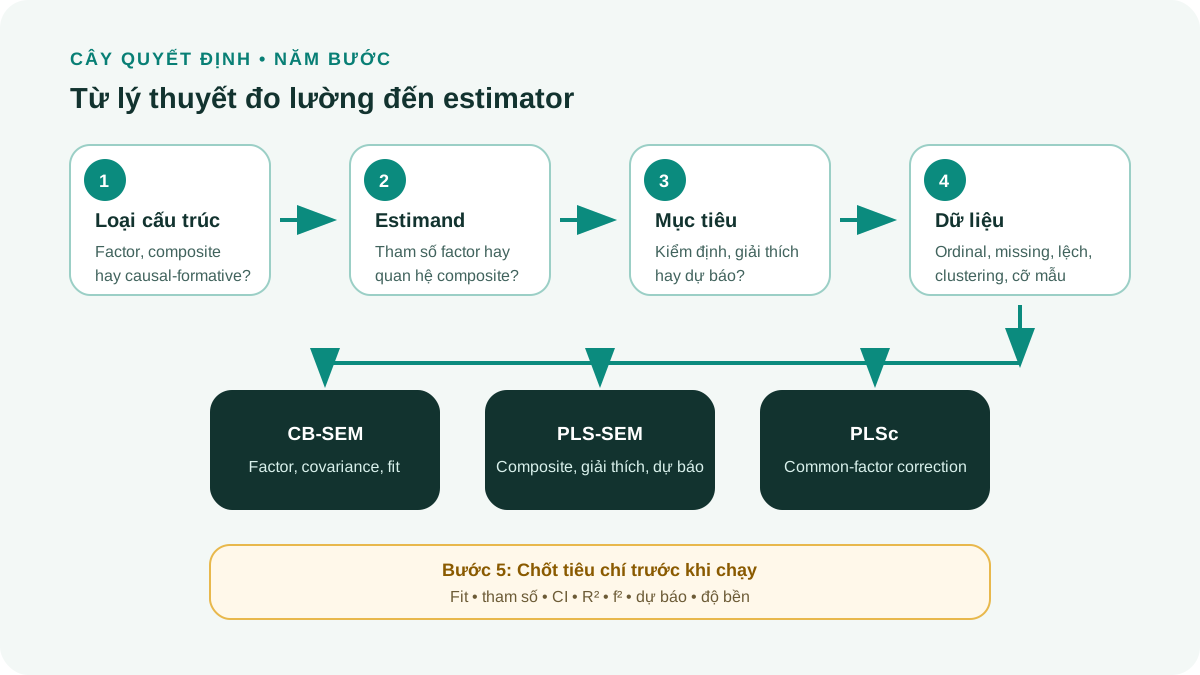
Định nghĩa từng cấu trúc
Viết định nghĩa khái niệm, chỉ rõ common factor, composite hoặc causal-formative. Nếu chưa rõ, dừng lựa chọn phần mềm và quay lại lý thuyết đo lường.
Chốt estimand
Xác định cần ước lượng quan hệ giữa factors, quan hệ giữa composites, tổng tác động hay năng lực dự báo của biến đích.
Chốt mục tiêu bằng chứng
Kiểm định covariance và ràng buộc thường nghiêng về CB-SEM; composite cùng dự báo nghiêng về PLS-SEM; common factor qua PLS có thể cân nhắc PLSc.
Chọn estimator theo dữ liệu
Xem ordinal, thiếu dữ liệu, lệch phân phối, clustering và cỡ mẫu. Chọn robust ML, WLSMV, bootstrap hoặc thủ tục phù hợp trong họ phương pháp đã chọn.
Đặt tiêu chí trước khi chạy
Ghi fit, tham số, CI, R², f², dự báo và kiểm tra độ bền sẽ dùng. Không thay tiêu chí sau khi thấy phương pháp nào cho kết quả thuận lợi hơn.
AMOS, SmartPLS, R, Mplus hoặc Stata là môi trường thực thi. Phần mềm không tự xác định cấu trúc là factor hay composite và không sửa một mô hình lý thuyết yếu.
5. Ba tình huống để áp dụng cây quyết định
Tình huống thực tế có thể chứa cả factors và composites. Khi đó, người nghiên cứu cần phần mềm và estimator xử lý được mô hình hỗn hợp, đồng thời phải ghi rõ cách từng cấu trúc được ước lượng. Không nên ép toàn bộ mô hình về một loại chỉ vì phần mềm đang dùng thuận tiện hơn.
Một phương pháp chạy được không có nghĩa là thiết kế đã được bảo vệ. Mô hình có thể hội tụ nhưng estimand không khớp với câu hỏi, hoặc điểm composite có thể dự báo tốt trong mẫu nhưng không có ý nghĩa nội dung.
| Tình huống | Lập luận | Lựa chọn ban đầu |
|---|---|---|
| CFA thang đo tâm lý 5 nhân tố, mục tiêu kiểm định cấu trúc | Các chỉ báo là biểu hiện của factors; cần fit và so mô hình | CB-SEM với estimator phù hợp dữ liệu |
| Chỉ số năng lực số được tạo từ hạ tầng, kỹ năng và quy trình | Khái niệm là composite; mục tiêu dự báo hiệu suất | PLS-SEM hoặc composite SEM được đặc tả rõ |
| Thang phản ánh, muốn dùng thuật toán PLS để đối chiếu common-factor estimates | Common factors có căn cứ; cần correction for attenuation | PLSc như phân tích chính hoặc độ nhạy đã định trước |
6. Nếu chạy hai phương pháp, hãy thiết kế như phân tích độ nhạy
Chạy CB-SEM, PLS-SEM và PLSc trên cùng dữ liệu có thể giúp đánh giá độ nhạy, nhưng các phương pháp phải nhắm đến đại lượng đủ gần để so sánh. Nếu một mô hình coi cấu trúc là factor còn mô hình kia coi nó là composite, chênh lệch hệ số có thể phản ánh khác biệt estimand chứ không phải lỗi phần mềm.
Kế hoạch đối chứng nên chốt trước dấu và độ lớn hệ số, khoảng tin cậy, thứ hạng kết luận, fit, R² và dự báo ngoài mẫu. Khi kết quả khác nhau, báo cả hai cùng lý do phương pháp học. Không chọn output có p-value nhỏ hơn làm kết quả chính sau khi đã xem dữ liệu.
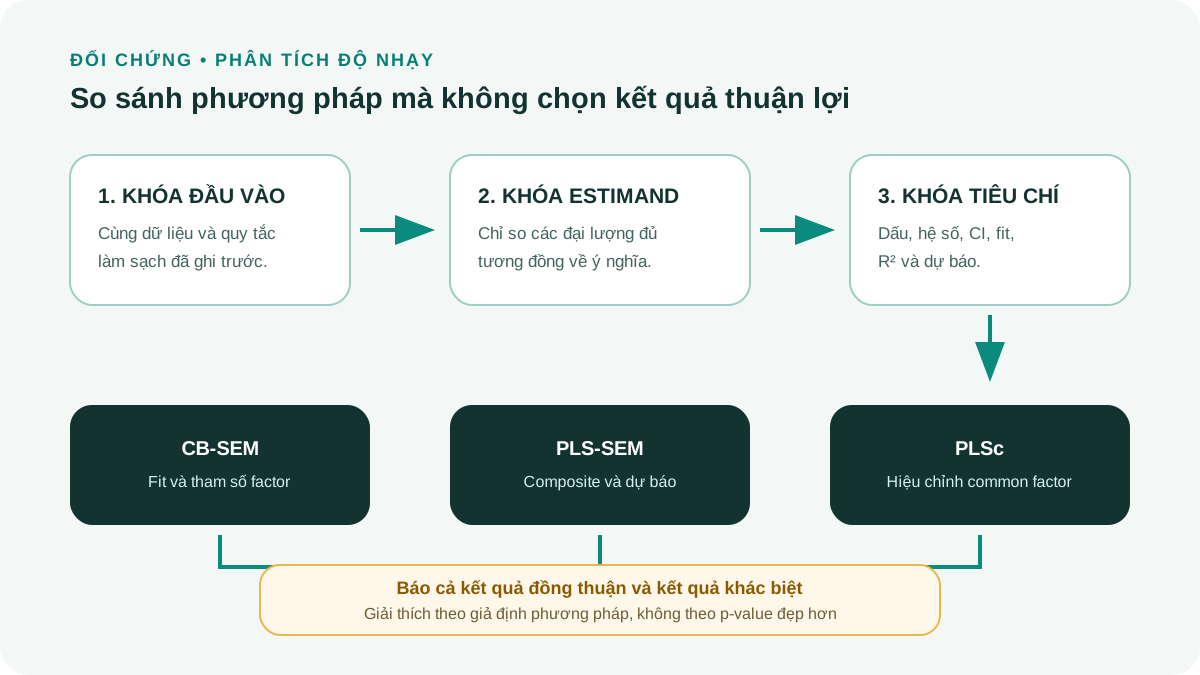
- Cùng phiên bản dữ liệu và quy tắc làm sạch.
- Đặc tả cấu trúc và đường dẫn được ghi rõ cho từng phương pháp.
- Estimand đủ tương đồng để so sánh.
- Tiêu chí đối chứng được chốt trước.
- Chênh lệch được diễn giải theo giả định của phương pháp.
- Kết quả bất lợi vẫn được báo cáo.
7. Mẫu biện minh lựa chọn và bảng kiểm
Mẫu báo cáo tiếng Việt
Nghiên cứu sử dụng [CB-SEM/PLS-SEM/PLSc] vì [các cấu trúc] được đặc tả là [common factors/composites/causal-formative] và estimand chính là [ ]. Mục tiêu phân tích là [kiểm định cấu trúc hiệp phương sai/ước lượng tham số/giải thích/dự báo]. Dữ liệu gồm [loại biến, số mức, missing, phân phối], vì vậy [estimator và xử lý] được chọn. Cỡ mẫu được xác định bằng [power/Monte Carlo/phương pháp đã nêu] cho [hiệu ứng tối thiểu]. Độ bền được kiểm tra bằng [phân tích độ nhạy], với tiêu chí được xác định trước.
- Mỗi cấu trúc đã được phân loại bằng lý thuyết đo lường.
- Estimand và mục tiêu bằng chứng được viết trước.
- Không dùng mẫu nhỏ hoặc không chuẩn như lý do duy nhất.
- Estimator phù hợp với loại biến và missing.
- PLSc chỉ dùng cho common-factor correction có căn cứ.
- Cỡ mẫu không dựa riêng vào quy tắc 10 lần.
- Đối chứng giữa phương pháp được trình bày như phân tích độ nhạy.
- Phần mềm, phiên bản, cài đặt và tiêu chí đánh giá được báo cáo.
Kết luận
Lựa chọn CB-SEM, PLS-SEM hay PLSc là một quyết định về mô hình và đại lượng cần ước lượng. Dữ liệu giúp chọn estimator, nhưng không thay thế định nghĩa cấu trúc và mục tiêu nghiên cứu.
Một biện minh tốt cho phép người đọc lần ngược từ phần mềm về estimand, lý thuyết đo lường và tiêu chí đánh giá. Nếu chuỗi này đứt ở đâu, lựa chọn phương pháp cần được xem lại ở đó.
Tài liệu tham khảo
- Bollen, K. A., & Bauldry, S. (2011). Three Cs in measurement models: Causal indicators, composite indicators, and covariates. Psychological Methods, 16(3), 265-284. https://doi.org/10.1037/a0024448
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297-316. https://doi.org/10.25300/MISQ/2015/39.2.02
- Grace, J. B., & Bollen, K. A. (2008). Representing general theoretical concepts in structural equation models: The role of composite variables. Environmental and Ecological Statistics, 15(2), 191-213. https://doi.org/10.1007/s10651-007-0047-7
- Hair, J. F., & Alamer, A. (2022). Partial least squares structural equation modeling (PLS-SEM) in second language and education research: Guidelines using an applied example. Research Methods in Applied Linguistics, 1(3), 100027. https://doi.org/10.1016/j.rmal.2022.100027
- Henseler, J., & Schuberth, F. (2025). Should PLS become factor-based or should CB-SEM become composite-based? Both! European Journal of Information Systems, 34(3), 551-563. https://doi.org/10.1080/0960085X.2024.2357123
- Kock, N., & Hadaya, P. (2018). Minimum sample size estimation in PLS-SEM: The inverse square root and gamma-exponential methods. Information Systems Journal, 28(1), 227-261. https://doi.org/10.1111/isj.12131
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354-373. https://doi.org/10.1037/a0029315
- Rigdon, E. E. (2016). Choosing PLS path modeling as analytical method in European management research: A realist perspective. European Management Journal, 34(6), 598-605. https://doi.org/10.1016/j.emj.2016.05.006
- SmartPLS. (n.d.). Consistent PLS-SEM (PLSc-SEM) algorithm in SmartPLS. https://smartpls.com/documentation/algorithms-and-techniques/core-algorithm/consistent-pls/
Ghi chú học thuật: Bài viết dùng thuật ngữ factor, composite và estimand theo nghĩa phương pháp học. Không có một quy tắc dựa riêng vào cỡ mẫu, phân phối hoặc tên phần mềm để chọn họ SEM.