
SEM và GSEM trong Stata: chọn lệnh, đặc tả mô hình và đọc kết quả
sem và gsem không phải hai mức độ nâng cao khác nhau. Lựa chọn bắt đầu từ loại outcome, thang đo, cấu trúc dữ liệu và đại lượng mà nghiên cứu muốn diễn giải.
Dùng sem cho hệ phương trình tuyến tính và mô hình biến tiềm ẩn với outcome liên tục khi các giả định phù hợp; dùng gsem khi outcome cần family hoặc link khác, hoặc mô hình có cấu trúc generalized và đa mức. Mỗi quyết định phải đi cùng cách diễn giải hệ số, xử lý missing và bộ chẩn đoán tương ứng (StataCorp, 2025).
1. Bắt đầu từ biến phụ thuộc, không bắt đầu từ sơ đồ
Một sơ đồ có nhiều mũi tên chưa phải lý do để dùng gsem. Hãy lập bảng cho từng phương trình: biến phụ thuộc là liên tục, nhị phân, thứ bậc hay đếm; dữ liệu có phân cụm không; biến nào là tiềm ẩn; hệ số cần được diễn giải trên thang nào.
sem phù hợp với mô hình phương trình cấu trúc tuyến tính theo khung covariance. gsem mở rộng sang các family và link khác, đồng thời hỗ trợ nhiều cấu trúc generalized và đa mức. Sự mở rộng này làm thay đổi ý nghĩa hệ số và các chỉ số hậu ước lượng có sẵn (Skrondal và Rabe-Hesketh, 2004; StataCorp, 2025).
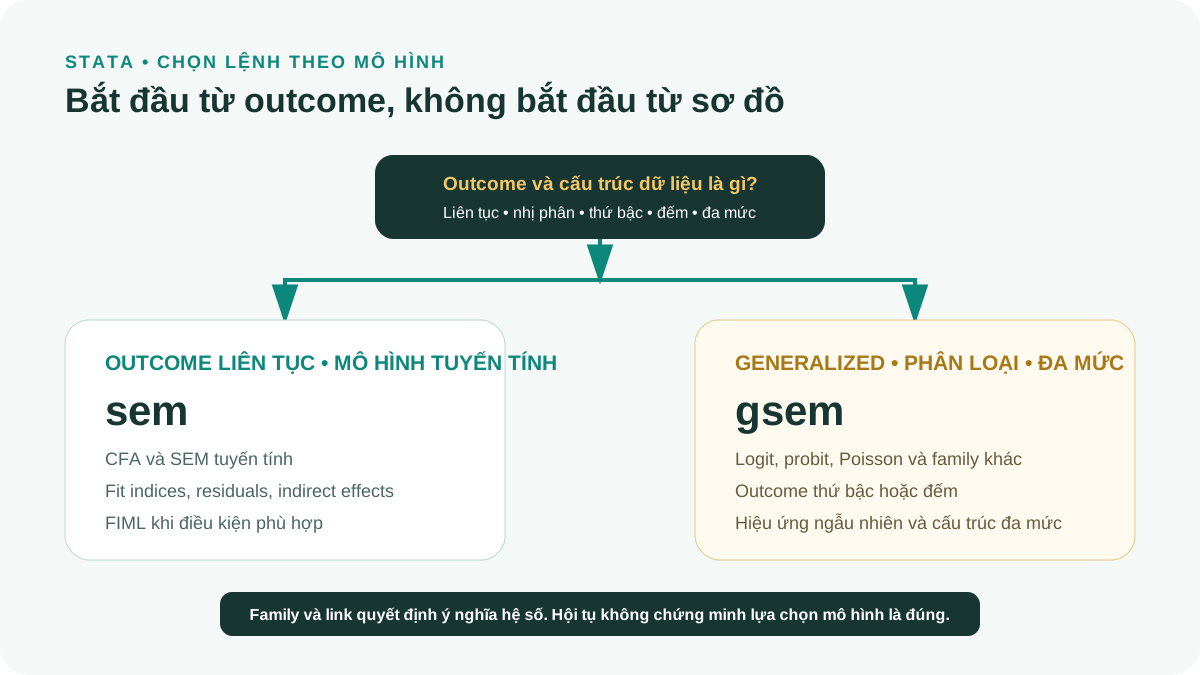
| Tình huống | Lệnh khởi đầu | Đại lượng cần diễn giải |
|---|---|---|
| Outcome liên tục, quan hệ tuyến tính | sem | Thay đổi theo đơn vị hoặc hệ số chuẩn hóa |
| Outcome nhị phân | gsem với logit hoặc probit | Log-odds, odds ratio hoặc xác suất dự báo |
| Outcome thứ bậc | gsem với ordered logit hoặc probit | Ngưỡng và xác suất theo mức |
| Outcome đếm | gsem với family phù hợp | Log-count hoặc tỷ số kỳ vọng |
| Mô hình đa mức generalized | gsem | Hiệu ứng cố định, ngẫu nhiên và dự báo có điều kiện |
| Cần bộ chỉ số fit SEM tuyến tính | sem nếu mô hình và dữ liệu cho phép | Chi-square và các chỉ số fit được hỗ trợ |
Không chọn logit, probit, Poisson hoặc negative binomial chỉ vì lệnh hội tụ. Lựa chọn phải phù hợp support của outcome, cơ chế tạo dữ liệu và câu hỏi cần trả lời.
2. Tạo do-file, log và cấu trúc dự án
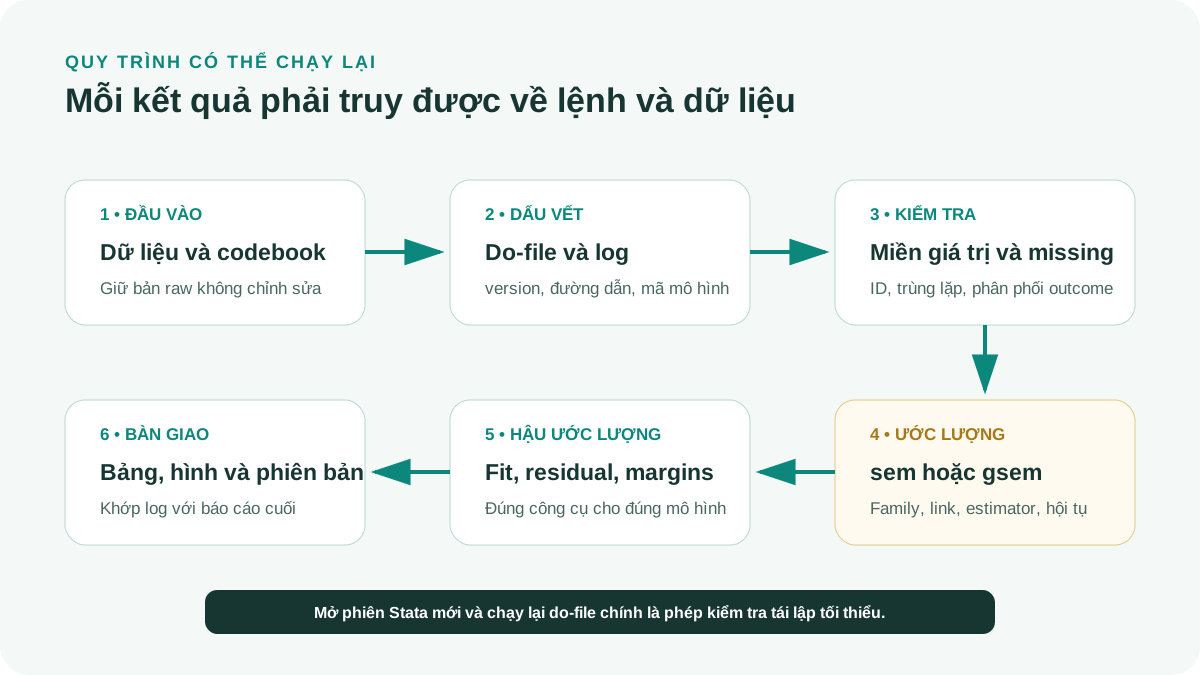
Do-file ghi lại toàn bộ lệnh theo thứ tự. Log lưu lệnh và kết quả dạng văn bản. Tài liệu Stata khuyến nghị dùng do-file và log để lưu dấu vết phân tích (StataCorp, n.d.).
Lệnh version giúp Stata diễn giải cú pháp theo release đã ghi. Hãy thay 19 bằng phiên bản được dùng để chạy phân tích cuối cùng. Đường dẫn tương đối giúp dự án di chuyển giữa các máy.
| Đường dẫn | Vai trò |
|---|---|
| data/raw/ | Dữ liệu ban đầu, không chỉnh sửa |
| data/derived/ | Dữ liệu được tạo bằng do-file |
| do/ | 01_import.do, 02_clean.do, 03_model.do |
| output/ | Log, bảng, hình và báo cáo |
| docs/ | Codebook, README và nhật ký quyết định |
version 19
clear all
set more off
capture log close _all

log using "output/analysis.log", text replace

import delimited "data/raw/survey.csv", ///
    varnames(1) encoding(utf8) clear

describe
codebook id gender age
isid id
duplicates report id
3. Kiểm tra dữ liệu trước khi đặc tả mô hình
Nhận dạng mô hình không thể sửa được lỗi mã hóa cơ bản. Trước khi dùng sem hoặc gsem, hãy kiểm tra ID, kiểu biến, phạm vi, missing, nhóm hiếm và phân phối outcome.
Ví dụ dưới đây coi 99 là mã thiếu theo codebook. Nếu 99 là giá trị hợp lệ trong dữ liệu thật, lệnh replace sẽ làm mất thông tin. Codebook phải được kiểm tra trước.
misstable summarize ///
    satisfaction1-satisfaction4 ///
    trust1-trust4 outcome

foreach v of varlist satisfaction1-satisfaction4 ///
                     trust1-trust4 outcome {
    replace `v' = . if `v' == 99
}

assert inrange(satisfaction1, 1, 5) ///
    if !missing(satisfaction1)

generate satisfaction2_r = 6 - satisfaction2 ///
    if !missing(satisfaction2)

egen satisfaction_mean = rowmean( ///
    satisfaction1 satisfaction2_r ///
    satisfaction3 satisfaction4)

egen n_satisfaction = rownonmiss( ///
    satisfaction1 satisfaction2_r ///
    satisfaction3 satisfaction4)

replace satisfaction_mean = . ///
    if n_satisfaction < 3

summarize satisfaction_mean outcome, detailMọi lệnh thay giá trị phải xuất phát từ codebook hoặc một lỗi dữ liệu đã được xác minh. Không thay missing và không xóa outlier chỉ để mô hình hội tụ.
4. Đặc tả và nhận dạng mô hình
Mô hình phải được nhận dạng trước khi đánh giá fit. Mỗi biến tiềm ẩn cần một thang đo, thường bằng cách cố định một tải nhân tố hoặc phương sai. Cấu trúc đường dẫn phải cung cấp đủ thông tin để ước lượng các tham số tự do.
Nhận dạng là thuộc tính của mô hình và dữ liệu, không phải một tùy chọn kỹ thuật. Bollen (1989) trình bày nền tảng của đặc tả, nhận dạng và ước lượng trong SEM. Nếu Stata báo mô hình không nhận dạng hoặc nghiệm bất thường, hãy kiểm tra phương trình và thang đo trước khi thêm ràng buộc.
| Thành phần | Câu hỏi cần trả lời |
|---|---|
| Biến tiềm ẩn | Chỉ báo nào đo cấu trúc nào? |
| Thang đo | Tải hoặc phương sai nào được cố định? |
| Đường cấu trúc | Đường nào có cơ sở lý thuyết? |
| Sai số tương quan | Có căn cứ nội dung và thiết kế hay không? |
| Outcome | Family và link nào phù hợp? |
| Missing | Estimator dùng thông tin nào và loại trường hợp ra sao? |
5. Thực hành sem với outcome liên tục
Ví dụ đầu tiên là mô hình đường dẫn quan sát. satisfaction_mean dự báo trust_mean và outcome; trust_mean tiếp tục dự báo outcome. method(mlmv) minh họa ước lượng maximum likelihood với missing values theo khả năng của sem. Điều kiện áp dụng vẫn phải được đánh giá.
estat gof cung cấp nhóm chỉ số fit sau sem. Không nên chọn một cutoff đơn lẻ để quyết định mô hình đúng. Hãy xem đặc tả, độ lớn residual, ước lượng tham số và tính hợp lý lý thuyết.
sem ///
    (trust_mean <- satisfaction_mean age) ///
    (outcome <- trust_mean satisfaction_mean age), ///
    method(mlmv)

estat gof, stats(all)
estat stdize, all
estat teffects

estimates store sem_pathestat teffects phù hợp cho mô hình sem tuyến tính. Với gsem phi tuyến, tích hai hệ số trên thang link không tự động là hiệu ứng gián tiếp trên thang xác suất.
6. Thực hành mô hình đo lường bằng sem
Tên biến tiềm ẩn trong Stata thường bắt đầu bằng chữ hoa để phân biệt với biến quan sát. Ví dụ sau đặc tả hai cấu trúc phản xạ. Chỉ báo đầu tiên của mỗi cấu trúc đóng vai trò đặt thang theo mặc định của lệnh.
Sau khi ước lượng, hãy kiểm tra tải, phương sai sai số, tương quan cấu trúc và residual. Một chỉ số fit tốt không bảo đảm các chỉ báo đo đúng nội dung khái niệm.
sem ///
    (Satisfaction -> ///
        satisfaction1 satisfaction2_r ///
        satisfaction3 satisfaction4) ///
    (Trust -> trust1 trust2 trust3 trust4), ///
    method(mlmv) standardized

estat gof, stats(all)
estat residuals, standardized

estimates store cfa_two_factor
7. Thực hành gsem với outcome thứ bậc
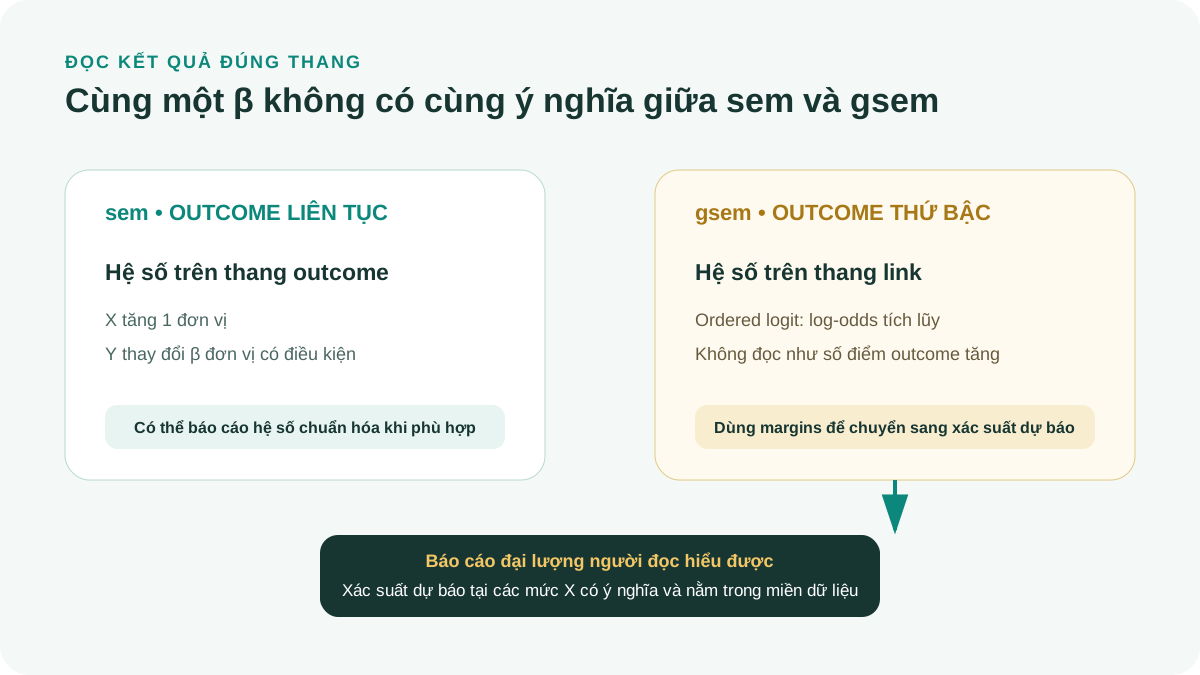
Giả sử loyalty_level có các mức thứ bậc. Ordered logit mô hình hóa xác suất tích lũy thông qua logit. Hệ số satisfaction_mean nằm trên thang log-odds và không nên diễn giải như số điểm loyalty tăng trực tiếp.
Sau gsem, nhiều chỉ số fit quen thuộc của sem không có cùng cách dùng. Hãy tập trung vào đặc tả family, link, hội tụ, ước lượng, dự báo và so sánh mô hình có căn cứ (StataCorp, 2025).
gsem ///
    (loyalty_level <- ///
        satisfaction_mean trust_mean age), ///
    ologit vce(robust)

estimates store gsem_ordinal

margins, at( ///
    satisfaction_mean = (1 2 3 4 5) ///
) predict(outcome(4))

marginsplot, ///
    ytitle("Predicted probability") ///
    xtitle("Satisfaction mean")

graph export ///
    "output/figures/ordinal_probability.png", ///
width(1600) replaceXác suất dự báo tại các mức có ý nghĩa thường dễ diễn giải hơn hệ số logit thô. Các mức trong at() phải nằm trong miền dữ liệu và phù hợp thang đo.
8. Không so sem và gsem bằng một con số máy móc
Hai mô hình chỉ nên so trực tiếp khi chúng mô tả cùng outcome, cùng mẫu và có quan hệ lồng nhau phù hợp với phép kiểm định. sem với outcome liên tục và gsem với outcome thứ bậc trả lời các mô hình xác suất khác nhau.
Nếu kết luận nhạy với cách xử lý outcome, có thể trình bày một phân tích độ nhạy. Hãy giải thích vì sao một đặc tả là chính, đặc tả còn lại kiểm tra điều gì và kết luận nào thay đổi.
| Nội dung | sem | gsem |
|---|---|---|
| Thang hệ số | Đơn vị outcome hoặc chuẩn hóa | Thang link, odds ratio hoặc xác suất |
| Global fit | Có bộ chỉ số SEM tuyến tính | Không dùng nguyên bộ chỉ số như sem |
| Missing | Phụ thuộc estimator và tùy chọn | Phụ thuộc family, estimator và cấu trúc |
| Indirect effect | Có thể dùng hiệu ứng tuyến tính | Cần xác định thang và đại lượng mục tiêu |
| Dự báo | Fitted values trên thang liên tục | Xác suất hoặc kỳ vọng theo family |
9. Xuất đầu ra và xác minh lần chạy cuối
Một do-file hoàn chỉnh phải đóng log và lưu dữ liệu dẫn xuất khi cần. datasignature tạo dấu nhận diện cho dữ liệu hiện tại, giúp phát hiện tệp bị thay đổi giữa các lần chạy.
Bảng trong luận văn phải truy được về một mô hình đã lưu. Nếu copy thủ công, hãy ghi tên estimates store hoặc mã mô hình bên dưới bảng làm dấu đối chiếu.
Mở một phiên Stata mới
Không dựa vào dữ liệu hoặc macro còn trong bộ nhớ.
Chạy do-file chính
Ghi lại return code, warning và số trường hợp.
Đối chiếu log
Xác nhận lệnh, estimator và mẫu đúng với bảng báo cáo.
Khóa phiên bản
Lưu do-file, dữ liệu dẫn xuất và output cùng một mã phiên bản.
compress
save "data/derived/survey_analysis.dta", replace

datasignature set, reset
datasignature report

estimates dir
log close
10. Mẫu báo cáo và bảng kiểm
Mẫu báo cáo tiếng Việt
Mô hình được ước lượng trong Stata [phiên bản] bằng [sem/gsem]. Với phương trình [tên], outcome được mô hình hóa bằng family [ ] và link [ ]; sai số chuẩn được tính theo [ ]. Mẫu phân tích gồm [N] trường hợp sau khi áp dụng quy tắc missing [mô tả]. Hệ số của [X] là b = [ ], SE = [ ], 95% CI [ , ], p = [ ]. Trên thang diễn giải [đơn vị/log-odds/xác suất], kết quả tương ứng với [diễn giải]. Các kiểm tra nhận dạng, hội tụ và độ nhạy cho thấy [mô tả ngắn].
- Mỗi outcome đã được phân loại theo support và thang đo.
- Lựa chọn sem hoặc gsem có lý do phương pháp.
- Family, link, estimator và cách tính sai số chuẩn được nêu.
- Thang của biến tiềm ẩn và điều kiện nhận dạng được kiểm tra.
- Missing và số trường hợp ở từng mô hình được báo cáo.
- Hệ số được diễn giải trên đúng thang.
- Không áp bộ cutoff fit của sem cho gsem.
- Do-file chạy được từ phiên mới và log đã được lưu.
- Dữ liệu ví dụ hoặc số liệu giả định được gắn nhãn rõ.
Kết luận
Quyết định giữa sem và gsem đi trước thao tác phần mềm. Khi outcome, family, link và đại lượng cần diễn giải đã rõ, syntax trở thành bản mô tả có thể kiểm tra của mô hình. Do-file, log và dữ liệu dẫn xuất giúp kết quả có thể truy nguyên.
Tài liệu tham khảo
- Bollen, K. A. (1989). Structural equations with latent variables. Wiley. https://doi.org/10.1002/9781118619179
- Skrondal, A., & Rabe-Hesketh, S. (2004). Generalized latent variable modeling: Multilevel, longitudinal, and structural equation models. Chapman & Hall/CRC. https://www.routledge.com/Generalized-Latent-Variable-Modeling-Multilevel-Longitudinal-and-Structural/Skrondal-Rabe-Hesketh/p/book/9780429205491
- StataCorp. (n.d.). Stata User's Guide. https://www.stata.com/manuals/u.pdf
- StataCorp. (2025). Stata 19 Structural Equation Modeling Reference Manual. Stata Press. https://www.stata.com/manuals/sem.pdf
Ghi chú học thuật: Cú pháp và postestimation có thể thay đổi theo release. Hãy thay version 19 bằng phiên bản thực tế và đối chiếu manual của bản Stata đang dùng. Dữ liệu, tên biến và kết quả trong ví dụ là giả lập.