
Đọc đúng R², R² hiệu chỉnh, f², Q² và PLSpredict trong PLS-SEM
R², f² và Q² không phải ba cách gọi khác nhau của mức độ ảnh hưởng. Chúng trả lời ba câu hỏi khác nhau về giải thích, đóng góp riêng và dự báo.
Đọc R² và f² trong mô hình cấu trúc, sau đó dùng PLSpredict để đánh giá dự báo ngoài mẫu. Q² từ blindfolding có giá trị lịch sử nhưng không thay thế Q²predict, RMSE, MAE hoặc phép kiểm CVPAT.
Giải thích và dự báo: hai câu hỏi khác nhau
- R² / R² hiệu chỉnh
Phương sai giải thích trong mẫu
- f²
Đóng góp riêng của biến dự báo
- PLSpredict
Sai số trên dữ liệu ngoài mẫu
- CVPAT
So sánh mất mát dự báo
Sơ đồ khái niệm. Không suy ra năng lực dự báo ngoài mẫu chỉ từ R² cao.
Nguồn: Lê Minh biên soạn · Minh họa khái niệm, không phải đầu ra phần mềm.1. Sau bài này, bạn cần làm được gì?
Chuyên đề được thiết kế để người đọc có thể mở một báo cáo SmartPLS 4 và tự trả lời bốn câu hỏi: mô hình giải thích bao nhiêu phương sai của từng biến nội sinh, mỗi biến dự báo đóng góp thêm bao nhiêu, mô hình có dự báo tốt hơn một chuẩn đơn giản hay không, và kết quả phải được viết thế nào trong luận văn hoặc bài báo. Phần mềm sử dụng trong quy trình cần được trích dẫn theo thông tin của nhà phát triển (Ringle và cộng sự, 2024).
Bạn cần có mô hình PLS-SEM đã hoàn tất đánh giá mô hình đo lường. Nếu độ tin cậy, giá trị hội tụ hoặc giá trị phân biệt chưa đạt, việc diễn giải mô hình cấu trúc nên tạm dừng vì các chỉ số R², f² và dự báo đang dựa trên điểm số cấu trúc chưa được bảo đảm.
- Đã xác định rõ biến nội sinh cần giải thích hoặc dự báo.
- Đã hoàn tất đánh giá mô hình đo lường phản ánh hoặc cấu tạo.
- Đã chạy PLS-SEM Algorithm và bootstrapping trên cùng một đặc tả mô hình.
- Biết mục tiêu chính của nghiên cứu là giải thích, dự báo hay kết hợp cả hai.
2. Bản đồ các chỉ số: mỗi chỉ số trả lời một câu hỏi
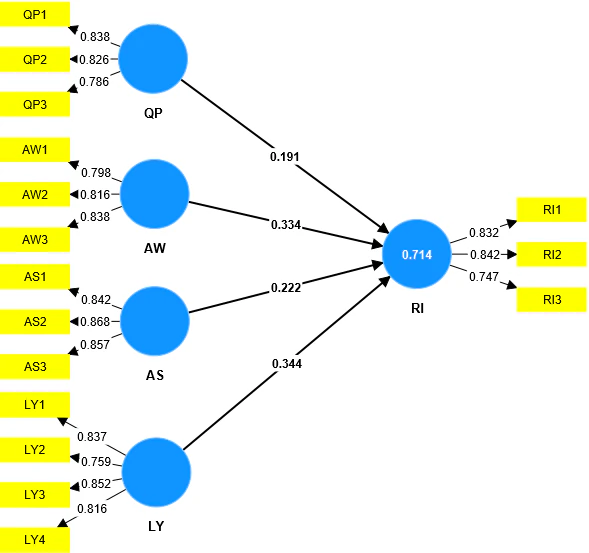
R² và R² hiệu chỉnh mô tả mức phương sai được giải thích trong mẫu. f² đo mức thay đổi của R² khi loại một biến dự báo khỏi phương trình. Q² từ blindfolding đánh giá predictive relevance theo thủ tục bỏ điểm dữ liệu, còn Q²predict trong PLSpredict so sánh sai số dự báo ngoài mẫu với chuẩn dự báo bằng giá trị trung bình (Hair và Alamer, 2022; Shmueli và cộng sự, 2019).
Không nên xếp các chỉ số này vào một bảng rồi kết luận chung rằng mô hình tốt. Một mô hình có R² khá vẫn có thể dự báo ngoài mẫu kém. Ngược lại, một biến có hệ số đường dẫn có ý nghĩa thống kê vẫn có thể tạo f² rất nhỏ nếu phần phương sai độc đáo mà nó đóng góp không đáng kể.
| Chỉ số | Câu hỏi cần trả lời | Đơn vị diễn giải | Không được suy diễn thành |
|---|---|---|---|
| R² | Các biến ngoại sinh giải thích bao nhiêu phương sai của Y? | Từng biến nội sinh | Bằng chứng dự báo ngoài mẫu |
| R² hiệu chỉnh | R² còn bao nhiêu sau khi tính đến số biến dự báo và cỡ mẫu? | Từng biến nội sinh | Một kiểm định ý nghĩa thống kê |
| f² | Bỏ X khỏi phương trình thì R² của Y giảm bao nhiêu? | Từng đường dẫn X → Y | Độ lớn của hệ số đường dẫn |
| Q² blindfolding | Mô hình có predictive relevance theo thủ tục bỏ điểm hay không? | Từng biến nội sinh | Dự báo dữ liệu mới |
| Q²predict | PLS-SEM có dự báo tốt hơn chuẩn trung bình hay không? | Từng chỉ báo nội sinh | So sánh trực tiếp với mô hình LM |
| RMSE hoặc MAE | Sai số dự báo của PLS-SEM có thấp hơn benchmark không? | Từng chỉ báo hoặc biến tiềm ẩn | Ý nghĩa nhân quả |
3. Công thức cần hiểu trước khi mở phần mềm
R² là tỷ lệ phương sai của biến nội sinh được giải thích bởi tập biến dự báo. R² hiệu chỉnh phạt việc thêm biến không cần thiết, vì vậy thường phù hợp hơn khi so sánh hai mô hình có số biến dự báo khác nhau.
Kích thước tác động f² được tính bằng f² = (R² đầy đủ - R² loại biến)/(1 - R² đầy đủ). Giá trị này đo phần phương sai giải thích bị mất khi loại một biến dự báo. Các mốc 0,02, 0,15 và 0,35 thường được dùng để mô tả tác động nhỏ, trung bình và lớn, nhưng cần xem là hướng dẫn chứ không phải ranh giới cứng (Cohen, 1988).
Q²predict được tính từ tỷ lệ giữa tổng sai số bình phương của dự báo PLS-SEM và tổng sai số bình phương của benchmark trung bình. Q²predict dương cho biết dự báo PLS-SEM có sai số thấp hơn benchmark này. Nó chưa cho biết PLS-SEM tốt hơn mô hình tuyến tính LM, vì việc đó phải đọc trực tiếp RMSE hoặc MAE của hai mô hình (SmartPLS, n.d.-a).
| Chỉ số | Công thức khái quát | Cách đọc |
|---|---|---|
| R² | 1 - SSE/SST | Tỷ lệ phương sai của Y được giải thích trong mẫu |
| R² hiệu chỉnh | 1 - (1 - R²)(n - 1)/(n - k - 1) | Điều chỉnh theo cỡ mẫu n và số biến dự báo k |
| f² | (R² đầy đủ - R² loại biến)/(1 - R² đầy đủ) | Đóng góp riêng của X vào R² của Y |
| Q²predict | 1 - SSE PLS/SSE benchmark trung bình | Giá trị dương nghĩa là PLS tốt hơn benchmark trung bình |
Công thức giúp kiểm tra logic và phát hiện việc đọc nhầm bảng. Khi báo cáo chính thức, dùng giá trị do SmartPLS tính từ đúng mô hình và đúng cấu hình. Không ghép R² của lần chạy này với R² loại biến từ một mô hình khác.
4. Ví dụ tính tay f² và đọc kết quả
Ví dụ dưới đây là tình huống minh họa, không phải kết quả của một nghiên cứu thực tế. Giả sử biến Ý định tiếp tục sử dụng có R² = 0,520 trong mô hình đầy đủ. Khi loại Niềm tin, R² giảm còn 0,470. Khi loại Chất lượng dịch vụ, R² giảm còn 0,505.
Với Niềm tin, f² = (0,520 - 0,470)/(1 - 0,520) = 0,104. Với Chất lượng dịch vụ, f² = (0,520 - 0,505)/(1 - 0,520) = 0,031. Theo mốc của Cohen (1988), cả hai thuộc vùng tác động nhỏ, nhưng Niềm tin đóng góp riêng lớn hơn khoảng ba lần so với Chất lượng dịch vụ.
Không được viết rằng Niềm tin tác động mạnh gấp ba lần chỉ từ hai giá trị f². f² so sánh thay đổi phương sai giải thích, không phải tỷ lệ giữa hai hệ số đường dẫn.
| Biến bị loại | R² đầy đủ | R² loại biến | f² | Diễn giải |
|---|---|---|---|---|
| Niềm tin | 0,520 | 0,470 | 0,104 | Tác động nhỏ, có đóng góp riêng rõ hơn |
| Chất lượng dịch vụ | 0,520 | 0,505 | 0,031 | Tác động nhỏ |
| Giá | 0,520 | 0,519 | 0,002 | Đóng góp không đáng kể |
5. Đọc R² và R² hiệu chỉnh theo bối cảnh
R² nằm từ 0 đến 1 và luôn không giảm khi thêm biến dự báo. Vì vậy, R² cao hơn không tự động chứng minh mô hình tốt hơn. Nếu mô hình mới thêm nhiều biến nhưng R² hiệu chỉnh gần như không đổi, phần mở rộng có thể không tạo thêm giá trị giải thích đáng kể.
Ngưỡng đánh giá R² phụ thuộc lĩnh vực, độ ổn định của hiện tượng, thiết kế nghiên cứu và mục tiêu mô hình. Một R² vừa phải có thể hợp lý trong hành vi người tiêu dùng, nơi quyết định chịu tác động của nhiều yếu tố ngoài mô hình. Khi báo cáo, nêu giá trị của từng biến nội sinh và giải thích theo bối cảnh, không gắn nhãn tốt hoặc kém chỉ dựa vào màu của phần mềm (SmartPLS, n.d.-b).
Nếu R² = 0,52, cách viết đúng là tập biến dự báo giải thích 52% phương sai của biến nội sinh trong mẫu. Không viết mô hình chính xác 52%, không viết 52% người trả lời có hành vi đó, và không xem đây là bằng chứng nhân quả.
6. Đọc f² cùng hệ số đường dẫn và khoảng tin cậy
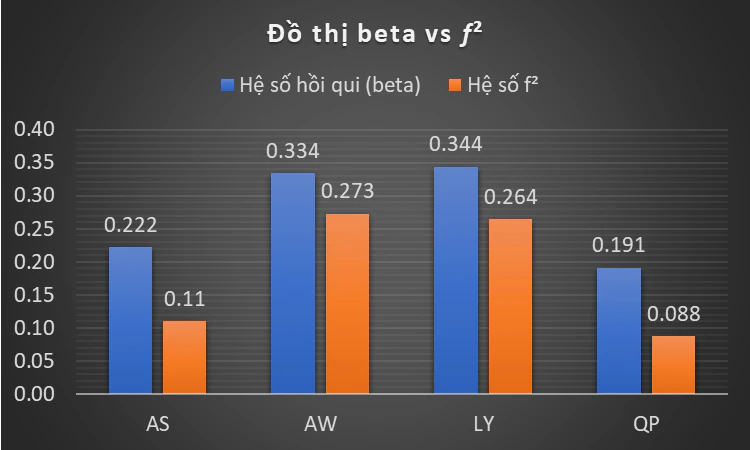
Hệ số đường dẫn chuẩn hóa cho biết chiều và độ lớn của quan hệ có điều kiện theo các biến khác trong phương trình. Bootstrapping cho biết mức bất định của ước lượng. f² trả lời một câu hỏi khác: nếu bỏ X, sức giải thích R² của Y suy giảm bao nhiêu.
Một đường dẫn có p < 0,05 nhưng f² < 0,02 có thể có ý nghĩa thống kê nhưng đóng góp thực tiễn rất nhỏ. Một đường dẫn chưa đạt ý nghĩa thống kê với khoảng tin cậy rộng cũng không nên được giữ chỉ vì f² vượt 0,02. Cần đọc hệ số, khoảng tin cậy, f² và lý thuyết cùng nhau.
| Kết quả bootstrap | f² | Cách diễn giải thận trọng |
|---|---|---|
| Có ý nghĩa | Từ 0,02 trở lên | Có bằng chứng về quan hệ và có đóng góp riêng ở mức tham khảo |
| Có ý nghĩa | Dưới 0,02 | Quan hệ có thể tồn tại nhưng đóng góp giải thích rất nhỏ |
| Không có ý nghĩa | Từ 0,02 trở lên | Kiểm tra khoảng tin cậy, power, đa cộng tuyến và đặc tả mô hình |
| Không có ý nghĩa | Dưới 0,02 | Chưa có bằng chứng thực nghiệm đáng kể trong mẫu này |
7. Phân biệt Q² blindfolding, Q²predict và CVPAT
Q² blindfolding được tạo bằng cách bỏ có hệ thống một phần điểm dữ liệu rồi tái ước lượng. Chỉ số này từng được dùng để đánh giá predictive relevance trong mẫu, nhưng không phải phép kiểm dự báo ngoài mẫu theo nghĩa huấn luyện và giữ lại dữ liệu.
PLSpredict chia dữ liệu thành các folds, ước lượng mô hình trên phần huấn luyện và dự báo phần giữ lại. Q²predict dương cho thấy PLS-SEM tốt hơn benchmark trung bình. Tiếp theo, cần so sánh RMSE hoặc MAE của PLS-SEM với mô hình LM trên từng chỉ báo nội sinh. SmartPLS hiện cũng trình bày CVPAT để kiểm định sự khác biệt về năng lực dự báo thay vì chỉ so sánh sai số một cách mô tả (SmartPLS, n.d.-a; Shmueli và cộng sự, 2019).
RMSE phạt mạnh sai số lớn và phù hợp khi phân phối sai số dự báo tương đối đối xứng. MAE ít nhạy với các sai số cực đoan hơn. Không nên chọn thước đo sau khi nhìn kết quả để tạo kết luận có lợi; hãy nêu tiêu chí từ trước và báo cáo nhất quán.
| Kết quả | Ý nghĩa | Bước tiếp theo |
|---|---|---|
| Q²predict > 0 | PLS-SEM tốt hơn benchmark trung bình | So sánh RMSE hoặc MAE với LM |
| Q²predict ≤ 0 | Benchmark trung bình bằng hoặc tốt hơn PLS-SEM | Không kết luận có năng lực dự báo cho chỉ báo đó |
| PLS RMSE/MAE < LM | Mô hình lý thuyết dự báo tốt hơn benchmark LM ở chỉ báo này | Tổng hợp trên toàn bộ chỉ báo nội sinh |
| PLS RMSE/MAE ≥ LM | LM dự báo bằng hoặc tốt hơn | Rà đặc tả và tránh tuyên bố dự báo mạnh |
| CVPAT p < 0,05 và loss PLS thấp hơn | Có bằng chứng chênh lệch predictive ability theo phép kiểm | Báo cáo loại benchmark và loss |
8. Quy trình thực hành trong SmartPLS 4
Tên mục có thể thay đổi nhẹ giữa các bản cập nhật SmartPLS 4, nhưng logic đọc kết quả không thay đổi. Giữ nguyên một đặc tả mô hình trong toàn bộ quy trình để các bảng có thể đối chiếu.
Chạy PLS-SEM Algorithm
Mở Calculate, chọn PLS-SEM Algorithm. Sau khi chạy, vào Quality criteria và ghi R-square cùng R-square adjusted cho từng biến nội sinh.
Mở bảng f-square
Trong Quality criteria, chọn f-square và chuyển sang Matrix khi cần. Đọc đúng ô giao giữa biến dự báo ở hàng và biến nội sinh ở cột.
Chạy bootstrapping
Đọc hệ số đường dẫn, khoảng tin cậy và p-value. Kiểm tra dấu của hệ số và việc khoảng tin cậy có chứa 0 hay không trước khi ghép với f².
Chạy PLSpredict
Mở Calculate, chọn PLSpredict. Kiểm tra số folds, số lần lặp và random seed. Thiết lập mặc định 10 folds là điểm khởi đầu, nhưng mỗi fold phải còn đủ quan sát để ước lượng ổn định.
Đọc kết quả theo hai benchmark
Đọc Q²predict để so với benchmark trung bình. Sau đó chọn RMSE hoặc MAE và so sánh PLS-SEM với LM trên từng chỉ báo nội sinh.
Kiểm tra CVPAT nếu có
Xác định benchmark, loại loss và chiều chênh lệch trước khi đọc p-value. p < 0,05 chỉ hữu ích khi loss của PLS-SEM thấp hơn benchmark.
Màu trong báo cáo SmartPLS là hỗ trợ nhận diện theo ngưỡng cài sẵn. Luận văn và bài báo phải trình bày giá trị, tiêu chí, nguồn của tiêu chí và diễn giải theo bối cảnh nghiên cứu.
9. Bài thực hành tự kiểm tra
Giả sử một mô hình dự báo Lòng trung thành từ Sự hài lòng, Niềm tin và Chi phí chuyển đổi. Kết quả minh họa cho Lòng trung thành là R² = 0,610 và R² hiệu chỉnh = 0,602. Khi loại Niềm tin, R² còn 0,550. Với chỉ báo LOY1, Q²predict = 0,180, RMSE của PLS-SEM = 0,720 và RMSE của LM = 0,760.
Từ các số trên, f² của Niềm tin bằng (0,610 - 0,550)/(1 - 0,610) = 0,154. Có thể mô tả đây là tác động trung bình theo mốc tham khảo của Cohen. Q²predict dương và RMSE của PLS-SEM thấp hơn LM ở LOY1, nên chỉ báo này có bằng chứng dự báo thuận lợi. Chưa được kết luận toàn bộ mô hình có năng lực dự báo cao cho đến khi kiểm tra các chỉ báo nội sinh còn lại.
- Tự tính lại f² và đối chiếu với 0,154.
- Giải thích chênh lệch 0,008 giữa R² và R² hiệu chỉnh.
- Kiểm tra Q²predict trước khi so sánh PLS-SEM với LM.
- Không suy rộng kết quả của LOY1 sang toàn bộ thang đo nếu chưa xem các chỉ báo khác.
- Viết một đoạn kết quả tách rõ giải thích trong mẫu và dự báo ngoài mẫu.
10. Mẫu báo cáo APA 7 và bảng kiểm cuối
Mẫu dưới đây dùng số giả định của bài thực hành. Khi dùng cho nghiên cứu thật, thay toàn bộ số trong ngoặc vuông bằng kết quả gốc và giữ số chữ số thập phân nhất quán.
Mẫu báo cáo tiếng Việt
Mô hình giải thích 61,0% phương sai của Lòng trung thành (R² = .610; R² hiệu chỉnh = .602). Niềm tin có tác động dương lên Lòng trung thành, β = [hệ số], khoảng tin cậy bootstrap 95% [cận dưới, cận trên], p = [giá trị], với kích thước tác động f² = .154. Kết quả PLSpredict cho LOY1 cho thấy Q²predict = .180; RMSE của PLS-SEM (.720) thấp hơn mô hình LM (.760). Kết quả này ủng hộ năng lực dự báo ngoài mẫu đối với LOY1. Kết luận về toàn bộ biến Lòng trung thành được đưa ra sau khi đối chiếu tất cả các chỉ báo nội sinh.
- Báo cáo R² và R² hiệu chỉnh cho từng biến nội sinh.
- Gắn f² với đúng đường dẫn và không đồng nhất f² với β.
- Báo cáo khoảng tin cậy bootstrap, không chỉ p-value.
- Nêu số folds, số lần lặp, random seed và thước đo sai số của PLSpredict.
- So sánh từng chỉ báo với benchmark trung bình và LM.
- Tách câu kết luận về giải thích trong mẫu khỏi câu kết luận về dự báo ngoài mẫu.
- Kiểm tra mọi trích dẫn trong bài đều có mục tương ứng trong tài liệu tham khảo.
Kết luận
Quy trình đúng có hai lớp. Lớp giải thích dùng R², R² hiệu chỉnh, hệ số đường dẫn và f². Lớp dự báo dùng PLSpredict, Q²predict, RMSE hoặc MAE và CVPAT khi phù hợp.
Một chỉ số đơn lẻ không đủ để gắn nhãn mô hình tốt. Kết luận chỉ đáng tin khi các chỉ số được đọc đúng câu hỏi, đúng đơn vị và đúng giới hạn của thiết kế nghiên cứu.
Tài liệu tham khảo
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Hair, J., & Alamer, A. (2022). Partial least squares structural equation modeling (PLS-SEM) in second language and education research: Guidelines using an applied example. Research Methods in Applied Linguistics, 1(3), 100027. https://doi.org/10.1016/j.rmal.2022.100027
- Ringle, C. M., Wende, S., & Becker, J.-M. (2024). SmartPLS 4 [Computer software]. SmartPLS. https://www.smartpls.com
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322-2347. https://doi.org/10.1108/EJM-02-2019-0189
- SmartPLS. (n.d.-a). PLSpredict: Assessing predictive power in PLS-SEM. https://www.smartpls.com/documentation/algorithms-and-techniques/prediction-and-segmentation/predict/
- SmartPLS. (n.d.-b). Result color thresholds in SmartPLS reports. https://www.smartpls.com/documentation/functionalities/thresholds/
Ghi chú học thuật: Ví dụ số trong bài được tạo để minh họa phép tính và cách diễn giải, không phải dữ liệu nghiên cứu thực tế. Ngưỡng là hướng dẫn tham khảo, không thay thế lý thuyết, thiết kế nghiên cứu và kiểm tra độ bất định.