
Phát triển thang đo nghiên cứu: quy trình 9 bước từ định nghĩa khái niệm đến xác nhận CFA
Một tập item có alpha cao chưa chắc là thang đo tốt. Phát triển thang đo phải bắt đầu từ miền khái niệm, bảo vệ giá trị nội dung, rồi tách giai đoạn khám phá và xác nhận.
Bài viết chuyển quy trình phát triển thang đo thành các điểm quyết định có thể thực hành: chọn thang có sẵn hay xây mới, lập bản đồ miền, tạo item, tính I-CVI và S-CVI, phỏng vấn nhận thức, chọn ma trận tương quan và estimator, thực hiện EFA, CFA và báo cáo bằng chứng giá trị. Bản cập nhật phân biệt khung nguồn, loại bằng chứng và hồ sơ quyết định; các phép tính minh họa không chứng nhận một thang đã được xác nhận.
1. Mục tiêu học tập và điều kiện đầu vào
Sau bài này, bạn cần phân biệt được xây mới, điều chỉnh và kiểm định lại một thang đo; lập được bản đồ miền khái niệm; tổ chức expert review và cognitive interview; chọn dữ liệu cho EFA và CFA; rồi báo cáo độ tin cậy cùng bằng chứng giá trị mà không biến các cutoff thành cơ chế loại item tự động.
DeVellis và Thorpe (2022) đặt việc xác định rõ điều cần đo ở bước đầu tiên. Nếu lý thuyết, phạm vi khái niệm và mục đích sử dụng điểm số chưa rõ, phân tích nhân tố về sau chỉ có thể sắp xếp các item mơ hồ thành một cấu trúc mơ hồ hơn.
- Có định nghĩa khái niệm dựa trên lý thuyết.
- Biết thang đo phục vụ mô tả nhóm, kiểm định quan hệ hay quyết định cá nhân.
- Đã rà soát thang hiện có và quyền sử dụng.
- Tổng thể, ngôn ngữ và bối cảnh áp dụng đã rõ.
- Có nguồn lực cho ít nhất một vòng pilot và một bước xác nhận độc lập.
- Có kế hoạch lưu toàn bộ item bị loại cùng lý do.
2. Trước tiên: xây mới, thích nghi hay dùng nguyên thang có sẵn?
Xây thang mới chỉ hợp lý khi thang hiện có không bao phủ khái niệm, tổng thể, ngôn ngữ hoặc mục đích điểm số. Nếu đã có công cụ phù hợp, dùng hoặc thích nghi có kiểm soát thường bảo tồn khả năng so sánh và tiết kiệm nguồn lực. Boateng và cộng sự (2018) khuyến nghị xác nhận rằng chưa có công cụ đáp ứng mục đích trước khi tạo một thang mới.
Dịch thang đo không chỉ là thay từ. Cần kiểm tra tương đương khái niệm, ngôn ngữ, cách phản hồi và cách sử dụng điểm số. Sau điều chỉnh, bằng chứng cũ không tự động chuyển nguyên vẹn sang bối cảnh mới.
| Chiến lược | Khi phù hợp | Việc tối thiểu |
|---|---|---|
| Dùng nguyên thang | Cùng khái niệm, ngôn ngữ, tổng thể và mục đích | Kiểm tra quyền dùng, cấu trúc và độ tin cậy trong mẫu mới |
| Thích nghi | Có thang gần phù hợp nhưng khác ngôn ngữ hoặc bối cảnh | Dịch và đối chiếu, expert review, cognitive interview, kiểm định lại cấu trúc |
| Xây mới | Khoảng trống khái niệm hoặc mục đích đo thực sự | Toàn bộ quy trình tạo item, khám phá và xác nhận |
3. Định nghĩa khái niệm và lập bản đồ miền
Định nghĩa làm việc cần nói rõ khái niệm là gì, biểu hiện qua những chiều nào, khác gì với các khái niệm gần và áp dụng cho ai trong bối cảnh nào. Clark và Watson (2019) coi khái niệm hóa rõ, ngân hàng item rộng và kiểm tra với các khái niệm gần là nền tảng của giá trị cấu trúc.
Hai mối đe dọa cần được ghi ngay trong bản đồ miền là thiếu đại diện khái niệm và phương sai không liên quan đến khái niệm. Miền quá hẹp bỏ sót nội dung; miền quá rộng kéo vào item đo một đặc điểm khác. Giá trị nội dung gắn với cách dùng thang trong một tổng thể và bối cảnh, không phải nhãn cố định của công cụ (DeVellis và Thorpe, 2022).
| Thành phần | Câu hỏi cần trả lời | Sản phẩm |
|---|---|---|
| Định nghĩa | Khái niệm là gì và không là gì? | Một định nghĩa làm việc có nguồn |
| Chiều | Có những biểu hiện hoặc tiểu miền nào? | Danh sách chiều và mô tả |
| Khái niệm gần | Cần phân biệt với điều gì? | Giả thuyết phân biệt và liên hệ |
| Tổng thể | Ngôn ngữ và trải nghiệm của ai? | Chân dung người trả lời |
| Mục đích điểm | Điểm số dùng cho suy luận nào? | Tuyên bố sử dụng và mức rủi ro |
4. Xác định trước: thang phản ánh hay chỉ số tổng hợp?
Các bước về tương quan item, EFA, CFA và nhất quán nội bộ trong bài chủ yếu dành cho thang phản ánh: các item biểu hiện một thuộc tính chung. Một tập câu hỏi cùng chủ đề chưa chắc cùng một biến tiềm ẩn. Chương 7 của DeVellis và Thorpe (2022) phân biệt thang phản ánh với chỉ số hình thành từ các thành phần; không thể quyết định chỉ bằng tên gọi thang đo hoặc bằng việc các cột đều là Likert.
Ví dụ tự biên soạn: các biểu hiện tin tưởng vào năng lực cố vấn có thể được giả thuyết là phản ánh một chiều chung. Số buổi tư vấn, số kênh hỗ trợ và thời gian chờ lại là những thành phần khác nhau của dịch vụ. Nếu gộp các thành phần này thành chỉ số, loại một thành phần có thể đổi định nghĩa chỉ số. Không dùng alpha thấp làm lý do duy nhất để loại thành phần, hoặc ép tất cả vào một nhân tố nhằm đạt độ tin cậy cao (DeVellis và Thorpe, 2022).
| Câu hỏi | Thang phản ánh | Chỉ số hình thành |
|---|---|---|
| Quan hệ khái niệm với item | Thuộc tính chung được giả thuyết tạo các biểu hiện | Các thành phần góp phần xác định đại lượng tổng hợp |
| Item có cần cùng biến thiên? | Có kỳ vọng theo mô hình, cần kiểm tra bằng dữ liệu | Không nhất thiết; tương quan cao không phải điều kiện định nghĩa |
| Khi bỏ một item | Cân nhắc mất nội dung và chất lượng đo | Có thể thay đổi chính nội hàm của chỉ số |
| Alpha và EFA/CFA | Có ích khi phù hợp giả định của mô hình | Không mặc định là tiêu chuẩn chọn hoặc loại thành phần |
5. Ba pha, chín bước: dùng đúng bản đồ của từng nguồn
Boateng và cộng sự (2018) tổ chức quy trình thành ba pha và chín bước: pha phát triển item gồm xác định miền/tạo item và giá trị nội dung; pha xây dựng thang gồm tiền thử nghiệm, thu mẫu, giảm item và trích nhân tố; pha đánh giá gồm kiểm tra chiều đo, độ tin cậy và giá trị. Hình minh họa dưới đây là sơ đồ tổng hợp phục vụ bài thực hành, không phải bản sao bảng quy trình của tác giả.
Chín bước trong chương 5 của DeVellis và Thorpe (2022) có cách chia khác: xác định điều cần đo, tạo item, chọn định dạng, chuyên gia rà soát, phỏng vấn nhận thức, cân nhắc biến phục vụ kiểm tra giá trị, thu mẫu phát triển, đánh giá item và tối ưu độ dài. Ấn bản 4 có tám bước, chưa tách phỏng vấn nhận thức thành bước riêng (DeVellis, 2017). Vì vậy, số bước giống nhau không làm hai quy trình trở thành một; các đề mục chi tiết bên dưới được tổ chức theo quyết định thực hành.
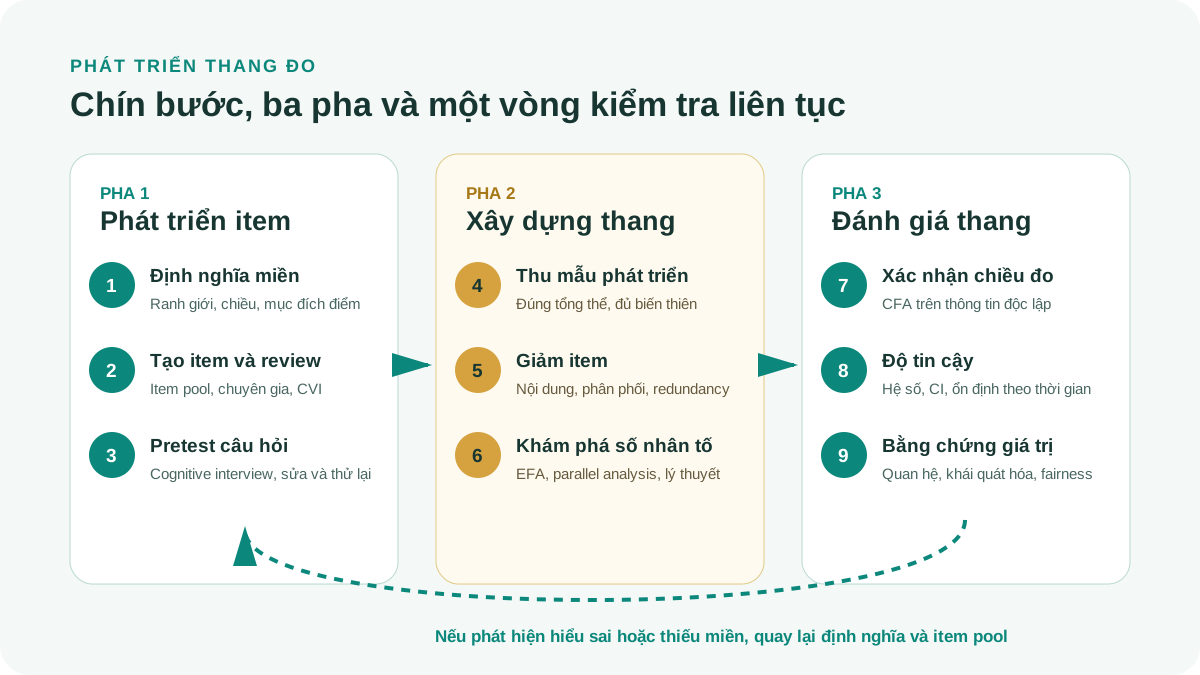
Xác định miền và tạo item
Khóa định nghĩa, phạm vi, chiều dự kiến; kết hợp lý thuyết với trải nghiệm của nhóm đích.
Thu bằng chứng giá trị nội dung
Rà soát mức liên quan, bao phủ miền và cách hiểu với chuyên gia cùng người thuộc nhóm đích.
Tiền thử nghiệm câu hỏi
Kiểm tra diễn giải, truy xuất thông tin và chọn đáp án; sửa có lý do và thử lại.
Thu mẫu phát triển
Chọn người và điều kiện thu phù hợp; lập kế hoạch cỡ mẫu theo phân tích dự kiến.
Giảm item có căn cứ
Kết hợp mã hóa, phân phối, nhận xét nội dung và bằng chứng thống kê.
Trích nhân tố
Khám phá số chiều và cấu trúc bằng phương pháp phù hợp; không đồng nhất PCA với mô hình nhân tố chung.
Kiểm tra chiều đo
Đánh giá cấu trúc dự kiến trên thông tin chưa dùng để lựa chọn item khi thiết kế cho phép.
Ước lượng độ tin cậy
Chọn hệ số theo mô hình điểm số, nêu bất định và kiểm tra ổn định theo thời gian khi cần.
Tích lũy bằng chứng giá trị
Kiểm tra các quan hệ dự kiến và giới hạn suy luận theo tổng thể, bối cảnh, mục đích sử dụng.
6. Tạo ngân hàng item rộng nhưng không trôi khỏi khái niệm
Item ban đầu nên rộng hơn thang cuối cùng để mỗi phần của miền có nhiều cơ hội được đại diện. Redundancy ở cấp khái niệm có ích, nhưng các item gần như sao chép câu chữ có thể tạo tương quan do phương pháp và thổi phồng độ tin cậy (DeVellis và Thorpe, 2022).
Kết hợp hướng suy diễn từ lý thuyết và thang có sẵn với hướng quy nạp từ phỏng vấn, focus group hoặc quan sát. Mỗi item chỉ nên có một ý, phù hợp trình độ ngôn ngữ, có khung thời gian khi cần và tránh nội dung mà phần lớn người trả lời không có cơ hội trải nghiệm. Hinkin (1998) cũng nhấn mạnh việc tạo item phải được đặt trong một chuỗi phát triển và kiểm định tâm trắc rõ ràng.
- Mỗi chiều có nhiều item ứng viên.
- Item phản ánh khái niệm, không chỉ cùng một chủ đề chung.
- Không có cặp item chỉ thay một vài từ.
- Mức cụ thể của item khớp mức cụ thể của khái niệm.
- Câu chữ phù hợp với người trả lời mục tiêu.
- Đã ghi nguồn và quyền sử dụng cho item kế thừa.
- Item đảo chiều chỉ được dùng khi có lý do, không dùng như mẹo chống trả lời máy móc.
7. Chọn định dạng phản hồi như một phần của phép đo
Số điểm không càng nhiều càng tốt. Người trả lời cần phân biệt được các mức một cách có ý nghĩa. Điểm giữa phù hợp khi trạng thái trung tính có thật; thang chẵn phù hợp khi lựa chọn hướng là cần thiết và không ép người thực sự trung tính trả lời sai. DeVellis và Thorpe (2022) cho rằng lựa chọn điểm giữa phải theo mục đích và bản chất câu hỏi, không có một định dạng luôn vượt trội.
Thang Likert, semantic differential, nhị phân và visual analog tạo loại thông tin khác nhau. Nếu dùng nhiều phương thức thu thập, cần kiểm tra xem cùng item và đáp án có hoạt động tương đương trên giấy, điện thoại và web hay không.
| Định dạng | Phù hợp khi | Cảnh báo |
|---|---|---|
| Likert đồng ý | Đo mức tán thành một mệnh đề rõ | Dễ có acquiescence và wording effect |
| Construct-specific | Có thể hỏi trực tiếp mức tin cậy, hữu ích, hài lòng | Nhãn phải khớp đúng khái niệm |
| Semantic differential | Đánh giá đối tượng theo cặp tính từ | Hai cực phải thực sự đối lập |
| Nhị phân | Trạng thái có hoặc không rõ ràng | Ít biến thiên, thường cần nhiều item hơn |
| Visual analog | Cần độ nhạy liên tục và giao diện phù hợp | Khó tương đương giữa thiết bị và người dùng |
8. Chuyên gia rà soát và bằng chứng giá trị nội dung
Chuyên gia cần nhận được định nghĩa khái niệm và mô tả từng chiều trước khi chấm item. Họ đánh giá mức liên quan, tính đại diện, độ rõ, sự súc tích, nội dung bị thiếu và khả năng nhầm sang khái niệm khác. Một con số CVI không thay thế nhận xét về lý do item có hoặc không đại diện miền (DeVellis và Thorpe, 2022; Boateng và cộng sự, 2018).
Nên có cả chuyên gia nội dung và người hiểu phương pháp đo lường. Khi có điều kiện, thêm người thuộc tổng thể mục tiêu để phát hiện ngôn ngữ hoặc trải nghiệm mà nhóm nghiên cứu bỏ sót. Quyết định cuối cùng phải được ghi trong bảng disposition, không chỉ lưu file chấm điểm rời rạc.
| Mã item | Chiều dự kiến | Liên quan | Rõ | Ý kiến | Quyết định và lý do |
|---|---|---|---|---|---|
| NT1 | Năng lực | Cao | Trung bình | Từ chuyên môn | Sửa theo ngôn ngữ người dùng |
| NT2 | Năng lực | Trung bình | Cao | Gần với tự tin | Giữ tạm và kiểm tra phân biệt |
| NT3 | Toàn vẹn | Thấp | Cao | Ngoài miền | Loại vì không phù hợp định nghĩa |
9. Tính CVI: nêu mẫu số, công thức và phạm vi kết luận
Với giao thức chấm mức liên quan 1 đến 4, điểm 3 hoặc 4 được mã là có liên quan. I-CVI là số chuyên gia chấm 3 hoặc 4 chia cho số chuyên gia đã đánh giá item trong giao thức đó. I-CVI = 7 / 8 = 0,875. S-CVI/Ave là trung bình các I-CVI; S-CVI/UA là tỷ lệ item được tất cả chuyên gia đồng ý. Hai chỉ số toàn thang này không được ghi chung là S-CVI mà thiếu cách tính (Polit và Beck, 2006).
Theo quy ước được Polit và Beck (2006) thảo luận, hội đồng 3 đến 5 chuyên gia cần đồng thuận đầy đủ ở item; với 6 đến 10 người, mốc 0,78 thường được dùng. Số phiếu thực tế là số nguyên: 6 người cần ít nhất 5 phiếu, còn 8 người cần ít nhất 7 phiếu để vượt mốc 0,78. Đây là giao thức sàng lọc đã chọn, không phải quy luật bảo đảm giá trị. Nếu panel lớn hơn hoặc dùng hướng dẫn khác, ghi nguồn và tiêu chí của hướng dẫn đó thay vì kéo dài bảng ngưỡng tùy ý. Với S-CVI/Ave, nguồn này khuyến nghị mốc 0,90 cho mức liên quan trung bình; việc đạt mốc vẫn cần lập luận nội dung.
Ví dụ tự biên soạn trong Hình 2 có bốn item và tám chuyên gia: các số phiếu liên quan là 8, 7, 5 và 8. I-CVI tương ứng 1,000; 0,875; 0,625; 1,000; S-CVI/Ave = 0,875 và S-CVI/UA = 0,500. Item thứ ba cần rà soát, nhưng con số chưa quyết định giữ hay loại: nếu nó là đại diện duy nhất cho một tiểu miền, cần viết lại hoặc bổ sung ứng viên rồi đánh giá lại (DeVellis và Thorpe, 2022).
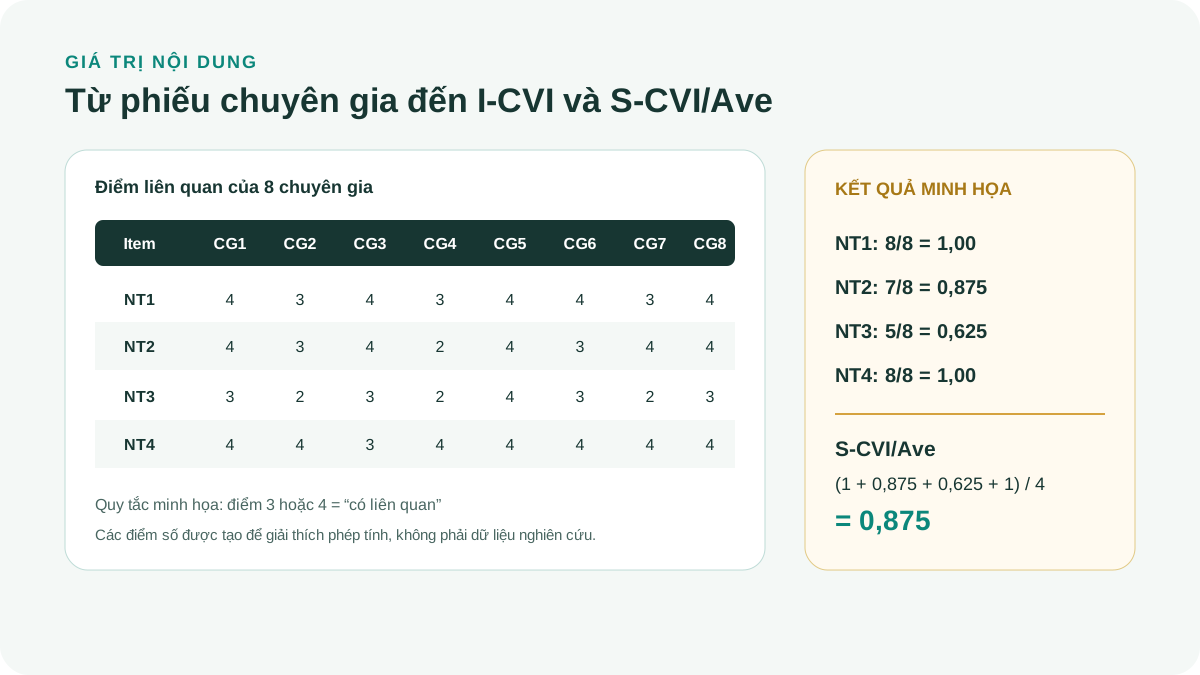
| Đại lượng | Kết quả minh họa | Ý nghĩa và giới hạn |
|---|---|---|
| S-CVI/Ave | (1 + 0,875 + 0,625 + 1) / 4 = 0,875 | Mức liên quan trung bình; không che đi item thấp |
| S-CVI/UA | 2 / 4 = 0,500 | Hai trong bốn item có đồng thuận tuyệt đối |
| Độ rõ và bao phủ miền | Đọc riêng từ phiếu và bản đồ miền | Không suy ra từ phép chấm mức liên quan |
| Phiếu thiếu hoặc chuyên gia vắng | Ghi số phiếu có ở từng item | Không coi bỏ trống là điểm 1; hoàn tất hoặc giải trình trước khi tổng hợp |
# Constructed relevance ratings, rows = items, columns = experts.
ratings <- rbind(
  NT1 = c(4,3,4,3,4,4,3,4),
  NT2 = c(4,3,4,2,4,3,4,4),
  NT3 = c(3,2,3,2,4,3,2,3),
  NT4 = c(4,4,3,4,4,4,4,4)
)
stopifnot(!anyNA(ratings), all(ratings %in% 1:4))
relevant <- ratings >= 3
i_cvi <- rowMeans(relevant)
s_cvi_ave <- mean(i_cvi)
s_cvi_ua <- mean(rowSums(relevant) == ncol(ratings))
data.frame(item = rownames(ratings), votes = rowSums(relevant), I_CVI = i_cvi)
c(S_CVI_Ave = s_cvi_ave, S_CVI_UA = s_cvi_ua)
# Expected: 0.875 and 0.500. Complete ratings only; no missing-value rule inferred.
10. Phỏng vấn nhận thức trước khi pilot số lượng lớn
Cognitive interview yêu cầu người thuộc tổng thể mục tiêu diễn giải item, nói điều họ nghĩ đến và giải thích cách chọn mức phản hồi. Đây là bằng chứng trực tiếp hơn câu hỏi chung rằng bảng hỏi có dễ hiểu hay không. Willis (2005) cung cấp khung thực hành cho think-aloud và verbal probing.
Không cần mọi người trả lời mọi probe cho mọi item. Có thể chia item thành nhóm để giảm gánh nặng, nhưng phải bảo đảm toàn bộ item và nhóm người quan trọng đều được quan sát. Mục tiêu không phải loại mọi item có nhận xét phê bình, mà là nhận diện mẫu hiểu sai có hệ thống.
Chọn người tham gia
Tuyển người giống tổng thể mục tiêu và bao phủ khác biệt ngôn ngữ hoặc trải nghiệm quan trọng.
Chuẩn bị protocol
Gồm consent, think-aloud, probe hiểu, paraphrase, recall, judgment và response mapping.
Thử item theo ngữ cảnh
Dùng đúng hướng dẫn, thứ tự, thiết bị và đáp án dự kiến.
Ghi lỗi theo item
Mã hóa hiểu sai, từ khó, thiếu tình huống, đáp án không phù hợp và phản ứng nhạy cảm.
Sửa có căn cứ
Nêu vấn đề, thay đổi, lý do và giả thuyết về tác dụng của thay đổi.
Kiểm thử lại
Item sửa lớn phải qua vòng mới, không chỉ được nhóm nghiên cứu tự đọc lại.
11. Đừng bỏ qua các biến phục vụ kiểm tra giá trị
Bước 6 trong DeVellis và Thorpe (2022) là cân nhắc các biến phục vụ kiểm tra giá trị trước khi thu mẫu phát triển. Đó có thể là một phép đo khái niệm gần, khái niệm cần phân biệt, tiêu chuẩn ngoài hoặc một phép đo xu hướng trả lời khi có lý do. Các biến này không tự động trở thành item của thang đang xây dựng.
Lập bảng giả thuyết trước khi thu thập: kỳ vọng quan hệ theo hướng nào, tại thời điểm nào, giữa loại điểm nào và vì sao. Nếu dùng cùng một tập câu để vừa chọn item vừa tạo tiêu chuẩn đánh giá chính nó, bằng chứng sẽ thiếu độc lập. Kiểm tra nguồn, quyền dùng và gánh nặng trả lời của từng phép đo ngoài; không thêm hàng loạt thang chỉ để tìm một tương quan có p nhỏ (DeVellis và Thorpe, 2022).
| Mục đích | Phép đo ngoài dự kiến | Thông tin phải khóa trước |
|---|---|---|
| Hội tụ | Phép đo cùng hoặc gần khái niệm có nguồn | Chiều quan hệ, phiên bản, cách tính điểm |
| Phân biệt | Phép đo khái niệm khác nhưng dễ lẫn | Vì sao phải tách; mô hình so sánh |
| Tiêu chuẩn hoặc dự báo | Kết quả ngoài phù hợp mục đích thang | Thời điểm thu; tránh dùng chính item làm tiêu chuẩn |
| Xu hướng trả lời | Phép đo phương pháp có căn cứ | Lý do sử dụng; không mặc định tương quan là gian lận |
12. Chọn mẫu phát triển theo độ ổn định, không theo một tỷ lệ máy móc
Mẫu phải thuộc tổng thể sử dụng thang và có đủ biến thiên trên khái niệm. Mẫu quá đồng nhất có thể làm item trông yếu dù vấn đề nằm ở range restriction. Mẫu rất khác tổng thể có thể tạo cấu trúc nhân tố không lặp lại ở ứng dụng thật (DeVellis và Thorpe, 2022).
Không có tỷ lệ người trên item áp dụng cho mọi trường hợp. Cỡ mẫu phụ thuộc số nhân tố, số item mỗi nhân tố, communalities, mức tải, estimator, dữ liệu phân loại và độ phức tạp của mô hình. Boateng và cộng sự (2018) trình bày các quy tắc thường dùng nhưng đồng thời khuyến nghị mẫu đủ lớn và xác nhận bằng dữ liệu độc lập. Hãy lập luận theo mô hình dự kiến và power hoặc độ chính xác, không chỉ viết áp dụng quy tắc 10:1.
Nếu cùng một mẫu vừa quyết định số nhân tố, loại item, thêm tương quan residual rồi được dùng để tuyên bố CFA xác nhận, kết quả xác nhận bị lạc quan. Dùng mẫu độc lập hoặc chia mẫu khi cỡ mẫu và thiết kế cho phép.
13. Chọn correlation và estimator theo loại dữ liệu
EFA và CFA không nên mặc định xử lý mọi item Likert như biến liên tục. Khi item là ordinal, có ít mức hoặc phân phối lệch rõ, ma trận tương quan polychoric cùng estimator cho dữ liệu phân loại như WLSMV thường phù hợp hơn việc dùng Pearson và ML thông thường. Flora và Curran (2004) cho thấy ước lượng dựa trên biến phân loại cần được cân nhắc khi số mức ít và giả định liên tục không hợp lý.
Khi chỉ báo có đủ mức, phân phối không quá lệch và việc xem gần liên tục được bảo vệ, ML hoặc robust ML như MLR có thể được cân nhắc. Không có quy tắc rằng mọi Likert đều phải dùng WLSMV hoặc mọi thang từ 5 điểm đều được dùng ML. Quyết định cần dựa trên số mức, phân phối, cỡ mẫu, mô hình và cách phần mềm hiện thực estimator. Với EFA, Fabrigar và cộng sự (1999) khuyến nghị lựa chọn extraction, số nhân tố và phép xoay như một chuỗi quyết định có lý thuyết.
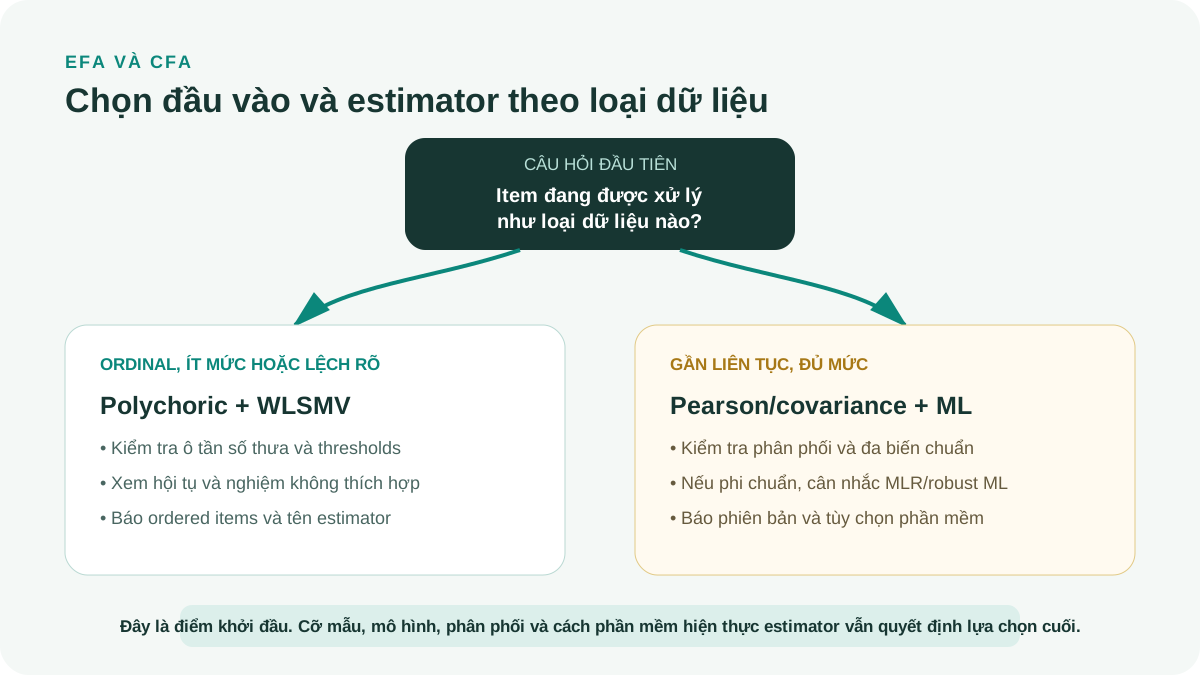
| Dữ liệu và mục tiêu | Correlation hoặc đầu vào | Estimator khởi đầu | Kiểm tra bắt buộc |
|---|---|---|---|
| Ordinal, ít mức hoặc lệch rõ | Polychoric | WLSMV hoặc estimator robust categorical tương đương | Ô tần số thưa, hội tụ, threshold và độ nhạy theo đặc tả |
| Gần liên tục, đủ mức, phân phối hợp lý | Pearson hoặc covariance | ML | Đa biến chuẩn, nghiệm không thích hợp và residual |
| Gần liên tục nhưng phi chuẩn | Covariance | MLR hoặc robust ML tương đương | Sai số chuẩn robust, chỉ số phù hợp robust và outlier |
| EFA với nhân tố dự kiến liên hệ | Theo loại dữ liệu | Extraction phù hợp | Parallel analysis và phép xoay chéo |
Mplus thường dùng WLSMV cho chỉ báo categorical; lavaan có thể dùng estimator WLSMV với ordered items; các phần mềm khác có tên hoặc thuật toán gần tương đương. Báo đúng phần mềm, phiên bản, kiểu biến và tùy chọn đã dùng.
14. Đánh giá item, EFA và CFA theo chuỗi quyết định
Bắt đầu bằng missing, phân phối, floor hoặc ceiling, tương quan item và corrected item-total. Item có tương quan âm có thể do đảo mã sai, wording khác hoặc không thuộc cùng chiều. Không được loại item chỉ để tăng alpha nếu item bảo vệ một phần quan trọng của miền (DeVellis và Thorpe, 2022).
EFA khám phá số chiều và pattern loading. CFA kiểm tra một cấu trúc đã đặc tả. Clark và Watson (2019) khuyến nghị ưu tiên tính đơn hướng và giá trị cấu trúc thay vì chạy theo nội bộ nhất quán. Hệ số alpha cao có thể do nhiều item gần trùng, trong khi thang vẫn thiếu phần quan trọng của khái niệm.
Kiểm tra mã và missing
Xác nhận chiều điểm, item đảo, giá trị ngoài miền và lý do thiếu.
Đọc phân phối item
Tìm floor, ceiling, ít biến thiên và nhóm không có cơ hội trải nghiệm.
Đọc ma trận tương quan
Phát hiện item tách khỏi nhóm, cặp gần trùng và dấu âm bất thường.
Chạy parallel analysis
Dùng cùng lý thuyết để chọn số nhân tố hợp lý, không dựa một tiêu chí duy nhất.
Ước lượng EFA phù hợp
Với item ordinal ít mức hoặc lệch, cân nhắc polychoric và phương pháp phù hợp; với dữ liệu gần liên tục, nêu rõ Pearson, ML hoặc lựa chọn robust. Dùng phép xoay chéo khi các nhân tố có thể liên hệ.
Xem loading và cross-loading
Cân nhắc độ lớn, chênh lệch, nội dung và tác động đến bao phủ miền.
Khóa mô hình đo
Ghi item giữ, item loại, lý do và cấu trúc trước khi chuyển sang CFA.
Chạy CFA độc lập
Đánh giá nghiệm, tải, residual, độ phù hợp và mô hình cạnh tranh có lý thuyết.
Đánh giá độ tin cậy
Báo alpha hoặc omega phù hợp cùng CI khi có; kiểm tra test-retest nếu điểm cần ổn định.
Kiểm tra bằng chứng giá trị
Đối chiếu quan hệ hội tụ, phân biệt, tiêu chuẩn và dự báo với giả thuyết định trước.
15. Khóa cách chấm điểm, đảo chiều và xử lý thiếu trước khi xuất thang
Một cấu trúc đã được hỗ trợ chưa tự xác định cách tính điểm. Trung bình item, tổng điểm, điểm nhân tố CFA và điểm cấu trúc PLS-SEM là những phép tính khác nhau. Điểm trung bình gán trọng số bằng nhau; điểm nhân tố phụ thuộc mô hình và cách ước lượng; điểm PLS phụ thuộc đặc tả và trọng số của thuật toán. Phải ghi tên phép tính, phiên bản item và hướng điểm, thay vì gọi chung là điểm tiềm ẩn (DeVellis và Thorpe, 2022; SmartPLS, n.d.).
Ví dụ tự biên soạn dưới đây chỉ minh họa chấm điểm ba item của một tiểu thang giả định, chưa xác nhận tính đơn hướng. Thang đáp án 1 đến 5 có item Q2R được đảo bằng 6 trừ điểm gốc. Hai chính sách được so sánh là chỉ tính khi đủ ba item, hoặc tính khi có ít nhất hai item. Chính sách hai trong ba là giả định của ví dụ, không phải ngưỡng chung. Không đổi không áp dụng thành mức trung tính; việc cho phép thiếu bao nhiêu phải theo manual hoặc giao thức có biện minh.
| Người giả định | Q1; Q2R gốc; Q3 | Trung bình đủ 3 | Trung bình ít nhất 2 |
|---|---|---|---|
| A | 4; 2; 5 | 4,3333… | 4,3333… |
| B | 3; 1; 4 | 4,0000 | 4,0000 |
| C | 5; 3; thiếu | Không tính | 4,0000 |
| D | thiếu; 2; 3 | Không tính | 3,5000 |
| E | 2; thiếu; 2 | Không tính | 2,0000 |
# Constructed teaching data, not an estimated measurement model.
raw <- data.frame(Q1=c(4,3,5,NA,2), Q2R=c(2,1,3,2,NA), Q3=c(5,4,NA,3,2))
items <- raw
items$Q2R <- 6 - raw$Q2R  # Reverse once; retain the raw values.
n_valid <- rowSums(!is.na(items))
mean_complete <- ifelse(n_valid == 3, rowMeans(items), NA_real_)
mean_min2 <- ifelse(n_valid >= 2, rowMeans(items, na.rm=TRUE), NA_real_)
data.frame(n_valid, mean_complete, mean_min2)
# The two-of-three rule is illustrative, not a universal scoring recommendation.
16. Ví dụ giả định: phát triển thang Niềm tin vào cố vấn phương pháp
Ví dụ dưới đây là tình huống minh họa và các số liệu đều được tạo để hướng dẫn cách quyết định. Nhóm nghiên cứu định nghĩa niềm tin gồm năng lực, toàn vẹn và thiện chí. Từ lý thuyết và phỏng vấn định tính, 27 item được tạo. Expert review giữ 22 item, cognitive interview sửa 6 item và loại 2 item hai ý. Bản pilot còn 20 item.
EFA trên mẫu phát triển giả định gợi ý ba nhân tố. Hai item có cross-loading gần nhau nhưng một item bao phủ nội dung thiện chí chưa có item thay thế. Nhóm giữ item đó để sửa và kiểm tra ở vòng mới thay vì loại ngay. CFA trên mẫu độc lập giả định cho thấy item sửa có tải 0,67. Mô hình ba nhân tố phù hợp hơn mô hình một nhân tố. Kết luận phải là bằng chứng ban đầu ủng hộ cấu trúc ba chiều, không phải thang đã được chứng minh đúng vĩnh viễn.
| Giai đoạn | Số item | Phát hiện | Quyết định |
|---|---|---|---|
| Item pool | 27 | Đủ ba chiều, có câu gần trùng | Đưa toàn bộ sang review |
| Expert review | 22 | Ba item ngoài miền, hai item trùng | Loại có lý do nội dung |
| Cognitive interview | 20 | Sáu câu khó hiểu, hai câu hai ý | Sửa sáu, loại hai |
| EFA giả định | 15 | Ba nhân tố, một item cần bảo vệ nội dung | Giữ item sau khi viết lại |
| CFA giả định | 15 | Mô hình ba nhân tố tốt hơn mô hình một nhân tố | Xem là xác nhận ban đầu |
17. Đọc độ tin cậy và giá trị như bằng chứng tích lũy
Độ tin cậy là điều kiện cần nhưng không đủ cho giá trị. Alpha hoặc omega cho biết tính nhất quán theo mô hình và dữ liệu, không cho biết thang đang đo đúng khái niệm. Một hệ số rất cao có thể báo hiệu item lặp nội dung, còn hệ số thấp có thể do đa chiều, ít item, range restriction hoặc sai số lớn (DeVellis và Thorpe, 2022).
Giá trị là lập luận về cách diễn giải và sử dụng điểm số. Hãy đặt giả thuyết trước về quan hệ với biến gần, biến khác biệt và tiêu chuẩn ngoài. Boateng và cộng sự (2018) và Clark và Watson (2019) đều xem xác nhận chiều đo, độ tin cậy và mạng lưới quan hệ có lý thuyết là các phần bổ sung, không thay thế lẫn nhau.
| Bằng chứng | Câu hỏi | Ví dụ phân tích |
|---|---|---|
| Nội dung | Item có đại diện đúng và đủ miền không? | Bản đồ miền, expert review, cognitive interview |
| Cấu trúc nội bộ | Số chiều và pattern item có phù hợp không? | EFA, CFA, mô hình cạnh tranh |
| Độ tin cậy | Điểm có đủ chính xác và ổn định cho mục đích không? | Omega hoặc alpha, test-retest, CI |
| Quan hệ với biến khác | Mẫu quan hệ có đúng lý thuyết không? | Hội tụ, phân biệt, tiêu chuẩn, dự báo |
| Khái quát hóa | Kết quả có ổn định giữa nhóm và thời điểm không? | Cross-validation và measurement invariance |
18. Mười lỗi làm thang đo trông tốt nhưng khó bảo vệ
| Lỗi | Hậu quả | Cách sửa |
|---|---|---|
| Bắt đầu từ item, không có định nghĩa | Miền trôi theo dữ liệu | Khóa định nghĩa và bản đồ miền trước |
| Tự tạo thang dù đã có công cụ phù hợp | Mất khả năng so sánh | Rà soát và giải thích khoảng trống |
| Chỉ dùng chuyên gia nội dung | Bỏ sót lỗi đo lường và câu chữ | Kết hợp nội dung, phương pháp và người dùng |
| Không cognitive interview | Không biết item được hiểu ra sao | Pretest với người thuộc tổng thể |
| Dùng alpha để quyết định mọi item | Hy sinh giá trị nội dung | Đọc nội dung, cấu trúc và độ tin cậy cùng nhau |
| PCA được gọi là EFA | Sai logic mô hình nhân tố | Nêu đúng phương pháp và estimator |
| Chỉ dùng eigenvalue lớn hơn 1 | Số nhân tố thiếu ổn định | Kết hợp parallel analysis và lý thuyết |
| EFA và CFA trên cùng mẫu | Xác nhận lạc quan | Mẫu độc lập hoặc split-sample có kế hoạch |
| Loại item không lưu lý do | Không tái lập và khó đánh giá miền | Duy trì disposition log |
| Tuyên bố thang đã valid | Biến bằng chứng theo bối cảnh thành thuộc tính tuyệt đối | Nêu loại bằng chứng, mẫu, bối cảnh và giới hạn |
19. Mẫu báo cáo APA 7 và bảng kiểm trước khi công bố
Phần phương pháp cần nêu nguồn item, quyền sử dụng, cách tạo hoặc dịch, thành phần expert review, cách tính I-CVI và S-CVI, quy trình cognitive interview, đặc điểm mẫu ở từng giai đoạn, loại biến, correlation, estimator và tiêu chí quyết định. Hinkin (1998) lưu ý rằng đo lường yếu làm suy giảm khả năng diễn giải quan hệ trong nghiên cứu thực địa, vì vậy quy trình thang đo không nên bị thu gọn thành một câu đã kiểm tra Cronbach alpha.
Danh mục phụ lục nên lưu toàn bộ item thử nghiệm, item cuối, hướng dẫn, thang đáp án, mã hóa, disposition log và ma trận liên kết item với miền. Nếu không thể công bố item vì bản quyền, vẫn cần mô tả đủ quy trình và chỉ dẫn nguồn hợp pháp.
Mẫu báo cáo tiếng Việt
Thang [tên] được [xây mới/thích nghi] để đo [định nghĩa] trong [tổng thể và bối cảnh]. Item pool ban đầu gồm [ ] item được hình thành từ [lý thuyết, thang có sẵn và dữ liệu định tính]. [Số và thành phần] chuyên gia chấm mức liên quan trên thang [ ], I-CVI dao động từ [ ] đến [ ] và S-CVI/Ave = [ ]; [số] vòng phỏng vấn nhận thức được thực hiện với [đặc điểm người tham gia]. EFA trên mẫu phát triển N = [ ] sử dụng [polychoric/Pearson], [estimator hoặc extraction] và [phép xoay], kết hợp parallel analysis, dẫn đến [số] nhân tố với [số] item. CFA trên mẫu độc lập N = [ ] sử dụng [WLSMV/ML/MLR] để kiểm tra cấu trúc [ ], cho tải chuẩn hóa từ [ ] đến [ ] và độ phù hợp [các chỉ số]. Độ tin cậy được ước lượng bằng [omega/alpha/test-retest] = [ ] với [CI nếu có]. Bằng chứng giá trị được đánh giá qua [giả thuyết và kết quả]. Các kết luận giới hạn trong [tổng thể, ngôn ngữ và mục đích điểm số]. Nêu rõ đây là thang phản ánh hay chỉ số hình thành, biến ngoài dùng kiểm tra giá trị, quy tắc điểm [trung bình/tổng/điểm mô hình], item đảo [ ], số item tối thiểu để tính điểm [ ] và cách xử lý không áp dụng. Lưu phiên bản item và codebook cùng hồ sơ.
- Đã giải thích vì sao xây mới hoặc thích nghi.
- Định nghĩa, chiều và ranh giới khái niệm có nguồn.
- Item pool bao phủ miền và lưu nguồn từng item.
- Expert review có mức chấm, công thức I-CVI, S-CVI được gọi đúng tên và nhận xét định tính.
- Cognitive interview dùng đúng tổng thể và có vòng sửa.
- Mẫu phát triển phù hợp, đủ dị biệt và được mô tả.
- EFA dùng correlation, estimator hoặc extraction và phép xoay phù hợp với loại dữ liệu.
- Số nhân tố không được quyết định bởi một cutoff duy nhất.
- Mỗi item loại có lý do nội dung và thống kê.
- CFA dùng thông tin độc lập với giai đoạn khám phá.
- Độ tin cậy phù hợp mục đích và không thay thế giá trị.
- Bằng chứng hội tụ, phân biệt và tiêu chuẩn theo giả thuyết.
- Đã cân nhắc measurement invariance nếu so sánh nhóm.
- Báo cáo không dùng cụm đã chứng minh thang hoàn toàn valid.
- Bản item, codebook và disposition log được lưu phiên bản.
Kết luận
Phát triển thang đo là một chương trình tích lũy bằng chứng, không phải một lần chạy EFA rồi CFA. Quyết định tốt bảo vệ đồng thời ba điều: khái niệm, trải nghiệm của người trả lời và cấu trúc dữ liệu.
Nếu phải rút gọn, hãy rút item sau khi hiểu điều gì sẽ mất khỏi miền khái niệm. Một thang ngắn nhưng đo sai hoặc đo thiếu không trở nên tốt hơn chỉ vì alpha tăng.
Tài liệu tham khảo
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149
- Clark, L. A., & Watson, D. (2019). Constructing validity: New developments in creating objective measuring instruments. Psychological Assessment, 31(12), 1412-1427. https://doi.org/10.1037/pas0000626
- DeVellis, R. F., & Thorpe, C. T. (2022). Scale development: Theory and applications (5th ed.). SAGE Publications. https://us2.sagepub.com/en-us/nam/scale-development/book269114
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272-299. https://doi.org/10.1037/1082-989X.4.3.272
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466-491. https://doi.org/10.1037/1082-989X.9.4.466
- Hinkin, T. R. (1998). A brief tutorial on the development of measures for use in survey questionnaires. Organizational Research Methods, 1(1), 104-121. https://doi.org/10.1177/109442819800100106
- Polit, D. F., & Beck, C. T. (2006). The content validity index: Are you sure you know what is being reported? Critique and recommendations. Research in Nursing & Health, 29(5), 489-497. https://doi.org/10.1002/nur.20147
- Willis, G. B. (2005). Cognitive interviewing: A tool for improving questionnaire design. SAGE Publications. https://us.sagepub.com/en-us/nam/cognitive-interviewing/book225856
- DeVellis, R. F. (2017). Scale development: Theory and applications (4th ed.). SAGE. https://in.sagepub.com/en-in/ind/scale-development/book246123
- SmartPLS. (n.d.). PLS-SEM algorithm. https://smartpls.com/documentation/algorithms-and-techniques/core-algorithm/pls/
Ghi chú học thuật: Các con số trong ví dụ là giả định. Thang dùng cho quyết định cá nhân có hệ quả cao cần chuẩn độ tin cậy, độ chính xác, fairness và thẩm định ngoài mẫu nghiêm ngặt hơn thang dùng cho nghiên cứu ở cấp nhóm. Nội dung được đối chiếu lại ngày 14/11/2026; chỉ nêu phạm vi nguồn thực sự tham khảo, không công khai ebook hoặc dữ liệu cá nhân.