
PLS-MGA và MICOM trong SmartPLS 4: so sánh nhóm có căn cứ
Một đường dẫn có ý nghĩa ở nhóm A nhưng không có ý nghĩa ở nhóm B không chứng minh hai nhóm khác nhau. Phân tích đa nhóm phải kiểm định trực tiếp chênh lệch và chỉ có ý nghĩa khi measurement invariance đã được đánh giá.
Quy trình đúng bắt đầu từ giả thuyết khác biệt nhóm và cách tạo nhóm, đánh giá cỡ mẫu và mô hình riêng từng nhóm, thực hiện MICOM, rồi dùng permutation hoặc PLS-MGA để kiểm định chênh lệch tham số. Kết luận phải nêu hệ số từng nhóm, độ chênh, p-value và tên thủ tục.
So sánh nhóm bắt đầu từ tính tương đương
- Định nghĩa nhóm
Lý thuyết và mã hóa rõ ràng
- Bất biến đo lường
Kiểm tra khả năng so sánh
- So sánh đường dẫn
Kiểm định trực tiếp chênh lệch
- Diễn giải
Báo cáo cỡ mẫu và giới hạn
Sơ đồ khái niệm. Hai p-value khác nhau không tự chứng minh hai hệ số khác nhau.
Nguồn: Lê Minh biên soạn · Minh họa khái niệm, không phải đầu ra phần mềm.1. Sau bài này, bạn cần làm được gì?
Người đọc cần phân biệt MGA với moderation liên tục, tạo nhóm không làm sai ý nghĩa dữ liệu, kiểm tra ba bước MICOM, chạy permutation và PLS-MGA trong SmartPLS 4, rồi diễn giải đúng p-value của từng thủ tục. Phần mềm cần được ghi phiên bản và trích dẫn trong phương pháp (Ringle và cộng sự, 2024).
Đầu vào gồm biến nhóm đã được xác định trước, giả thuyết nêu tham số nào được kỳ vọng khác nhau, mô hình PLS-SEM dùng chung cho các nhóm, codebook mã hóa và cỡ mẫu đủ ở từng nhóm. Cỡ mẫu tổng không thay thế việc kiểm tra power và độ ổn định riêng cho nhóm nhỏ nhất.
- Nhóm có ý nghĩa lý thuyết hoặc thiết kế, không được tạo sau khi xem kết quả.
- Có giả thuyết hoặc câu hỏi chỉ rõ tham số cần so sánh.
- Mỗi quan sát thuộc đúng một nhóm và mã nhóm không thiếu.
- Mô hình, chỉ báo, mã hóa và cài đặt thuật toán giống nhau giữa nhóm.
- Cỡ mẫu và chất lượng dữ liệu được kiểm tra riêng cho từng nhóm.
- Đã quyết định dùng PLS-SEM hay PLSc-SEM trước khi chọn thủ tục permutation tương ứng.
2. MGA kiểm định điều gì?
MGA kiểm định trực tiếp liệu cùng một tham số, chẳng hạn path coefficient, outer loading hoặc outer weight, có khác nhau giữa các nhóm được xác định trước hay không. Sarstedt và cộng sự (2011) cho thấy các thủ tục MGA khác nhau có giả định và cách xây dựng phân phối kiểm định khác nhau, nên tên phương pháp phải xuất hiện trong báo cáo.
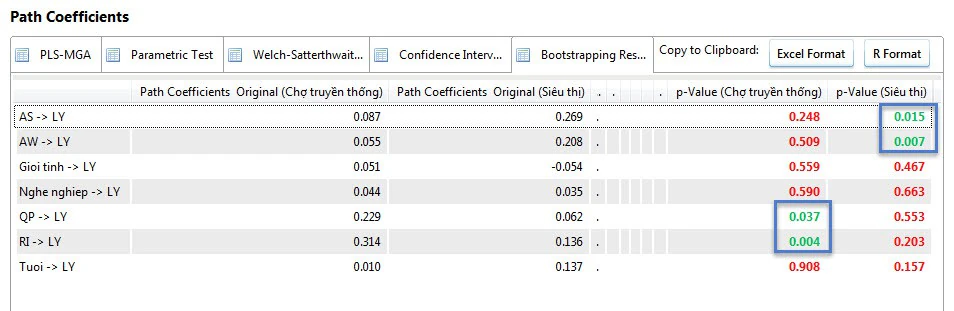
MGA không được thực hiện bằng cách so hai p-value riêng lẻ. Một hệ số có p = 0,03 ở nhóm A và p = 0,12 ở nhóm B vẫn có thể không khác nhau có ý nghĩa, vì sai số chuẩn và phân phối của chênh lệch chưa được kiểm định.
Phép kiểm định cần nhắm trực tiếp vào H0: beta_A - beta_B = 0. Chỉ kết luận khác biệt khi thủ tục MGA hoặc permutation bác bỏ giả thuyết này theo mức alpha đã định trước.
3. Tạo nhóm và kiểm tra dữ liệu trước khi chạy
Các nhóm tự nhiên hoặc do thiết kế, như quốc gia, nhóm can thiệp hoặc loại khách hàng, phù hợp với MGA khi định nghĩa và mã hóa rõ. Cắt biến liên tục theo mean hoặc median làm mất thông tin, giảm power và khiến kết quả phụ thuộc điểm cắt. Nếu giả thuyết nói một biến liên tục thay đổi độ dốc, interaction term thường phù hợp hơn.
Trước khi so sánh, lập bảng số quan sát, missing, phân phối biến nhóm, đặc điểm mẫu và chất lượng chỉ báo cho từng nhóm. Mô hình phải hội tụ và không có lỗi nghiêm trọng ở từng nhóm; kết quả tốt trong toàn mẫu không bảo đảm nhóm nhỏ đạt yêu cầu.
| Câu hỏi nghiên cứu | Phương pháp nên cân nhắc | Lưu ý |
|---|---|---|
| Hai nhóm định trước có khác cùng một path không? | MGA sau MICOM | Kiểm định trực tiếp chênh lệch |
| Một biến liên tục làm thay đổi độ dốc không? | Continuous moderation | Giữ thông tin của biến liên tục |
| Có các phân khúc chưa quan sát không? | FIMIX-PLS hoặc PLS-POS | Phân khúc khám phá cần xác nhận tiếp |
| Có trên hai nhóm không? | So sánh có kế hoạch hoặc omnibus approach | Kiểm soát số phép thử và giả thuyết |
4. Vì sao MICOM phải đi trước MGA?
Khác biệt path có thể phản ánh cách tạo điểm khác nhau giữa nhóm thay vì một cơ chế cấu trúc khác nhau. MICOM kiểm tra các composite trong PLS-SEM; không thay thế đánh giá đo lường riêng từng nhóm và không phải bản sao của CFA đa nhóm (Henseler et al., 2016).
Đạt configural và compositional tạo bằng chứng partial invariance. Muốn tuyên bố khả năng so sánh cho toàn mô hình, cần xem toàn bộ composite liên quan. Bước 3 đánh giá thêm bình đẳng trung bình và phương sai; full invariance không chứng minh các paths bằng nhau và không tự cho phép bỏ phân tích nhóm để chỉ báo cáo dữ liệu gộp (Hair et al., 2018, chương 4).
| Bước | Bằng chứng | Không được thay bằng |
|---|---|---|
| 1. Configural | Cùng chỉ báo, xử lý và cấu hình ước lượng | Một p-value trong output |
| 2. Compositional | c quan sát so với phân phối hoán vị | c lớn là đủ hoặc c làm tròn thành 1 |
| 3. Mean/variance | Chênh lệch quan sát trong khoảng tham chiếu | Chỉ kiểm tra khoảng chứa 0 |
5. Đọc MICOM trong SmartPLS 4
SmartPLS (n.d.-a) trả kết quả MICOM trong báo cáo permutation; bước 1 cần được kiểm tra qua hồ sơ thiết lập. Ở bước 2, tại alpha = 0,05, đối chiếu c với phân vị 5% của phân phối hoán vị và giữ đủ chữ số để quyết định. Không dùng c = 1 của biến đơn chỉ báo làm bằng chứng độ tin cậy (Hair et al., 2018, chương 4).
Ở bước 3, so chênh lệch trung bình và log tỷ số phương sai quan sát với từng khoảng hoán vị tương ứng. Khoảng có chứa 0 vẫn có thể không chứa chênh lệch quan sát. Đây là điểm cần kiểm tra khi đối chiếu sách, output và cách diễn giải cũ (Hair et al., 2018, chương 4; SmartPLS, n.d.-a).
Lập bảng theo từng composite trước khi đọc các paths. Nếu một cấu trúc chưa hỗ trợ compositional, các kết luận so sánh liên quan đến cấu trúc đó chưa có cơ sở bất biến cần thiết. Tăng số permutations không khắc phục lỗi mã hóa hoặc đặc tả; sửa có căn cứ rồi chạy lại toàn chuỗi (Hair et al., 2018, chương 4).
Bài MICOM đi sâu vào cách đọc từng bước và có ví dụ khoảng chứa 0 nhưng không chứa chênh lệch quan sát. Bài này tiếp tục từ phạm vi bất biến được hỗ trợ để kiểm định trực tiếp chênh lệch hệ số giữa nhóm.
6. Quy trình thao tác trong SmartPLS 4
Permutation và PLS-MGA đều dùng các nhóm đã tạo trong data set. Với PLS-SEM chuẩn, dùng permutation chuẩn; nếu mô hình được ước lượng bằng PLSc-SEM, dùng consistent permutation để quá trình so sánh dựa trên cùng thuật toán (SmartPLS, n.d.-b).
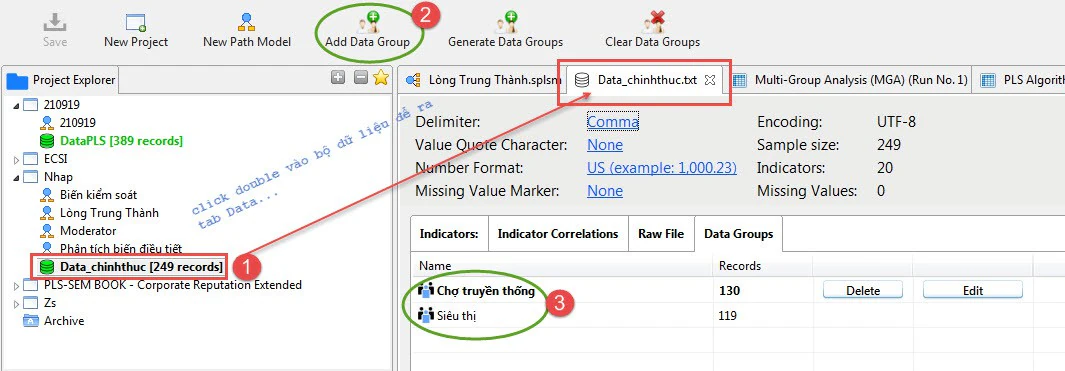
Tạo data groups
Mở data set, tạo filter theo mã nhóm và kiểm tra số quan sát thực nhận ở từng nhóm.
Chạy mô hình riêng từng nhóm
Đánh giá measurement model, structural model, lỗi hội tụ và các chỉ báo bất thường trong từng nhóm.
Mở Calculate > Permutation
Chọn Group A và Group B, test type đã định trước, alpha và số permutations.
Dùng 5.000 permutations cho kết quả cuối
SmartPLS mặc định 1.000; tài liệu chính thức gợi ý số lớn hơn như 5.000 để kết quả cuối ổn định hơn.
Đánh giá MICOM trước
Ghi kết luận configural, compositional, partial hoặc full invariance cho từng composite.
Đọc permutation MGA
Báo cáo hệ số nhóm, observed difference, permutation p-value và chiều chênh lệch.
Chạy PLS-MGA khi cần đối chứng
Dùng bootstrap groups và đọc p theo đúng quy tắc của PLS-MGA, không trộn với permutation p.
Lưu settings và output
Ghi phiên bản phần mềm, algorithm, số bootstrap, số permutations, test type, alpha và cách xử lý missing.
7. Phân biệt permutation và PLS-MGA
Permutation hoán đổi quan sát giữa nhóm, giữ cỡ mẫu nhóm và ước lượng lại mô hình để hình thành phân phối chênh lệch. Chọn một phía hay hai phía theo giả thuyết đã định trước; không đổi hướng sau khi xem dấu hệ số. Hair et al. (2018, chương 4) phân biệt cách làm này với so sánh các phân phối bootstrap của PLS-MGA.
Theo quy ước bảng PLS-MGA của SmartPLS, p < 0,05 hoặc p > 0,95 được đánh dấu ở mức 5% (SmartPLS, n.d.-c). Hai đuôi này gắn với cách biểu diễn kiểm định có hướng của thủ tục, không phải quy tắc đọc mọi cột p. Không gọi p = 0,98 là một p hai phía thông thường. Với giả thuyết khác biệt không chỉ hướng, định trước permutation hai phía sẽ giúp cách đọc nhất quán hơn (Hair et al., 2018, chương 4).
Nêu rõ thứ tự A − B và kiểm tra quy ước của cột đang dùng. Độ lớn và dấu của difference cho biết chiều so sánh; p không thay thế hai thông tin này. Parametric test và Welch-Satterthwaite có giả định khác nhau, không chọn thủ tục chỉ vì cho p nhỏ nhất (Sarstedt et al., 2011).
| Thủ tục | Phân phối tham chiếu | Cách đọc cần ghi |
|---|---|---|
| Permutation hai phía | Chênh lệch sau hoán vị nhóm | p hai phía theo alpha đã định |
| PLS-MGA | Ước lượng bootstrap riêng nhóm | Quy ước có hướng; kiểm tra đuôi và thứ tự A/B |
| Parametric / Welch-Satterthwaite | Thống kê và SE theo giả định từng test | Nêu rõ test và giả định, không dùng quy tắc p > 0,95 |
8. Ví dụ số giả định: tác động của niềm tin lên ý định tiếp tục
Ví dụ dưới đây là tình huống minh họa, không phải dữ liệu khách hàng. Giả sử nghiên cứu so sánh người dùng mới và người dùng lâu năm. MICOM xác nhận partial invariance cho Niềm tin và Ý định tiếp tục, nên có thể so sánh path chuẩn hóa giữa hai nhóm.
Hệ số Niềm tin đến Ý định tiếp tục là 0,42 ở nhóm người dùng mới và 0,18 ở nhóm lâu năm. Chênh lệch A - B bằng 0,24. Permutation hai phía với 5.000 lần cho p = 0,022; PLS-MGA cho p = 0,018. Cả hai thủ tục trong ví dụ đều hỗ trợ khác biệt, với quan hệ mạnh hơn ở nhóm người dùng mới.
| Tham số | Nhóm A | Nhóm B | A - B | Permutation p | PLS-MGA p |
|---|---|---|---|---|---|
| Niềm tin -> Ý định tiếp tục | 0,42 | 0,18 | 0,24 | 0,022 | 0,018 |
| Chất lượng -> Niềm tin | 0,55 | 0,49 | 0,06 | 0,438 | 0,401 |
p-value chỉ trả lời mức tương thích với giả thuyết không khác biệt. Kết luận thực tiễn cần xem độ lớn 0,24, khoảng tin cậy, power của từng nhóm và cơ sở lý thuyết của hướng khác biệt.
9. Nhiều nhóm và nhiều paths làm tăng số phép thử
Với g nhóm, số cặp nhóm là g(g − 1)/2. Nếu cùng so h đường dẫn trên tất cả các cặp, số phép thử là h × g(g − 1)/2. Bốn nhóm và ba paths tạo 18 phép thử, không còn là một câu hỏi riêng lẻ ở alpha = 0,05. Hair et al. (2018, chương 4) giải thích vì sao tìm nhiều cặp làm tăng nguy cơ phát hiện ngẫu nhiên.
Chốt họ giả thuyết và các so sánh cần thiết trước khi chạy. Nếu cần hỏi có ít nhất một nhóm khác hay không, cần một kiểm định tổng thể thích hợp; một loạt kiểm định đôi chưa điều chỉnh không tự trở thành omnibus test. Không chạy ANOVA thông thường trên danh sách hệ số bootstrap rồi coi mỗi lần bootstrap là một người tham gia độc lập (Hair et al., 2018, chương 4).
Chương sách trình bày cả kiểm định tổng thể và các cách điều chỉnh so sánh đôi. Cần kiểm tra công cụ thực tế hỗ trợ thủ tục nào; không suy menu SmartPLS hiện hành từ giao diện cũ trong sách. Khi báo cáo pairwise, giữ toàn bộ họ phép thử, p gốc và quy tắc điều chỉnh, kể cả kết quả không thuận lợi.
10. Ví dụ tự biên soạn: kết luận thay đổi sau điều chỉnh Holm
Giả sử ba giả thuyết chênh lệch đường dẫn đã được xác định thành cùng một họ kiểm định, dùng permutation hai phía. Các p minh họa là 0,012; 0,026 và 0,210. Đây là đầu vào đặt sẵn để luyện báo cáo, không phải p được suy từ ba cặp beta. Hàm p.adjust của R triển khai điều chỉnh Holm để kiểm soát sai số gia đình (R Core Team, n.d.).
Sau điều chỉnh, p lần lượt là 0,036; 0,052 và 0,210. Ở alpha = 0,05, giả thuyết thứ hai không còn đáp ứng tiêu chí trong họ này. Không chỉ đưa những p đã nhỏ hơn 0,05 vào hàm; như vậy sẽ thay đổi họ kiểm định sau khi nhìn kết quả. Ví dụ dùng p hai phía, không đưa trực tiếp cột PLS-MGA có hướng vào cùng quy trình.
| So sánh định trước | Permutation p | Holm p | Đọc ở alpha = 0,05 |
|---|---|---|---|
| Path 1, A − B | 0,012 | 0,036 | Còn đáp ứng tiêu chí |
| Path 2, A − B | 0,026 | 0,052 | Chưa đáp ứng sau điều chỉnh |
| Path 3, A − B | 0,210 | 0,210 | Chưa đáp ứng tiêu chí |
# Constructed two-sided permutation p-values for one planned family.
p <- c(path1 = 0.012, path2 = 0.026, path3 = 0.210)
result <- data.frame(raw_p = p, holm_p = p.adjust(p, method = "holm"))
print(result)
stopifnot(isTRUE(all.equal(unname(result$holm_p), c(0.036, 0.052, 0.210))))
choose(4, 2) * 3 # 18 pairwise path tests across four groups
0.42 - 0.18      # 0.24, difference in the earlier constructed example
11. Nhóm lệch cỡ mẫu và kiểm tra độ vững
Tổng mẫu lớn không làm sai số chuẩn của nhóm nhỏ biến mất. Báo số quan sát thực dùng, chất lượng đo lường, nghiệm ước lượng và độ bất định cho từng nhóm. Hair et al. (2018, chương 4) lưu ý chênh lệch cỡ mẫu lớn có thể ảnh hưởng tính năng kiểm định; đây là lý do thiết kế và kiểm tra độ nhạy, không phải mệnh lệnh tự động bỏ quan sát nhóm lớn.
Không đạt ý nghĩa thống kê chưa phải bằng chứng hai nhóm tương đương. Xem độ lớn chênh lệch và khoảng bất định khi thủ tục cung cấp; ghi rõ khác biệt tối thiểu có ý nghĩa trong bối cảnh nghiên cứu. Nếu thử đặc tả hoặc quy tắc mẫu khác, giữ câu hỏi và họ kiểm định nhất quán, báo cả phân tích chính lẫn độ nhạy.
Nhóm được khám phá bằng FIMIX/PLS-POS từ chính dữ liệu cần được mô tả là khám phá. Không xem một MGA tiếp theo trên cùng bộ dữ liệu là xác nhận độc lập rằng đã tìm được các phân khúc thị trường ổn định. Kết luận cần được đối chiếu với nội dung nhóm và bằng chứng ngoài quy trình phân đoạn (Hair et al., 2018, chương 5).
12. Các lỗi thường gặp khi so sánh nhóm
| Cách làm yếu | Vấn đề | Cách xử lý |
|---|---|---|
| p_A < 0,05 còn p_B > 0,05 nên hai nhóm khác nhau | Không kiểm định trực tiếp difference | Dùng permutation hoặc PLS-MGA |
| Bỏ qua MICOM | Khác biệt có thể do measurement artifact | Báo cáo ba bước invariance trước MGA |
| Chia median một biến liên tục | Mất thông tin và power | Dùng moderation liên tục nếu phù hợp giả thuyết |
| Dùng cỡ mẫu tổng để biện minh | Nhóm nhỏ có thể thiếu power | Đánh giá từng nhóm và tham số mục tiêu |
| Chạy nhiều paths rồi chọn p nhỏ | Tăng rủi ro phát hiện ngẫu nhiên | Định trước so sánh và điều chỉnh khi cần |
| Gọi mọi p-value là PLS-MGA | Che giấu khác biệt thủ tục | Nêu đúng permutation, PLS-MGA hoặc parametric test |
13. Mẫu báo cáo APA 7 và bảng kiểm hoàn tất
Mẫu báo cáo cần nối bằng chứng MICOM với phép kiểm định chênh lệch thực sự được sử dụng. Nêu phạm vi composite có thể so sánh, thứ tự A/B và họ giả thuyết; nếu báo nhiều thủ tục, tách riêng cách đọc từng cột (Hair et al., 2018, chương 4; Sarstedt et al., 2011).
Mẫu báo cáo tiếng Việt
MICOM được thực hiện với [số] hoán vị trong SmartPLS 4 (Ringle et al., 2024). Cấu hình được đối chiếu qua [hồ sơ]. Compositional invariance được hỗ trợ cho [danh sách], nhưng chưa hỗ trợ cho [danh sách]; phạm vi MGA là [nêu rõ]. Hệ số X → Y là beta = [ ] ở nhóm A (n = [ ]) và beta = [ ] ở nhóm B (n = [ ]), chênh lệch A − B = [ ]. Kiểm định [tên, một/hai phía] cho p gốc = [ ]. Trong họ [số] giả thuyết định trước, [quy tắc điều chỉnh hoặc lý do không điều chỉnh] cho p báo cáo = [ ]. Kết quả được diễn giải cùng độ lớn, độ bất định và giới hạn cỡ mẫu. Nếu trình bày PLS-MGA bổ sung, quy ước có hướng được ghi riêng.
- Nêu cơ sở hình thành nhóm và mã tham chiếu.
- Báo cỡ mẫu, missing và chất lượng mô hình từng nhóm.
- Xác nhận bước 1 bằng hồ sơ, giữ kết quả bước 2 cho từng composite.
- Phân biệt partial/full và phạm vi chưa hỗ trợ bất biến.
- Nêu số permutations, bootstrap, test type, alpha và seed nếu có.
- Báo hệ số từng nhóm và chiều A − B.
- Phân biệt p có hướng của PLS-MGA với p hai phía.
- Giữ đủ họ phép thử, p gốc và quy tắc điều chỉnh.
- Không suy khác biệt chỉ từ p riêng của hai nhóm.
- Thảo luận độ lớn, độ bất định, power và độ vững.
Kết luận
PLS-MGA có giá trị khi khác biệt nhóm được đặt thành câu hỏi nghiên cứu trước khi phân tích. Nhóm phải có ý nghĩa, từng mô hình phải đạt yêu cầu và MICOM phải cho biết các composite có được hình thành tương đương hay không.
Kết luận cuối cùng dựa trên kiểm định trực tiếp difference, không dựa trên việc một nhóm có p nhỏ còn nhóm kia có p lớn. Báo cáo tốt cho người đọc thấy hệ số từng nhóm, độ chênh, tên thủ tục, p-value, điều kiện invariance và giới hạn của cỡ mẫu.
Tài liệu tham khảo
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2016). Testing measurement invariance of composites using partial least squares. International Marketing Review, 33(3), 405-431. https://doi.org/10.1108/IMR-09-2014-0304
- Sarstedt, M., Henseler, J., & Ringle, C. M. (2011). Multigroup analysis in partial least squares (PLS) path modeling: Alternative methods and empirical results. In M. Sarstedt, M. Schwaiger, & C. R. Taylor (Eds.), Measurement and research methods in international marketing (Vol. 22, pp. 195-218). Emerald. https://doi.org/10.1108/S1474-7979(2011)0000022012
- Ringle, C. M., Wende, S., & Becker, J.-M. (2024). SmartPLS 4 [Computer software]. SmartPLS. https://www.smartpls.com
- SmartPLS. (n.d.-a). Measurement invariance assessment (MICOM). https://smartpls.com/documentation/algorithms-and-techniques/heterogeneity-and-multigroup/micom/
- SmartPLS. (n.d.-b). Permutation testing for PLS-SEM multigroup analysis. https://www.smartpls.com/documentation/algorithms-and-techniques/resampling-and-inference/permutation/
- Hair, J. F., Sarstedt, M., Ringle, C. M., & Gudergan, S. P. (2018). Advanced issues in partial least squares structural equation modeling. SAGE. https://us.sagepub.com/en-us/nam/advanced-issues-in-partial-least-squares-structural-equation-modeling/book243803
- SmartPLS. (n.d.-c). Multigroup analysis (MGA) in PLS-SEM with SmartPLS. https://smartpls.com/documentation/algorithms-and-techniques/heterogeneity-and-multigroup/multigroup-analysis/
- R Core Team. (n.d.). p.adjust: Adjust p-values for multiple comparisons. R documentation, stats package. https://stat.ethz.ch/R-manual/R-devel/library/stats/html/p.adjust.html
Ghi chú học thuật: Các số trong ví dụ được tạo để minh họa cách đọc output. Kết luận MGA thực tế phụ thuộc measurement invariance, cách tạo nhóm, cỡ mẫu, power, thuật toán ước lượng và giả thuyết đã định trước.