
Modification Indices trong AMOS: chẩn đoán sai đặc tả mà không chạy theo độ phù hợp
Modification Index không phải danh sách lệnh sửa mô hình. Nó là chẩn đoán cục bộ về một tham số đang bị cố định, và chỉ đáng dùng khi tham số đó có ý nghĩa lý thuyết, độ lớn thực tiễn và khả năng được xác nhận trên dữ liệu khác.
Quy trình an toàn gồm kiểm tra nghiệm và residuals, đọc MI cùng expected parameter change, xác định loại sai đặc tả, xem nội dung biến, giải phóng tối đa một tham số mỗi lần, chạy lại toàn bộ mô hình và ghi rõ mọi thay đổi hậu nghiệm.
1. Mục tiêu học tập và điều kiện trước khi xem MI
Sau chuyên đề này, bạn cần giải thích được MI đo điều gì, lấy đúng bảng trong AMOS, phân biệt residual covariance, cross-loading và structural path, đọc MI cùng Parameter Change, rồi quyết định giữ nguyên hay sửa mô hình bằng một nhật ký có thể kiểm tra.
Chỉ xem MI sau khi mô hình đã định danh, ước lượng hội tụ và không có nghiệm không thích hợp. Nếu dữ liệu sai mã, mẫu quá nhỏ, phân phối vi phạm nghiêm trọng hoặc mô hình lý thuyết ban đầu mơ hồ, MI không thể sửa nguyên nhân gốc (Brown, 2015).
- Mô hình có cơ sở lý thuyết được chốt trước khi chạy.
- Không có lỗi định danh, phương sai âm hoặc tải bất khả thi.
- Đã xem độ phù hợp tổng thể và standardized residuals.
- Đã kiểm tra nội dung từng item và chiều mã hóa.
- Đã lưu bản mô hình gốc trước mọi thay đổi.
- Có kế hoạch xác nhận mô hình đã sửa trên mẫu khác hoặc phân tích độ nhạy.
2. Modification Index thực sự đo điều gì?
MI là một thống kê score test cho tham số hiện đang bị cố định, thường là 0. Trong điều kiện xấp xỉ phù hợp, MI dự báo mức giảm của chi-square nếu chỉ tham số đó được giải phóng và mô hình được ước lượng lại (Sörbom, 1989). MI lớn cho biết một ràng buộc có thể không phù hợp với dữ liệu, nhưng chưa cho biết thay đổi có đúng về nội dung hay không.
Mỗi MI là chẩn đoán cục bộ, có điều kiện theo toàn bộ mô hình hiện tại. Sau khi giải phóng một tham số, các MI còn lại có thể thay đổi mạnh. Vì vậy, không cộng nhiều MI để dự báo độ phù hợp của một loạt thay đổi và không giải phóng đồng thời mọi dòng đứng đầu bảng.
Ngưỡng 3,84 đôi khi được dùng vì liên hệ với kiểm định chi-square một bậc tự do ở mức 0,05. Đây không phải quy tắc chọn tham số. Cả MI và kiểm định chi-square sai biệt đều nhạy với cỡ mẫu: khi n lớn, một sai đặc tả nhỏ vẫn có thể tạo thống kê có ý nghĩa. Vì vậy, phải đọc MI cùng EPC, residuals và ý nghĩa nội dung thay vì chỉ nhìn p-value (Kline, 2023). Bảng MI thường chứa nhiều phép kiểm tra, nên việc quét hàng chục hoặc hàng trăm dòng làm tăng nguy cơ sửa theo nhiễu mẫu.
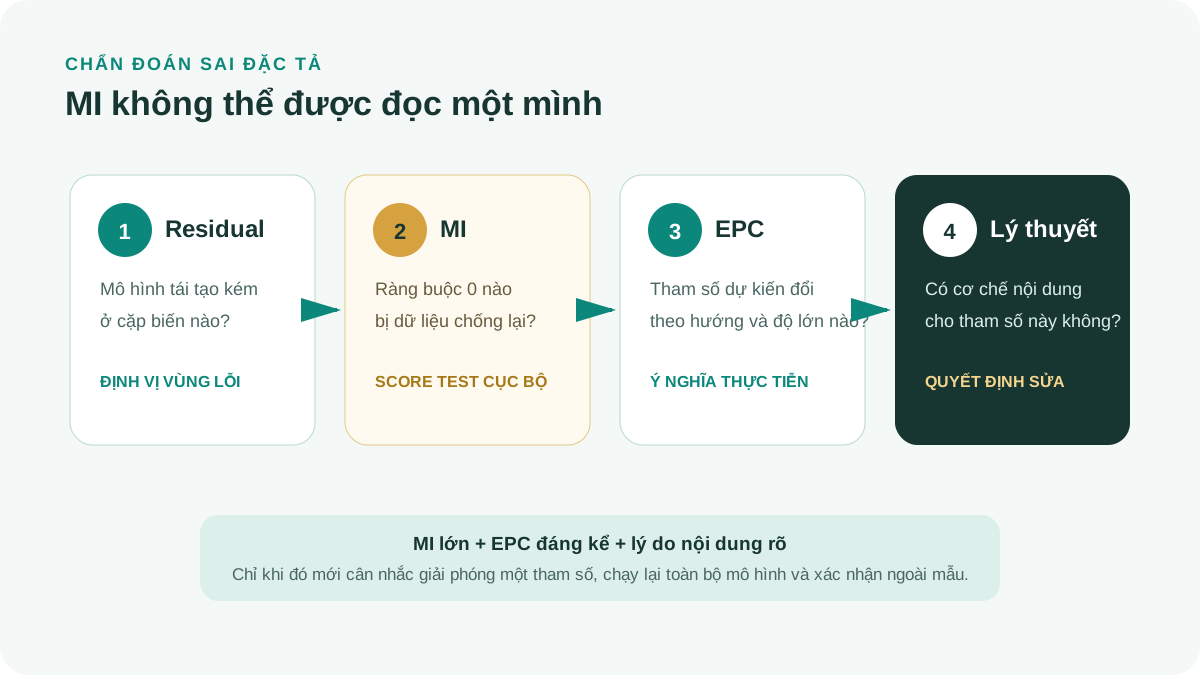
Một MI lớn có thể phản ánh tải chéo, nội dung item giống nhau, wording effect, biến bị bỏ sót, nhóm mẫu trộn lẫn hoặc một ràng buộc sai. Chỉ dữ liệu không thể chọn thay lý thuyết giữa các nguyên nhân này.
3. Đọc MI cùng Expected Parameter Change
MI chủ yếu phản ánh bằng chứng thống kê chống lại ràng buộc đang có. Expected Parameter Change (EPC), trong AMOS thường xuất hiện dưới tên Par Change, dự báo độ lớn và chiều của tham số nếu được giải phóng. Hai dòng có MI gần nhau có thể có EPC rất khác, nên mức ưu tiên thực tiễn cũng khác.
EPC chưa chuẩn hóa phụ thuộc thang đo. Standardized Expected Parameter Change (SEPC) thuận tiện hơn để so độ lớn giữa các loại tham số. Whittaker (2012) cho thấy EPC chuẩn hóa có thể cung cấp thông tin chọn tham số hữu ích hơn việc chỉ xếp hạng MI.
Nếu MI lớn nhưng EPC rất nhỏ, thay đổi có thể cải thiện chi-square do cỡ mẫu mà không có ý nghĩa thực tiễn. Nếu MI và EPC đều đáng kể nhưng tham số mâu thuẫn lý thuyết, lựa chọn phù hợp vẫn có thể là giữ nguyên mô hình và thảo luận sai lệch.
| MI | EPC hoặc SEPC | Cơ sở nội dung | Quyết định sơ bộ |
|---|---|---|---|
| Nhỏ | Nhỏ | Có hoặc không | Không ưu tiên sửa |
| Lớn | Nhỏ | Yếu | Khả năng hiệu ứng cỡ mẫu; giữ nguyên |
| Lớn | Đáng kể | Mạnh | Xem xét một thay đổi và chạy lại |
| Lớn | Đáng kể | Không có | Không giải phóng chỉ để cải thiện fit |
| Vừa | Đáng kể | Mạnh | Kiểm tra residual, wording và độ ổn định |
4. Bật và đọc Modification Indices trong AMOS
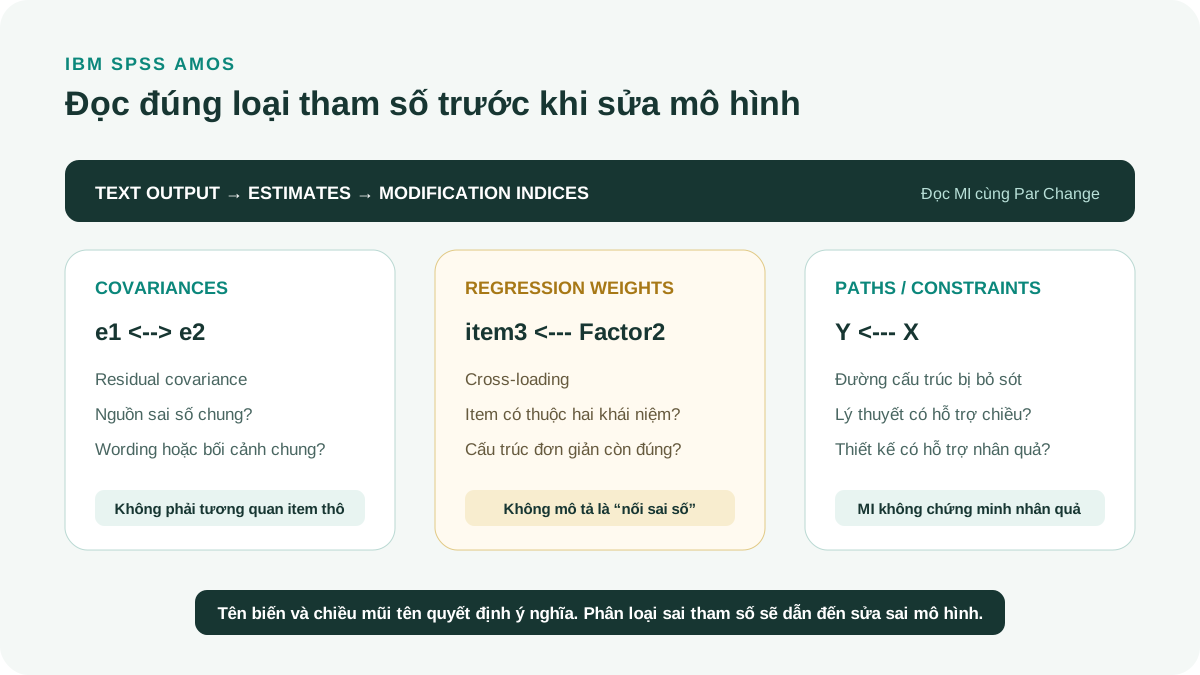
Trong IBM SPSS Amos 29 Graphics, mở Analysis Properties, chọn tab Output, đánh dấu Modification indices và nhập ngưỡng hiển thị nếu cần. Sau khi ước lượng, mở Text Output và tìm Modification Indices. IBM Corp. (2022) mô tả quy trình bật bảng này trong hướng dẫn AMOS 29.
AMOS chia bảng theo covariances, variances và regression weights. Với CFA, đề xuất thường gặp gồm tương quan giữa sai số và tải chéo của một chỉ báo lên nhân tố khác. Với mô hình cấu trúc, bảng có thể đề xuất đường hồi quy bị bỏ sót.
Đọc tên biến rất cẩn thận. Dòng e1 <-> e2 là residual covariance, không phải tương quan giữa hai item quan sát. Dòng item3 <--- Factor2 là cross-loading. Hai thay đổi này có ý nghĩa đo lường khác nhau và không được mô tả chung là nối thêm mũi tên.
Lưu mô hình gốc
Tạo bản sao có ngày và tên phiên bản trước khi bật MI.
Bật Modification indices
Trong Analysis Properties > Output, chọn MI và giữ cả Standardized estimates cùng Residual moments.
Chạy mô hình không sửa
Lưu fit indices, residuals, tải, tương quan và cảnh báo của mô hình ban đầu.
Phân loại từng đề xuất
Đánh dấu dòng là residual covariance, cross-loading, structural path hay constraint khác.
Đọc MI cùng Par Change
Ghi cả độ lớn, dấu và đơn vị của thay đổi dự kiến.
Đối chiếu nội dung biến
Mở lại wording, quy trình thu thập và lý thuyết trước khi quyết định.
5. Từ một MI lớn đến giả thuyết về sai đặc tả
Residual covariance lớn có thể xuất hiện khi hai item dùng câu chữ gần giống, cùng ví dụ, cùng cách đảo chiều hoặc một nguồn phương pháp chưa được mô hình hóa. Cho phép sai số tương quan chỉ hợp lý khi có cơ chế chung cụ thể ngoài nhân tố chính.
Cross-loading lớn gợi ý item có thể đo thêm một nhân tố khác. Trước khi thêm tải chéo, cần kiểm tra wording và định nghĩa khái niệm. Nếu item thực sự đa nghĩa, sửa hoặc loại item trong nghiên cứu tiếp theo có thể rõ ràng hơn việc giữ một mô hình khó diễn giải.
Structural path lớn có thể gợi ý biến bị bỏ sót, quan hệ trực tiếp ngoài trung gian hoặc thứ tự nhân quả chưa phù hợp. Dữ liệu cắt ngang không tự xác định chiều nhân quả, nên thêm đường dẫn phải bắt đầu từ lý thuyết và thiết kế nghiên cứu.
Variance hoặc covariance MI bất thường đôi khi báo hiệu ràng buộc bằng nhau không phù hợp, đặc biệt trong mô hình đa nhóm. Khi đó cần kiểm tra mục tiêu invariance thay vì giải phóng ngẫu nhiên từng tham số.
| Dòng MI | Giả thuyết chẩn đoán | Câu hỏi cần trả lời | Rủi ro nếu sửa cơ học |
|---|---|---|---|
| e1 <-> e2 | Nguồn sai số chung | Hai item có wording hoặc bối cảnh chung không? | Che tải chéo hoặc nhân tố phương pháp |
| item <--- factor khác | Tải chéo | Nội dung item có thuộc hai khái niệm không? | Làm mất tính đơn giản của CFA |
| Y <--- X | Đường cấu trúc bị bỏ sót | Lý thuyết và thời gian đo có hỗ trợ chiều này không? | Hợp thức hóa quan hệ hậu nghiệm |
| constraint bằng nhau | Không bất biến hoặc khác tham số | Ràng buộc nào đang được kiểm định? | Mất ý nghĩa so sánh nhóm |
6. Quy trình sửa mô hình có kiểm soát
Specification search dựa vào dữ liệu có thể tạo mô hình phù hợp với mẫu hiện tại nhưng khó lặp lại. MacCallum (1986) cảnh báo rằng mô hình sinh ra từ quá trình tìm kiếm cần được xem là hậu nghiệm. Vì vậy, mục tiêu không phải đạt chỉ số đẹp nhất mà là xác định một sai đặc tả có thể giải thích và xác nhận.
Mỗi vòng chỉ nên giải phóng một tham số đã được duyệt về lý thuyết. Sau đó ước lượng lại toàn bộ mô hình, kiểm tra nghiệm, fit, residuals, tải, tương quan và MI mới. Nếu thay đổi tạo hệ số bất thường hoặc làm yếu ý nghĩa khái niệm, hãy quay lại mô hình trước.
Xác nhận mô hình ban đầu
Kiểm tra identification, convergence, Heywood cases, fit và residuals trước MI.
Chọn vùng sai lệch
Dùng standardized residuals để xác định cặp biến hoặc phần mô hình đang tái tạo covariance kém.
Lập danh sách MI có liên quan
Chỉ giữ các đề xuất nằm trong vùng sai lệch và có thể giải thích về nội dung.
Đọc EPC hoặc Par Change
Loại các thay đổi có độ lớn quá nhỏ hoặc dấu vô lý.
Viết lý do trước khi sửa
Ghi một câu nêu cơ chế tạo tham số và tài liệu hoặc wording hỗ trợ.
Giải phóng một tham số
Tạo phiên bản mô hình mới, không ghi đè bản ban đầu.
Ước lượng lại toàn bộ
Kiểm tra mọi tham số, fit và residuals; không chỉ nhìn chi-square giảm.
Xác nhận độ ổn định
Ưu tiên holdout sample, cross-validation hoặc một mẫu độc lập; nếu chưa có, ghi rõ tính khám phá.
Nếu đề xuất tiếp theo chỉ được biện minh bằng MI lớn hoặc mong muốn đạt một cutoff, quy trình nên dừng. Fit tốt hơn không bù được một mô hình không còn diễn giải nhất quán.
7. Ví dụ số giả định: hai item có wording gần nhau
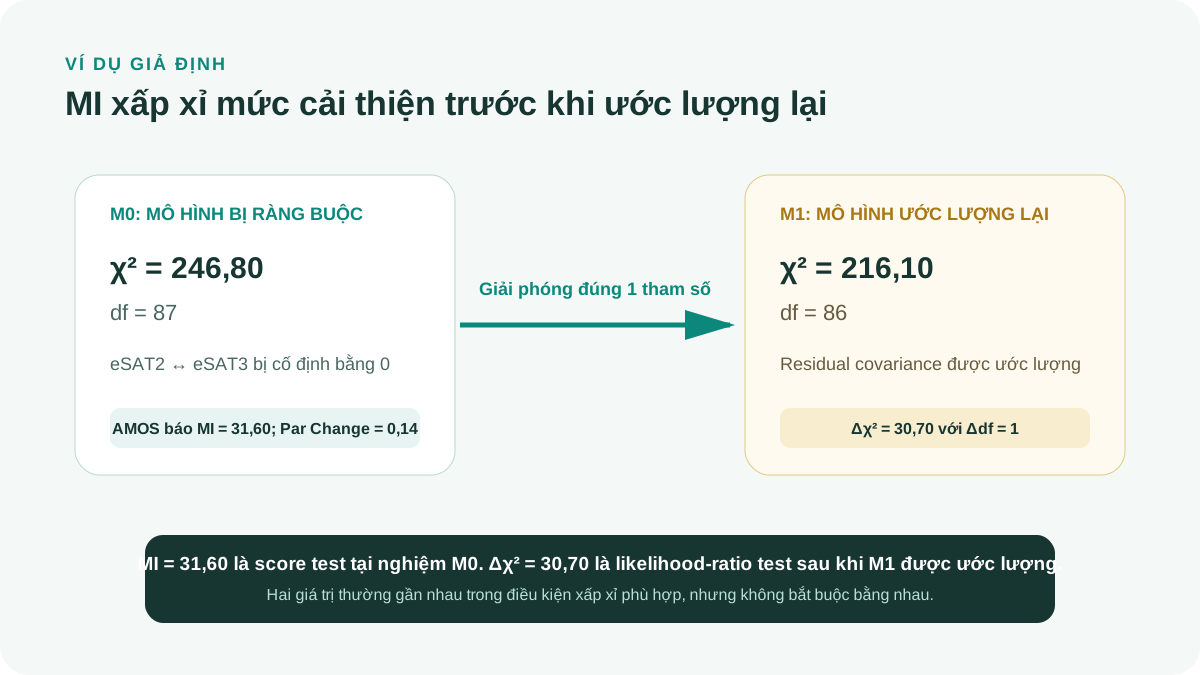
Ví dụ dưới đây là tình huống minh họa, không phải dữ liệu nghiên cứu thật. Mô hình CFA ba nhân tố có chi-square = 246,80 với df = 87. Standardized residual giữa SAT2 và SAT3 là 0,19. AMOS báo MI = 31,60 cho eSAT2 <-> eSAT3 và Par Change = 0,14.
Hai item đều bắt đầu bằng cùng một cụm từ, dùng cùng ví dụ dịch vụ và được đặt liền nhau trong bảng hỏi. Nhóm nghiên cứu đã dự kiến wording effect trong nhật ký thiết kế, nên residual covariance có cơ sở nội dung. Sau khi giải phóng đúng một covariance, chi-square giảm còn 216,10 với df = 86. Vì M1 lồng trong M0 và chỉ giải phóng thêm một tham số, Δχ² = 246,80 - 216,10 = 30,70 với Δdf = 1 chính là kiểm định chi-square sai biệt theo likelihood-ratio cho hai mô hình lồng nhau.
MI là score test, còn Δχ² là likelihood-ratio test sau khi mô hình được ước lượng lại. Cả hai có phân phối tiệm cận chi-square với một bậc tự do trong ví dụ này, nhưng MI chỉ dùng thông tin tại nghiệm bị ràng buộc để xấp xỉ mức cải thiện. Δχ² dùng hai nghiệm đã ước lượng đầy đủ. Vì vậy, MI = 31,60 gần nhưng không bắt buộc bằng mức giảm thực tế 30,70 (Sörbom, 1989; Kline, 2023).
Nếu không có bằng chứng wording chung, cùng con số MI không đủ để nối hai sai số. Một giải thích thay thế là hai item tải chéo hoặc thang đo bỏ sót một tiểu chiều.
| Phiên bản | Thay đổi | chi-square | df | Lý do | Trạng thái |
|---|---|---|---|---|---|
| M0 | Không sửa | 246,80 | 87 | Mô hình giả thuyết | Giữ làm mốc |
| M1 | eSAT2 <-> eSAT3 | 216,10 | 86 | Wording và ví dụ chung | Cần xác nhận |
| M2 | Thêm nhiều covariance theo MI | Không chạy | Không có lý do nội dung | Loại |
8. Ba trường hợp cần xử lý khác nhau
Với residual covariance, báo cáo nguồn phương pháp chung và giữ tương quan ở mức cục bộ. Không nên nối một chuỗi sai số chỉ vì các item thuộc cùng nhân tố, vì khi đó nhân tố chung đã giải thích phần đồng biến chính.
Với cross-loading, hãy cân nhắc mô hình đo lường thay thế, wording, ESEM hoặc sửa item trong nghiên cứu tiếp theo. Thêm tải chéo có thể phù hợp hơn loại item, nhưng phải chấp nhận rằng cấu trúc đơn giản ban đầu không còn đúng.
Với structural path, so sánh mô hình thay thế chỉ hợp lệ khi mỗi mô hình có logic nhân quả rõ. MI không chứng minh biến X gây ra Y. Với dữ liệu cắt ngang, chiều đường dẫn vẫn phụ thuộc thiết kế và lý thuyết.
Saris và cộng sự (2009) nhấn mạnh việc phát hiện sai đặc tả cục bộ thay vì chỉ dựa vào độ phù hợp chung. Một mô hình có fit toàn cục chấp nhận được vẫn có thể chứa tham số sai quan trọng, còn một MI lớn không tự động làm mô hình tổng thể vô giá trị.
Residuals cho biết mô hình tái tạo kém ở đâu. MI gợi ý ràng buộc nào có thể liên quan. EPC cho biết thay đổi dự kiến lớn bao nhiêu. Lý thuyết quyết định thay đổi đó có được phép hay không.
9. Từ local fit đến khả năng lặp lại ngoài mẫu
Global fit cho biết mức chênh lệch tổng thể giữa mô hình và dữ liệu, còn standardized residuals và MI chỉ ra nơi chênh lệch tập trung. Một mô hình có fit tổng thể chấp nhận được vẫn có thể chứa residual lớn ở đúng cặp biến quan trọng. Ngược lại, giảm một MI lớn chưa chắc sửa được toàn bộ cấu trúc sai đặc tả.
Kline (2023) nhấn mạnh rằng mô hình CFA đã sửa trên cùng dữ liệu chuyển dần từ xác nhận sang khám phá. MacCallum, Roznowski và Necowitz (1992) kiểm tra specification search trên các mẫu lặp và cho thấy những thay đổi được chọn có thể thiếu nhất quán, còn kết quả cross-validation có thể biến động mạnh. Mọi đường được thêm sau khi xem MI vì vậy phải được xem là giả thuyết mới, không phải cấu trúc đã xác nhận. Bằng chứng mạnh nhất là kiểm tra mô hình sửa đổi trên mẫu độc lập; nếu chưa có, có thể dùng holdout sample hoặc ít nhất báo cáo rõ giới hạn chưa xác nhận.
Không nên dùng MI để tạo lập luận nhân quả. Một đường cấu trúc được đề xuất bởi MI chỉ cho thấy ràng buộc 0 không phù hợp cục bộ với covariance hiện tại. Hướng nhân quả vẫn cần thiết kế nghiên cứu, thứ tự thời gian, giả định không nhiễu và lý thuyết.
| Bằng chứng | Vai trò | Giới hạn |
|---|---|---|
| Standardized residual | Định vị covariance mô hình dự báo chưa tốt | Không chỉ rõ tham số duy nhất cần thêm |
| MI | Score test cho một ràng buộc đang cố định | Phụ thuộc mô hình và có nhiều phép kiểm tra |
| EPC hoặc SEPC | Ước lượng hướng và độ lớn thay đổi | Có thể không chính xác khi mô hình sai mạnh |
| Mẫu độc lập | Kiểm tra khả năng lặp lại của mô hình sửa | Cần đủ cỡ mẫu và cùng quần thể mục tiêu |
10. Mẫu nhật ký quyết định cho từng vòng sửa mô hình
Nhật ký quyết định biến specification search thành quy trình có thể kiểm tra. Mỗi dòng ghi mô hình trước thay đổi, nguồn tín hiệu, tham số được cân nhắc, lý do nội dung, dự báo ảnh hưởng, quyết định và kết quả sau khi chạy lại.
MacCallum (1986) cảnh báo rằng tìm kiếm đặc tả dựa trên dữ liệu có thể tận dụng nhiễu mẫu. Vì vậy, nhật ký cũng phải ghi các thay đổi đã xem nhưng từ chối. Điều này giúp ngăn câu chuyện hậu nghiệm, nơi chỉ những quyết định cho fit đẹp được kể lại.
| Cột | Ví dụ giá trị |
|---|---|
| Phiên bản | M2 sau khi cho e3 tương quan e4 |
| Tín hiệu | Residual = .18; MI = 24.6; Par Change = .31 |
| Căn cứ nội dung | Hai item dùng cùng một tình huống và cách diễn đạt |
| Quyết định | Chấp nhận có điều kiện |
| Kết quả sau chạy | Giảm chi-square, tải ổn định, không có Heywood case |
| Xác nhận | Sẽ kiểm tra trên holdout 40% |
Bước 1
Đặt mã phiên bản M0 cho mô hình giả thuyết và lưu output gốc.
Bước 2
Ghi standardized residual, MI, EPC và loại tham số cho tín hiệu đang xem.
Bước 3
Viết lý do nội dung trước khi mở đường hoặc cho sai số tương quan.
Bước 4
Ghi quyết định chấp nhận hoặc từ chối, kể cả khi không sửa mô hình.
Bước 5
Nếu chấp nhận, chỉ thay đổi một tham số và lưu thành phiên bản mới.
Bước 6
Chạy lại toàn bộ mô hình, kiểm tra nghiệm, fit, tham số trọng tâm và MI mới.
Bước 7
So sánh mô hình mới với mô hình trước về df, chi-square và ý nghĩa cấu trúc.
Bước 8
Đánh dấu thay đổi là hậu nghiệm và xác định cách kiểm tra trên dữ liệu khác.
11. Các lỗi làm mô hình đẹp nhưng khó bảo vệ
| Cách làm yếu | Vấn đề | Cách xử lý |
|---|---|---|
| Nối tất cả sai số MI > 10 | Không có cơ chế nội dung và làm tăng overfit | Chỉ sửa từng tham số có lý do |
| Chọn dòng MI lớn nhất bất kể loại | Cross-loading và residual covariance khác ý nghĩa | Phân loại tham số trước |
| Chỉ báo cáo mô hình cuối | Che quá trình tìm kiếm hậu nghiệm | Báo cáo mô hình gốc và nhật ký thay đổi |
| Xem MI như bằng chứng nhân quả | MI chỉ là chẩn đoán thống kê cục bộ | Dùng lý thuyết và thiết kế để quyết định chiều |
| Không đọc EPC | MI lớn có thể đi cùng thay đổi rất nhỏ | Đọc MI và Par Change cùng nhau |
| Sửa nhiều tham số một lượt | Mỗi MI thay đổi sau mỗi lần ước lượng | Một thay đổi, một lần chạy lại |
| Dùng cùng mẫu để khám phá và xác nhận | Đánh giá quá lạc quan | Xác nhận trên holdout hoặc mẫu độc lập |
12. Mẫu báo cáo APA 7 và bảng kiểm cuối
Mọi thay đổi dựa trên MI là hậu nghiệm và cần được gọi đúng tên. Báo cáo nên cho phép người đọc tái tạo thứ tự quyết định, không chỉ nhìn mô hình cuối cùng.
Mẫu báo cáo tiếng Việt
Mô hình giả thuyết ban đầu được ước lượng bằng IBM SPSS Amos [phiên bản], chi-square([df]) = [ ], p = [ ], [các chỉ số fit]. Standardized residuals và Modification Indices được dùng để chẩn đoán sai đặc tả cục bộ. Một residual covariance giữa [item A] và [item B] được giải phóng vì hai item [lý do nội dung]; MI = [ ] và expected parameter change = [ ]. Mô hình sửa đổi có chi-square([df]) = [ ] và [các chỉ số fit]. Không có tham số nào khác được giải phóng khi thiếu cơ sở lý thuyết. Thay đổi này được xem là hậu nghiệm và [đã/chưa] được xác nhận trên [holdout/mẫu độc lập].
- Đã lưu và báo cáo mô hình giả thuyết ban đầu.
- Đã kiểm tra residuals trước khi đọc MI.
- Đã ghi MI cùng EPC hoặc Par Change.
- Đã phân loại đúng residual covariance, cross-loading và path.
- Đã viết lý do nội dung trước khi sửa.
- Mỗi vòng chỉ giải phóng một tham số.
- Đã chạy lại toàn bộ mô hình và kiểm tra nghiệm.
- Đã đánh giá ảnh hưởng đến ý nghĩa cấu trúc.
- Đã ghi rõ thay đổi là hậu nghiệm.
- Đã xác nhận trên dữ liệu khác hoặc nêu giới hạn chưa xác nhận.
Kết luận
Modification Indices hữu ích khi được dùng như công cụ chẩn đoán cục bộ cùng residuals và expected parameter change. Chúng không thay thế mô hình lý thuyết và không biến một specification search thành phân tích xác nhận.
Một mô hình đáng tin không phải mô hình có nhiều đường nối nhất và fit đẹp nhất. Đó là mô hình giữ được ý nghĩa đo lường, công khai mọi thay đổi hậu nghiệm và cho thấy kết quả có khả năng lặp lại ngoài mẫu đã dùng để sửa.
Tài liệu tham khảo
- Sörbom, D. (1989). Model modification. Psychometrika, 54(3), 371-384. https://doi.org/10.1007/BF02294623
- MacCallum, R. C. (1986). Specification searches in covariance structure modeling. Psychological Bulletin, 100(1), 107-120. https://doi.org/10.1037/0033-2909.100.1.107
- MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490-504. https://doi.org/10.1037/0033-2909.111.3.490
- Whittaker, T. A. (2012). Using the modification index and standardized expected parameter change for model modification. The Journal of Experimental Education, 80(1), 26-44. https://doi.org/10.1080/00220973.2010.531299
- Saris, W. E., Satorra, A., & van der Veld, W. M. (2009). Testing structural equation models or detection of misspecifications? Structural Equation Modeling, 16(4), 561-582. https://doi.org/10.1080/10705510903203433
- Brown, T. A. (2015). Confirmatory factor analysis for applied research (2nd ed.). Guilford Press. https://www.guilford.com/books/Confirmatory-Factor-Analysis-for-Applied-Research/Timothy-Brown/9781462515363
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
- IBM Corp. (2022). IBM SPSS Amos 29 user's guide. https://www.ibm.com/docs/en/SSLVMB_29.0.0/pdf/IBM_SPSS_Amos_User_Guide.pdf
Ghi chú học thuật: Ví dụ số trong bài được tạo để minh họa quy trình. Modification Index phụ thuộc mô hình và mẫu hiện tại; mọi sửa đổi cần được xem là hậu nghiệm cho đến khi được xác nhận bằng dữ liệu khác.