
Kiểm tra phân phối chuẩn bằng SPSS và AMOS trước CFA hoặc SEM
Kiểm tra chuẩn không phải thủ tục tìm một giá trị p lớn hơn 0,05. Mục tiêu là nhận diện dạng vi phạm, dự đoán thành phần suy luận có thể bị ảnh hưởng và chọn estimator hoặc phân tích độ nhạy phù hợp.
Quy trình đầy đủ kết hợp biểu đồ và mô tả đơn biến trong SPSS, kurtosis đa biến và Mahalanobis distance trong AMOS, kiểm tra hồ sơ trường hợp bất thường, rồi lập quyết định về ML, bootstrap Bollen-Stine hoặc estimator robust. Chuẩn đơn biến, chuẩn đa biến và ngoại lệ là ba vấn đề liên quan nhưng không đồng nhất.
1. Mục tiêu học tập và dữ liệu đầu vào
Sau chuyên đề này, bạn cần phân biệt chuẩn đơn biến với chuẩn đa biến, đọc đúng bảng Tests for normality and outliers của AMOS, truy vết các trường hợp có Mahalanobis distance lớn và chọn chiến lược ước lượng có thể bảo vệ. Kết quả cuối không chỉ là đạt hay không đạt mà là một hồ sơ chẩn đoán có quyết định và lý do.
Dữ liệu đầu vào nên là tập biến thực sự đi vào CFA hoặc SEM. Trước khi kiểm tra phân phối, cần hoàn tất mã hóa, phạm vi hợp lệ, giá trị thiếu, đảo chiều item và phát hiện trùng bản ghi. Một giá trị ngoài phạm vi là lỗi dữ liệu, không phải bằng chứng về phân phối của tổng thể.
- Danh sách biến khớp với mô hình CFA hoặc SEM dự kiến.
- Mã missing không bị đọc như một giá trị thật.
- Item đảo chiều đã được xử lý và kiểm tra.
- Không còn giá trị ngoài phạm vi hợp lệ.
- Đã lưu một bản dữ liệu gốc không chỉnh sửa.
- Tiêu chí rà ngoại lệ được xác lập trước khi xem kết quả.
2. Giả định chuẩn thực sự liên quan đến điều gì?
Trong SEM dựa trên hiệp phương sai với maximum likelihood thông thường, giả định lý thuyết liên quan đến phân phối chung của các biến quan sát liên tục. Vì vậy, từng biến có histogram đẹp không đủ để chứng minh multivariate normality. Ngược lại, một độ lệch nhẹ ở một biến cũng không tự động làm mọi ước lượng điểm trở nên vô nghĩa.
Không chuẩn có thể làm sai lệch thống kê chi-square, sai số chuẩn và khoảng tin cậy. Hậu quả phụ thuộc dạng lệch, đuôi phân phối, cỡ mẫu, độ phức tạp và mức sai đặc tả mô hình. Mô phỏng của Curran, West và Finch (1996) cho thấy không chuẩn và sai đặc tả có thể kết hợp làm các thống kê kiểm định hoạt động kém.
Nếu biến là ordinal với rất ít mức, vấn đề không chỉ là thiếu chuẩn. Khi đó, mô hình cho biến liên tục và ML thông thường có thể không phù hợp về bản chất. Cần cân nhắc estimator dành cho biến phân loại hoặc ordinal trong phần mềm có hỗ trợ trực tiếp.
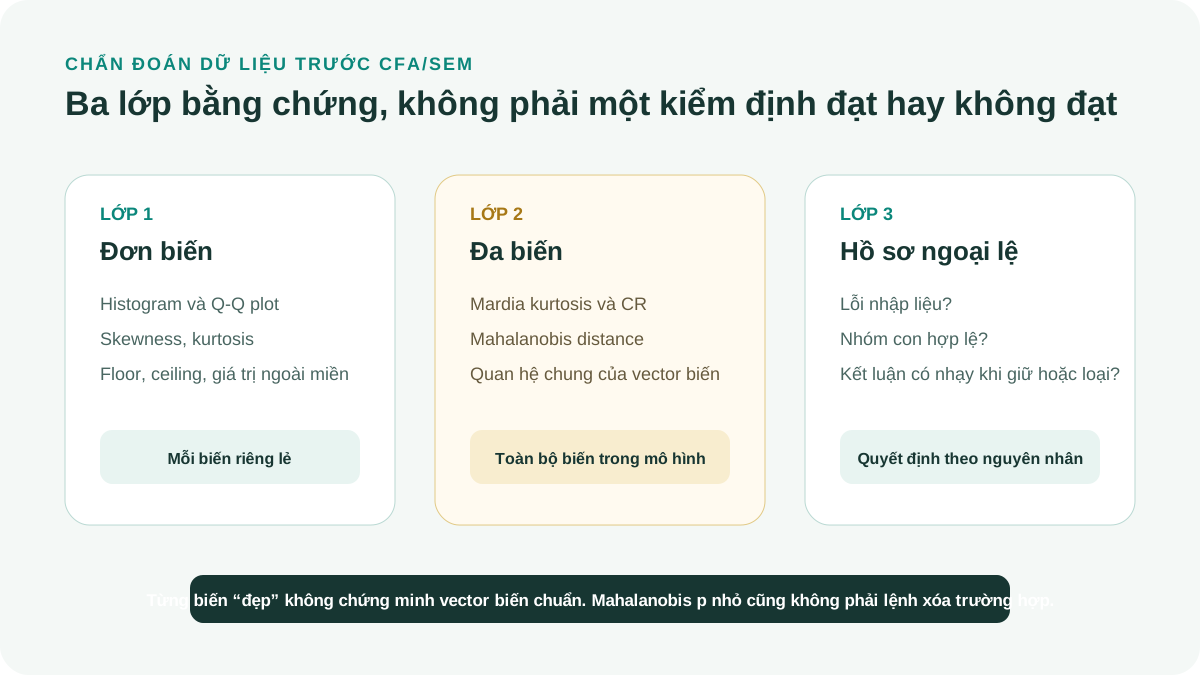
| Lớp | Câu hỏi | Bằng chứng chính | Không được kết luận vội |
|---|---|---|---|
| Đơn biến | Từng biến lệch hoặc có đuôi nặng đến mức nào? | Histogram, Q-Q plot, skewness, kurtosis | Mọi biến gần chuẩn nên vector biến chắc chắn chuẩn |
| Đa biến | Phân phối chung của vector biến có phù hợp giả định không? | Mardia-type kurtosis và critical ratio trong AMOS | Critical ratio lớn nên dữ liệu không dùng được |
| Ngoại lệ | Trường hợp nào khác xa tâm đa biến và vì sao? | Mahalanobis distance cộng hồ sơ gốc | Trường hợp có p nhỏ phải bị xóa |
3. Chẩn đoán đơn biến trong SPSS
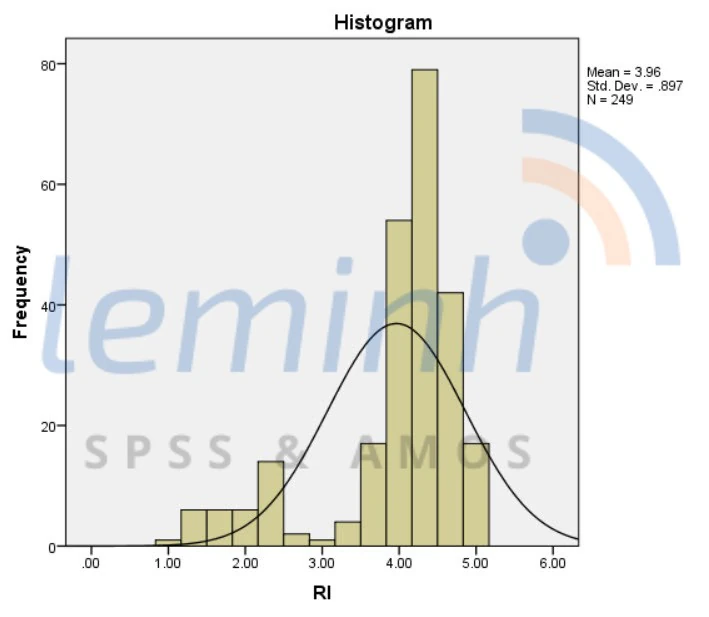
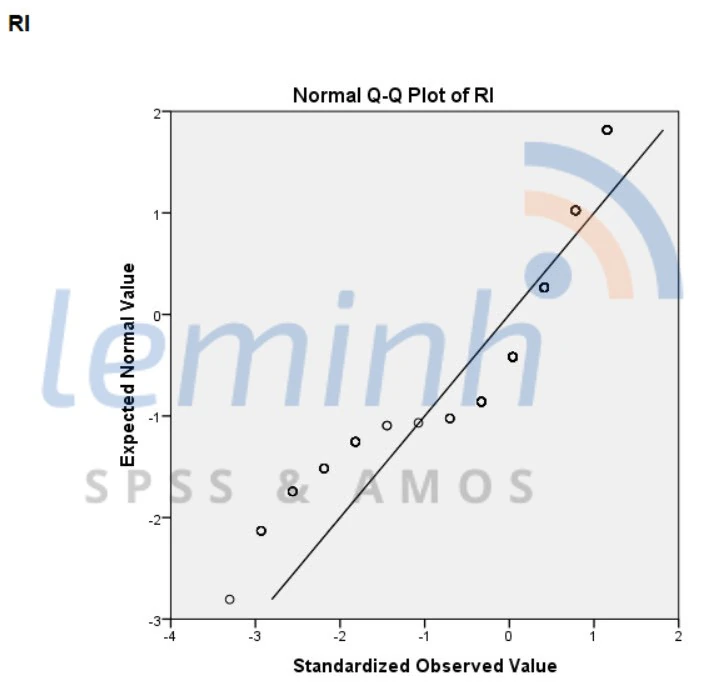
Trong SPSS, Analyze > Descriptive Statistics > Explore cho phép xem histogram, normal Q-Q plot, boxplot, skewness và kurtosis. Hãy nhìn hình trước khi dùng ngưỡng: phân phối có một đuôi dài, hai đỉnh, trần hoặc sàn, hay chỉ lệch nhẹ do cỡ mẫu lớn?
Shapiro-Wilk kiểm định giả thuyết phân phối chuẩn chính xác. Với mẫu lớn, sai lệch nhỏ và ít ý nghĩa thực hành vẫn có thể cho p < 0,05. Với mẫu nhỏ, kiểm định có thể thiếu lực. Vì thế, p-value không thay thế biểu đồ, thống kê mô tả và hiểu biết về thang đo.
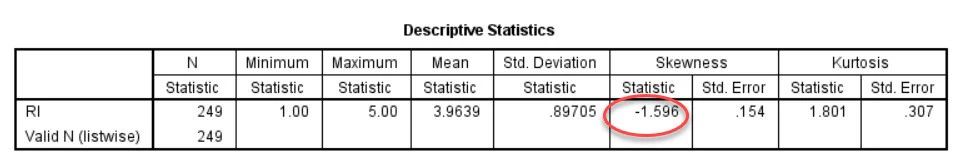
Không có cặp cutoff skewness và kurtosis áp dụng cho mọi thiết kế. Kline (2023) tổng hợp rằng một số nghiên cứu mô phỏng đã xem |skewness| > 2 và |excess kurtosis| > 7 là dấu hiệu không chuẩn nghiêm trọng, nhưng chính tác giả cũng nhấn mạnh có nhiều ngoại lệ và không tồn tại ranh giới phổ quát. Vì vậy, hai mốc này chỉ nên dùng như điểm neo để kiểm tra kỹ hơn, không phải điều kiện tự động chọn estimator, biến đổi dữ liệu hoặc loại biến.
Mở Explore
Đưa đúng các biến quan sát vào Dependent List; dùng Factor List nếu cần xem theo nhóm.
Chọn Plots
Bật histogram và normality plots; giữ boxplot để nhận diện trường hợp cần rà.
Đọc histogram và Q-Q plot
Ghi dạng lệch, đuôi, nhiều đỉnh, trần hoặc sàn thay vì chỉ ghi đạt chuẩn.
Ghi skewness và kurtosis
Giữ cùng quy ước do SPSS xuất và không trộn excess kurtosis với Pearson kurtosis.
Kiểm tra trường hợp cực trị
Dùng ID trường hợp để đối chiếu phiếu hoặc nguồn nhập liệu.
Lặp theo nhóm quan trọng
Nếu nghiên cứu so sánh nhóm, xem phân phối trong từng nhóm thay vì chỉ mẫu gộp.
Lưu output và nhật ký
Ghi phiên bản dữ liệu, ngày chạy và mọi quyết định chỉnh sửa.
4. Chuẩn đa biến và ngoại lệ trong AMOS
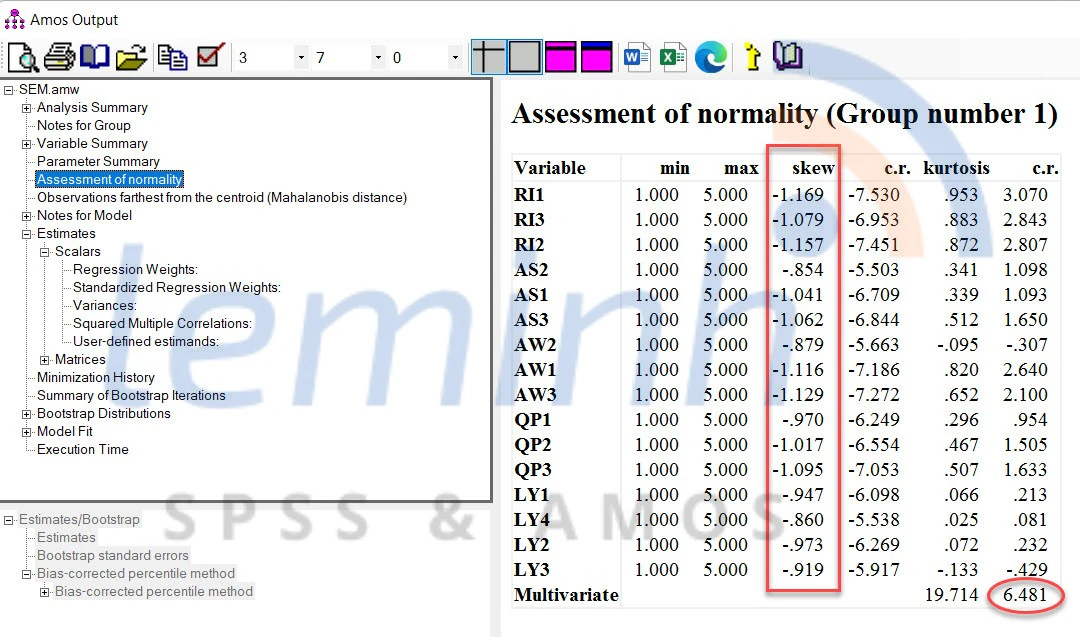
Mardia (1970) xây dựng các thước đo skewness và kurtosis đa biến. Theo hướng dẫn của IBM Corp. (2022), AMOS cung cấp kurtosis đa biến và critical ratio trong bảng Assessment of normality. Đây là chẩn đoán về toàn bộ tập biến của mô hình, không phải trung bình của kurtosis đơn biến.
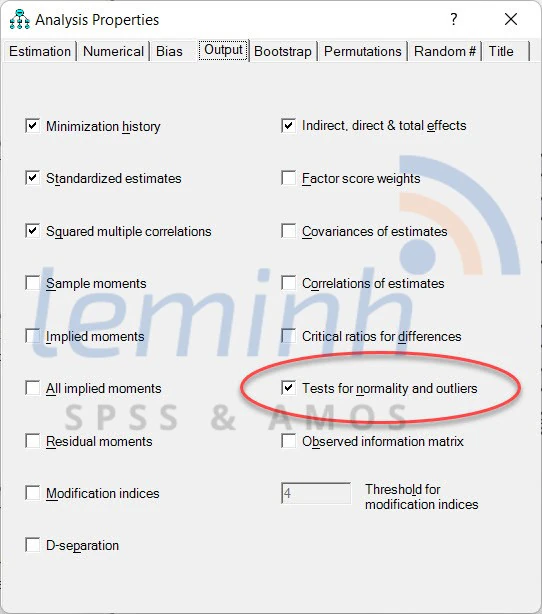
Trong Analysis Properties > Output, chọn Tests for normality and outliers. Sau khi chạy, đọc các hàng của từng biến, hàng Multivariate và bảng Observations farthest from the centroid. Critical ratio tăng theo mức lệch và cỡ mẫu nên không nên biến một giá trị cắt thành lệnh tự động đổi estimator.
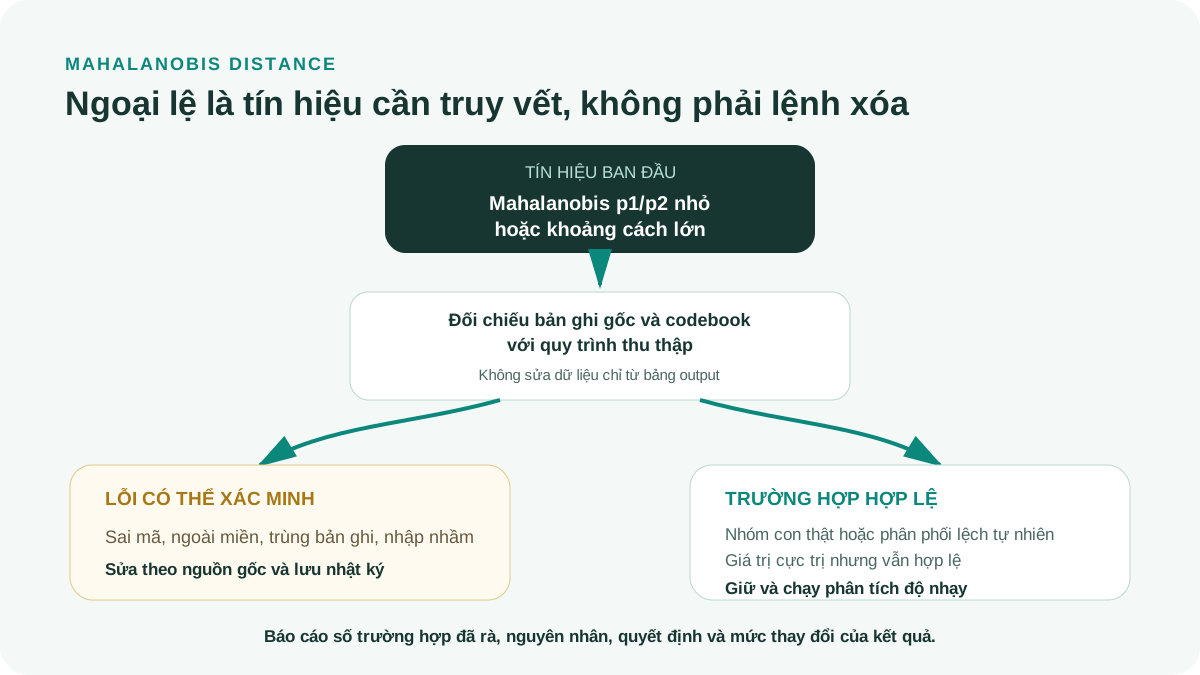
Mahalanobis distance đo khoảng cách đa biến so với tâm dưới cấu trúc hiệp phương sai. Một trường hợp xa có thể là lỗi nhập, một thành viên hợp lệ của tổng thể, một nhóm con hoặc bằng chứng mô hình dữ liệu đang thiếu cấu trúc. Chỉ hồ sơ gốc và thiết kế lấy mẫu mới phân biệt được các khả năng đó.
Bật kiểm tra
Trong Output, chọn Tests for normality and outliers trước khi ước lượng.
Kiểm tra hội tụ
Không diễn giải chẩn đoán từ một mô hình không hội tụ hoặc có nghiệm bất khả thi.
Đọc từng biến
Ghi skewness, kurtosis và critical ratio như mô tả, không như phán quyết độc lập.
Đọc hàng Multivariate
Ghi kurtosis đa biến và critical ratio, đồng thời lưu danh sách biến đã dùng.
Đọc Mahalanobis distance
Sắp xếp các trường hợp xa nhất và dùng ID để quay lại dữ liệu gốc.
Phân loại nguyên nhân
Tách lỗi dữ liệu, trường hợp hợp lệ, nhóm con và ảnh hưởng của mã hóa.
Lập phiên bản phân tích độ nhạy
Nếu có lý do khoa học, so kết quả giữ và xử lý trường hợp thay vì chỉ báo cáo phiên bản thuận lợi.
5. Xử lý ngoại lệ mà không làm sạch quá mức
Sửa lỗi nhập liệu khi có bằng chứng từ phiếu hoặc nguồn gốc. Không thay một giá trị hợp lệ bằng missing chỉ vì nó nằm xa trung tâm. Với trường hợp hợp lệ, lựa chọn có thể là giữ nguyên, dùng estimator ít nhạy hơn, mô hình hóa nhóm con hoặc báo cáo phân tích độ nhạy.
Xóa ngoại lệ sau khi xem nó làm fit tốt hơn là một quyết định phụ thuộc kết quả. Điều này có thể làm giảm tính đại diện và tạo báo cáo quá lạc quan. Nếu loại trường hợp vì không thuộc quần thể mục tiêu hoặc vi phạm tiêu chí tuyển mẫu, tiêu chí đó phải được áp dụng nhất quán.
Winsorization hoặc biến đổi log có thể thay đổi ý nghĩa thang đo. Chỉ dùng khi phép biến đổi phù hợp với biến, có thể giải thích và được ghi rõ. Không biến đổi item Likert riêng lẻ chỉ để tạo histogram giống chuông.
| Nguyên nhân | Hành động chính | Phân tích bổ sung |
|---|---|---|
| Lỗi nhập hoặc mã hóa | Đối chiếu và sửa có dấu vết | Chạy lại toàn bộ chẩn đoán |
| Không thuộc quần thể mục tiêu | Áp tiêu chí loại mẫu đã xác lập | Báo số lượng và lý do |
| Trường hợp hợp lệ nhưng có ảnh hưởng | Giữ làm phân tích chính nếu phù hợp | So ước lượng có và không có trường hợp |
| Nhóm con có thật | Xem dị biệt mẫu hoặc multigroup | Kiểm tra measurement invariance |
| Phân phối tự nhiên lệch | Chọn estimator hoặc CI phù hợp | Báo median hoặc quantile khi cần |
6. Từ chẩn đoán đến lựa chọn estimator
ML thông thường có thể vẫn hữu ích khi sai lệch không nghiêm trọng, mẫu đủ và mô hình không quá phức tạp, nhưng quyết định cần được bảo vệ bằng độ nhạy của sai số chuẩn và fit. Robust correction điều chỉnh thống kê kiểm định hoặc sai số chuẩn dựa trên mức không chuẩn; nó không thay đổi dữ liệu và không sửa mô hình sai (Savalei, 2014). Kline (2023) cũng nhấn mạnh việc đánh giá giả định và fit như một hồ sơ bằng chứng thay vì dựa vào một cutoff đơn lẻ.
AMOS hỗ trợ bootstrap và Bollen-Stine bootstrap. Bollen và Stine (1992) dùng tái lấy mẫu dưới mô hình null để đánh giá fit tổng thể khi giả định phân phối bị vi phạm. Bootstrap confidence interval phù hợp hơn cho nhiều hiệu ứng gián tiếp, nhưng bootstrap không phải phép biến dữ liệu thành chuẩn.
Nếu dữ liệu không chuẩn mạnh, ordinal ít mức, có missing phức tạp hoặc cần robust standard errors và scaled chi-square, có thể cần estimator trong phần mềm khác. Yuan và Bentler (2000) trình bày các điều chỉnh likelihood cho dữ liệu không chuẩn và thiếu; lựa chọn phải bám dạng dữ liệu và mục tiêu suy luận.
| Tình huống | Phân tích chính có thể cân nhắc | Kiểm tra độ nhạy | Ghi chú |
|---|---|---|---|
| Liên tục, lệch nhẹ, mẫu đủ | ML với chẩn đoán đầy đủ | Bootstrap CI hoặc robust estimator | Không cần biến đổi cơ học |
| Không chuẩn rõ, AMOS vẫn dùng | ML cộng bootstrap phù hợp | Bollen-Stine và so ước lượng | Nêu giới hạn của AMOS |
| Ordinal ít mức | Estimator cho categorical hoặc ordinal | So với đặc tả liên tục nếu có lý do | Không chỉ nhìn skewness |
| Ngoại lệ hợp lệ có ảnh hưởng | Giữ trong mô hình chính | So có và không có trường hợp | Báo cả hai nếu kết luận đổi |
| Missing và không chuẩn | Estimator xử lý missing trực tiếp | Đặc tả cơ chế missing hợp lý | Không listwise tùy tiện |
7. Ví dụ số giả định: từ bảng chẩn đoán đến quyết định
Ví dụ dưới đây là minh họa, không phải dữ liệu nghiên cứu thật. Một mô hình CFA có 18 item Likert 5 mức và N = 412. Skewness đơn biến nằm từ -1,18 đến 0,74; excess kurtosis từ -0,62 đến 2,35. Q-Q plot cho thấy ba item có đuôi phải; critical ratio kurtosis đa biến của AMOS là 12,84.
Ba quan sát có Mahalanobis p2 < .001 được kiểm tra. Một trường hợp có giá trị 55 ở item thang 1 đến 5 và được sửa thành 5 sau khi đối chiếu phiếu. Hai trường hợp còn lại hợp lệ, thuộc nhóm người dùng cường độ rất cao nên được giữ.
Nhóm nghiên cứu dùng ML làm mô hình chính, báo bootstrap 2.000 mẫu cho confidence interval và Bollen-Stine p = .074 cho đánh giá fit bổ sung. Khi loại hai trường hợp hợp lệ trong phân tích độ nhạy, tải thay đổi tối đa .018 và kết luận các đường cấu trúc không đổi. Quyết định giữ mẫu vì vậy có bằng chứng rõ hơn việc xóa cơ học.
| Bằng chứng | Kết quả giả định | Cách diễn giải |
|---|---|---|
| Skewness đơn biến | -1,18 đến 0,74 | Có lệch vừa ở một số item |
| Excess kurtosis | -0,62 đến 2,35 | Một số đuôi nặng, không dùng cutoff đơn độc |
| CR kurtosis đa biến | 12,84 | Có bằng chứng không chuẩn đa biến |
| Mahalanobis p2 < .001 | 3 trường hợp | Một lỗi được sửa, hai trường hợp hợp lệ được giữ |
| Bollen-Stine p | .074 | Không bác bỏ exact fit theo thủ tục minh họa này |
| Tải thay đổi tối đa | .018 | Kết luận ít nhạy với hai trường hợp hợp lệ |
8. Bollen-Stine, bootstrap sai số chuẩn và robust ML không thay thế lẫn nhau
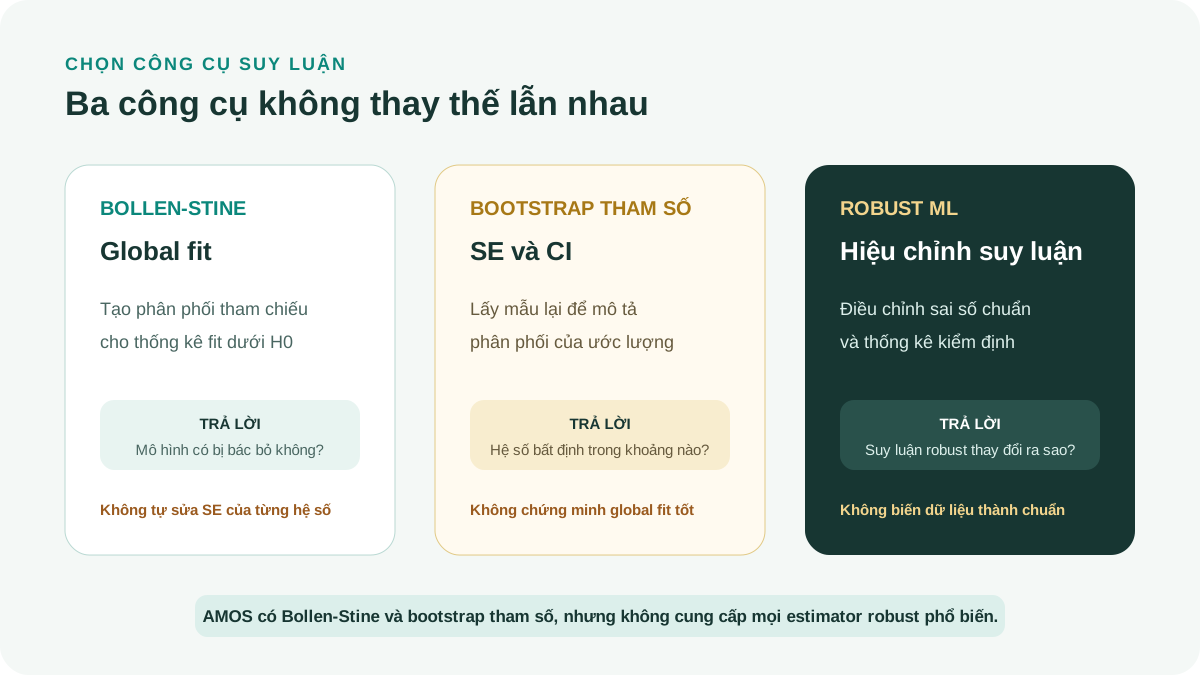
Bollen-Stine bootstrap tạo phân phối tham chiếu cho thống kê độ phù hợp của mô hình dưới giả thuyết mô hình đúng. Giá trị Bollen-Stine p vì vậy trả lời câu hỏi về global fit, không tự động sửa sai số chuẩn hay khoảng tin cậy của từng tham số (Bollen và Stine, 1992; Kline, 2023).
Bootstrap sai số chuẩn và khoảng tin cậy là một thủ tục khác. Nó lấy mẫu lại để mô tả phân phối thực nghiệm của ước lượng tham số. Nếu bài nghiên cứu cần suy luận cho hiệu ứng gián tiếp hoặc hệ số có phân phối lệch, cần yêu cầu bootstrap cho chính tham số đó, không chỉ đánh dấu Bollen-Stine.
Robust ML giữ ước lượng ML cơ bản nhưng điều chỉnh sai số chuẩn và thống kê kiểm định theo mức không chuẩn. Savalei (2014) cho thấy các hiệu chỉnh robust có nhiều biến thể và giả định, vì vậy báo cáo phải ghi tên estimator cụ thể. AMOS không cung cấp mọi biến thể robust phổ biến, nên đôi khi cần kiểm tra chéo bằng phần mềm khác.
| Công cụ | Thành phần được xử lý | Không nên diễn giải thành |
|---|---|---|
| Bollen-Stine bootstrap | p-value cho global fit | Sai số chuẩn robust cho mọi hệ số |
| Bootstrap tham số | Sai số chuẩn và khoảng tin cậy của hệ số | Mô hình đã có global fit tốt |
| Robust ML | Sai số chuẩn và thống kê fit đã hiệu chỉnh | Dữ liệu đã trở thành phân phối chuẩn |
9. Dữ liệu Likert ít mức: vấn đề thang đo, không chỉ normality
Item Likert có bốn hoặc năm mức đôi khi được xử lý gần liên tục khi phân phối không quá cực đoan và mẫu đủ lớn. Tuy nhiên, với hai hoặc ba mức, độ lệch mạnh hoặc nhiều ô tần số thưa, ma trận Pearson và ML thông thường có thể mô tả kém quan hệ giữa các biến tiềm ẩn liên tục.
Kline (2023) khuyến nghị lựa chọn phương pháp theo mức đo và điều kiện dữ liệu. Một phương án là CFA ordinal dùng tương quan polychoric cùng estimator như WLSMV trong phần mềm hỗ trợ. Flora và Curran (2004) cho thấy robust WLS hoạt động tốt hơn full WLS trong nhiều điều kiện mô phỏng với biến ordinal, đặc biệt khi cỡ mẫu không lớn; kết quả này hỗ trợ việc chọn estimator theo mức đo thay vì áp ML mặc định cho mọi item Likert.
Nếu vẫn dùng AMOS với ML, cần gọi đó là lựa chọn gần đúng, báo cáo phân phối từng item và thực hiện phân tích độ nhạy thay vì tuyên bố ML luôn robust. AMOS 29 không cung cấp estimator categorical tương đương WLSMV, nên phân tích đối chứng ordinal cần thực hiện trong phần mềm có hỗ trợ và phải giữ cùng đặc tả mô hình.
| Dạng biến | Phân tích chính nên cân nhắc | Kiểm tra bổ sung |
|---|---|---|
| Liên tục, không chuẩn nhẹ | ML với chẩn đoán đầy đủ | Bootstrap hoặc robust estimator |
| Likert 5 đến 7 mức, phân phối không cực đoan | ML có thể là xấp xỉ thực dụng | So sánh với CFA ordinal nếu kết luận quan trọng |
| Nhị phân hoặc 2 đến 3 mức | CFA categorical hoặc ordinal | WLSMV và ma trận polychoric hoặc tetrachoric |
| Trần, sàn hoặc đuôi rất nặng | Estimator robust hoặc mô hình phù hợp phân phối | Phân tích độ nhạy và kiểm tra dữ liệu |
Skewness nhỏ không tự động chứng minh ML phù hợp, còn skewness lớn không tự động buộc xóa biến. Quyết định phải xét mức đo, mẫu, mô hình và mục tiêu suy luận.
10. Thiết kế phân tích độ nhạy trước khi kết luận
Phân tích độ nhạy hỏi liệu kết luận khoa học có đổi khi dùng một lựa chọn ước lượng hợp lý khác. Đây là cách thực tế để đánh giá hậu quả của không chuẩn thay vì tranh luận xem dữ liệu có chuẩn tuyệt đối hay không (Yuan và Bentler, 2000; Savalei, 2014).
Không cần tạo hàng chục mô hình. Hãy chọn trước một phân tích chính và một hoặc hai đối chứng nhắm đúng rủi ro: bootstrap khoảng tin cậy cho tham số, robust ML trong phần mềm khác, CFA ordinal cho item ít mức, hoặc chạy có và không có trường hợp đang được rà soát.
Bước 1
Chốt estimator chính và lý do trước khi xem kết quả đối chứng.
Bước 2
Chọn đối chứng giải quyết đúng rủi ro đã phát hiện, không chọn chỉ vì cho p-value thuận lợi.
Bước 3
So sánh dấu, độ lớn, khoảng tin cậy và kết luận của các tham số trọng tâm.
Bước 4
So sánh global fit nhưng không coi chênh lệch fit nhỏ là bằng chứng duy nhất.
Bước 5
Ghi mọi thay đổi về mẫu, biến, missing và estimator giữa hai lần chạy.
Bước 6
Nếu kết luận đổi, báo cáo sự không ổn định và hạ mức chắc chắn thay vì giấu kết quả.
Phân tích chính vẫn phải được xác định trước. Phân tích độ nhạy dùng để đánh giá độ bền của kết luận, không phải để thay estimator sau khi thấy p-value.
11. Các lỗi diễn giải thường gặp
| Cách làm yếu | Vì sao có vấn đề | Cách xử lý |
|---|---|---|
| Shapiro-Wilk p < .05 nên không thể SEM | Kiểm định nhạy với N và chỉ xét từng biến | Kết hợp hình, đa biến và estimator |
| Mọi skewness trong ±2 nên chuẩn đa biến | Chuẩn đơn biến không kéo theo chuẩn đa biến | Đọc hàng Multivariate trong AMOS |
| CR kurtosis lớn nên xóa ngoại lệ | Không chỉ ra trường hợp hay nguyên nhân | Rà Mahalanobis và hồ sơ gốc |
| Bootstrap làm dữ liệu chuẩn | Bootstrap thay đổi cách suy luận, không đổi dữ liệu | Nói rõ mục tiêu bootstrap |
| Bollen-Stine p > .05 chứng minh mô hình đúng | Không bác bỏ không đồng nghĩa xác nhận lý thuyết | Đọc fit, residual và mô hình cạnh tranh |
| Xóa trường hợp đến khi fit đẹp | Tạo quyết định phụ thuộc kết quả | Xác lập tiêu chí và báo sensitivity |
12. Mẫu báo cáo APA 7 và bảng kiểm
Mẫu sau dùng số giả định. Khi áp dụng, thay số trong ngoặc vuông bằng kết quả thật, nêu phiên bản phần mềm, số bootstrap, loại confidence interval và lý do xử lý từng trường hợp.
Mẫu báo cáo tiếng Việt
Phân phối được đánh giá bằng histogram và Q-Q plot trong SPSS [phiên bản], skewness và excess kurtosis đơn biến, cùng Tests for normality and outliers trong IBM SPSS Amos [phiên bản]. Skewness dao động từ [min] đến [max], excess kurtosis từ [min] đến [max], và critical ratio kurtosis đa biến là [ ]. Có [số] quan sát được rà soát theo Mahalanobis distance; [số] lỗi dữ liệu được sửa sau đối chiếu và [số] trường hợp hợp lệ được giữ. Mô hình chính được ước lượng bằng [estimator]. Do bằng chứng không chuẩn [mức độ], nghiên cứu dùng [số] mẫu bootstrap với [loại] confidence interval và Bollen-Stine p = [ ]. Phân tích độ nhạy [mô tả] cho thấy [kết luận có giới hạn].
- Đã kiểm tra phạm vi, missing và item đảo chiều trước normality.
- Đã phân biệt chuẩn đơn biến và multivariate normality.
- Đã xem histogram và Q-Q plot thay vì chỉ p-value.
- Đã ghi rõ quy ước kurtosis của phần mềm.
- Đã đọc hàng Multivariate trong AMOS.
- Đã truy vết từng trường hợp Mahalanobis lớn về dữ liệu gốc.
- Không xóa trường hợp hợp lệ chỉ để tăng fit.
- Đã giải thích vì sao chọn ML, bootstrap hoặc robust estimator.
- Đã mô tả số mẫu bootstrap và loại confidence interval.
- Đã dùng Bollen-Stine đúng mục đích đánh giá fit.
- Đã thực hiện sensitivity analysis nếu quyết định có thể ảnh hưởng kết quả.
- Đã đối chiếu mọi trích dẫn trong bài với tài liệu tham khảo.
Kết luận
Kiểm tra phân phối chuẩn là một quy trình chẩn đoán và ra quyết định, không phải cuộc săn tìm p > 0,05. Câu hỏi quan trọng là vi phạm nào có thật, thành phần suy luận nào nhạy và kết luận có đổi dưới lựa chọn hợp lý khác hay không.
Một báo cáo tốt cho thấy cả dữ liệu, nguyên nhân, estimator và phân tích độ nhạy. Cách làm này bảo vệ kết luận tốt hơn việc xóa điểm lạ hoặc áp một cutoff chung cho mọi mẫu.
Tài liệu tham khảo
- Bollen, K. A., & Stine, R. A. (1992). Bootstrapping goodness-of-fit measures in structural equation models. Sociological Methods & Research, 21(2), 205-229. https://doi.org/10.1177/0049124192021002004
- Curran, P. J., West, S. G., & Finch, J. F. (1996). The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis. Psychological Methods, 1(1), 16-29. https://doi.org/10.1037/1082-989X.1.1.16
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519-530. https://doi.org/10.1093/biomet/57.3.519
- Savalei, V. (2014). Understanding robust corrections in structural equation modeling. Structural Equation Modeling: A Multidisciplinary Journal, 21(1), 149-160. https://doi.org/10.1080/10705511.2013.824793
- Yuan, K. H., & Bentler, P. M. (2000). Three likelihood-based methods for mean and covariance structure analysis with nonnormal missing data. Sociological Methodology, 30(1), 165-200. https://doi.org/10.1111/0081-1750.00078
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466-491. https://doi.org/10.1037/1082-989X.9.4.466
- IBM Corp. (2022). IBM SPSS Amos 29 user's guide. https://www.ibm.com/docs/en/SSLVMB_29.0.0/pdf/IBM_SPSS_Amos_User_Guide.pdf
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
Ghi chú học thuật: Các con số trong ví dụ là giả định để minh họa quy trình. Dữ liệu ordinal ít mức, không chuẩn mạnh hoặc missing phức tạp có thể cần estimator và phần mềm khác thay vì mặc định ML trong AMOS.