
fsQCA từ hiệu chuẩn đến nghiệm: quy trình thực hành có thể kiểm tra
fsQCA tìm những tổ hợp điều kiện gắn với một kết quả, thay vì xếp hạng ảnh hưởng riêng của từng biến. Một phân tích có thể kiểm tra phải giải thích ý nghĩa tập hợp, mốc hiệu chuẩn, tiêu chí giữ dòng bảng chân trị và giả định dùng để rút gọn nghiệm.
Định nghĩa tập trước, hiệu chuẩn có căn cứ, tách điều kiện cần khỏi cấu hình đủ. Đọc consistency cùng coverage, giữ dấu vết các giả định phản thực và kiểm tra độ nhạy. Không biến cấu hình quan sát thành bằng chứng nhân quả tự thân hoặc dùng coverage thay R².
fsQCA: từ tập hợp đến cấu hình kết quả
- Hiệu chuẩn
Biện minh các mốc tập hợp
- Bảng chân trị
Kiểm tra tần số và nhất quán
- Nghiệm
Đọc các cấu hình thay thế
- Độ vững
Thử độ nhạy và báo cáo lựa chọn
Sơ đồ khái niệm. Không đọc một cấu hình fsQCA như một hệ số tác động thuần.
Nguồn: Lê Minh biên soạn · Minh họa khái niệm, không phải đầu ra phần mềm.1. Đổi câu hỏi từ biến riêng lẻ sang tổ hợp điều kiện
Một nghiên cứu có thể hỏi liệu năng lực số liên quan đến hiệu quả công việc, hoặc hỏi những tổ hợp năng lực số, hỗ trợ và nguồn lực nào gắn với hiệu quả cao. Hai câu hỏi khác nhau. fsQCA phù hợp với câu hỏi cấu hình, cho phép nhiều con đường đến cùng kết quả và không buộc nguyên nhân của kết quả thấp phải đối nghịch với nguyên nhân của kết quả cao (Ragin, 2008, chương 1–2).
Điểm thành viên tập hợp nằm trong miền 0–1 và thể hiện mức một trường hợp thuộc một tập được định nghĩa về nội dung. Điểm 0,8 trong tập tổ chức có hỗ trợ mạnh không phải xác suất 80% tổ chức có hỗ trợ. Điểm đúng 0,5 là vị trí mơ hồ tối đa khi phân biệt thuộc hay không thuộc tập (Ragin, 2008, chương 2, 5).
Dấu ~ là phủ định, dấu * là giao và dấu + là hợp. Trong phép toán fuzzy set thông dụng, ~A = 1 − A, A*B = min(A, B), A+B = max(A, B). Công thức này áp dụng lên điểm thành viên đã hiệu chuẩn, không áp trực tiếp lên mã Likert 1–5 (Ragin, 2008, chương 2).
| Ký hiệu | Ý nghĩa | Không được suy ra |
|---|---|---|
| A*B → Y | Tổ hợp A và B được xem xét như điều kiện đủ của Y | A riêng lẻ hoặc B riêng lẻ đều đủ |
| Y → A | A được xem xét như điều kiện cần của Y | A có mặt thì chắc chắn Y có mặt |
| A*B + C → Y | Có các con đường thay thế: A cùng B, hoặc C | Các con đường không giao nhau |
| ~Y | Tập phủ định của kết quả, cần phân tích riêng | Chỉ cần đảo toàn bộ dấu trong nghiệm của Y |
2. Chuẩn bị tệp và định nghĩa tập trước khi hiệu chuẩn
Mỗi dòng nên là một trường hợp thuộc cùng phạm vi nghiên cứu; giữ một mã ID để truy ngược sau khi phân tích. Chuẩn bị biến gốc, quy tắc tính điểm thang đo, xử lý thiếu và mô tả từng tập. Nếu dùng điểm trung bình nhiều item, phải ghi rõ đó là điểm trung bình; nếu dùng điểm cấu trúc PLS-SEM, ghi mô hình và cách xuất điểm. Hai cách tạo điểm không mặc định tương đương.
Lập bảng định nghĩa gồm tên tập, ý nghĩa thành viên mạnh, ý nghĩa không thuộc tập, đơn vị và nguồn xác định mốc. Một tập như có nguồn lực đủ cho dự án cụ thể rõ hơn nhãn nguồn lực cao nếu không biết cao theo chuẩn nào. Quyết định nội dung phải đi trước phép biến đổi số (Ragin, 2008, chương 4–5).
Chọn số điều kiện theo lý thuyết và hiểu biết trường hợp. Với k điều kiện, bảng chân trị có 2^k dòng khả dĩ; sáu điều kiện đã tạo 64 tổ hợp. Thêm điều kiện chỉ để tìm nghiệm hấp dẫn làm tăng không gian tổ hợp và nguy cơ nhiều dòng không có trường hợp quan sát, được gọi là limited diversity (Ragin, 2008, chương 7–8).
- Giữ ID và bản dữ liệu gốc riêng với dữ liệu hiệu chuẩn.
- Nêu rõ cách tính điểm đầu vào và xử lý item nghịch, missing.
- Định nghĩa tập kết quả và từng tập điều kiện.
- Lưu phiên bản fsQCA hoặc gói phần mềm thực sự sử dụng.
- Không tự thêm điều kiện theo kết quả sau khi xem nghiệm.
3. Hiệu chuẩn: ba mốc không phải ba phân vị bắt buộc
Hiệu chuẩn trực tiếp dùng ba mốc định tính: gần hoàn toàn không thuộc tập, điểm giao và gần hoàn toàn thuộc tập. Trong cách trình bày của Ragin (2008, chương 5), các mốc thường được gắn gần 0,05; 0,50; 0,95. Đây là mức thành viên, không phải khẳng định mọi nghiên cứu phải lấy phân vị 5, 50 và 95 của dữ liệu làm mốc đầu vào.
Ví dụ giả định: một thang trung bình 1–7 được dùng để định nghĩa hỗ trợ mạnh. Nếu nội dung nhãn và tri thức bối cảnh bảo vệ được các mốc 2, 4 và 6, người nghiên cứu có thể dùng chúng như một đặc tả minh họa. Các giá trị ấy không phải khuyến nghị chung cho mọi thang 7 mức. Cần giải thích vì sao điểm 4 phân biệt hai phía của tập thay vì chọn nó chỉ vì là trung điểm số học (Ragin, 2008, chương 4–5).
Khi thiếu chuẩn ngoài, các phân vị có thể hỗ trợ xây mốc có biện minh, nhưng làm ý nghĩa tập phụ thuộc mẫu. Báo rõ phân vị, giá trị gốc tương ứng và kiểm tra các mốc thay thế hợp lý. Không dùng phép chia min–max đơn thuần rồi gọi đó là hiệu chuẩn theo nội dung (Ragin, 2008, chương 4–5).
Sau hiệu chuẩn, kiểm tra số trường hợp ở hai phía và đúng điểm 0,5, các giá trị ngoài miền, mã thiếu và trường hợp điển hình. Không cộng một hằng số vào toàn bộ điểm chỉ để tránh 0,5 mà không đánh giá tác động. Nếu phần mềm hoặc quy trình có xử lý điểm giao, lưu quy tắc, số trường hợp bị ảnh hưởng và phân tích độ nhạy.
| Mục | Nội dung cần điền |
|---|---|
| Tập đích | Định nghĩa thành viên mạnh và không thuộc tập |
| Đầu vào | Biến gốc, trung bình item hay điểm cấu trúc; đơn vị |
| Ba mốc | Full-out, crossover, full-in và lý do cho từng giá trị |
| Kiểm tra | Phân bố điểm, missing, số điểm đúng 0,5, trường hợp điển hình |
| Độ nhạy | Mốc thay thế có căn cứ và thay đổi trong kết quả |
Một thay đổi mốc cần có lý do nội dung hoặc kiểm tra độ nhạy được ghi lại. Không đổi liên tục cho đến khi đạt consistency hoặc coverage mong muốn rồi chỉ công bố lần đẹp nhất.
4. Điều kiện cần, điều kiện đủ và mẫu số của công thức
Nếu cấu hình C đủ cho Y, điểm thành viên C được kỳ vọng không vượt Y. Consistency của quan hệ đủ đánh giá mức độ dữ liệu phù hợp quan hệ tập con đó; coverage đo phần thành viên kết quả được cấu hình bao phủ. Theo Ragin (2008, tr. 52–55), hai chỉ số dùng cùng tử số nhưng khác mẫu số. Chúng không phải p-value và R².
Với điều kiện cần A, hướng tập con đổi lại: Y là tập con của A. Mẫu số để tính consistency cần là tổng điểm Y. Một điều kiện xuất hiện ở hầu hết mọi trường hợp có thể đạt consistency cần cao nhưng ít giá trị phân biệt; phải xem coverage, tính phổ biến và ý nghĩa nội dung, không chỉ một con số (Ragin, 2008, tr. 53–63).
Phân tích điều kiện cần riêng cho các điều kiện và phủ định có lý do, rồi xem đồ thị và trường hợp mâu thuẫn (Ragin, 2008, chương 3). Kết luận nhân quả vẫn cần lý thuyết, thứ tự thời gian và hiểu biết trường hợp; độ nhất quán tập hợp không thay những bằng chứng đó.
Cons_suff(C → Y) = sum(min(C_i, Y_i)) / sum(C_i)
Cov_suff(C → Y)  = sum(min(C_i, Y_i)) / sum(Y_i)
Cons_nec(Y → A)  = sum(min(A_i, Y_i)) / sum(Y_i)
Cov_nec(Y → A)   = sum(min(A_i, Y_i)) / sum(A_i)
Các tỷ số chỉ xác định khi mẫu số > 0.
5. Ví dụ số nhỏ để tự kiểm tra consistency và coverage
Bốn trường hợp dưới đây là dữ liệu giả định để kiểm tra công thức, không đủ để suy ra một nghiệm nghiên cứu. Với C = A*B, lấy min từng dòng, ta được 0,7; 0,6; 0,3; 0,2. Tổng C bằng 1,8; tổng Y bằng 1,9; tổng min(C, Y) bằng 1,6.
Do đó consistency đủ của C là 1,6/1,8 = 0,889 và coverage là 1,6/1,9 = 0,842. Hai con số khác nhau vì trả lời hai câu hỏi. Với A là điều kiện cần, tử số sum(min(A, Y)) bằng 1,8 nên consistency cần là 1,8/1,9 = 0,947. Không thể kết luận A đủ từ giá trị consistency cần này (công thức theo Ragin, 2008, chương 3).
| Trường hợp | A | B | Y | C = min(A,B) | min(C,Y) |
|---|---|---|---|---|---|
| 1 | 0,8 | 0,7 | 0,9 | 0,7 | 0,7 |
| 2 | 0,6 | 0,9 | 0,5 | 0,6 | 0,5 |
| 3 | 0,4 | 0,3 | 0,4 | 0,3 | 0,3 |
| 4 | 0,2 | 0,8 | 0,1 | 0,2 | 0,1 |
A <- c(.8, .6, .4, .2)
B <- c(.7, .9, .3, .8)
Y <- c(.9, .5, .4, .1)
C <- pmin(A, B)
stopifnot(sum(C) > 0, sum(Y) > 0)
c(cons_suff = sum(pmin(C,Y))/sum(C),
  cov_suff = sum(pmin(C,Y))/sum(Y),
  cons_nec_A = sum(pmin(A,Y))/sum(Y))
# 0.8888889, 0.8421053, 0.9473684
6. Quy trình thực hành từ tệp dữ liệu đến bảng chân trị
Quy trình dưới đây giữ các quyết định có thể tái lập thay vì phụ thuộc vào vị trí nút của một phiên bản. Ghi tên và phiên bản ứng dụng, tạo biến hiệu chuẩn riêng, rồi kiểm tra đúng các bảng đầu ra ở mỗi bước. Logic bảng chân trị và phép tối thiểu hóa dựa trên Ragin (2008, chương 7–9).
Tách ngưỡng tần số với consistency và PRI. Tần số liên quan số trường hợp có điểm thành viên trên 0,5 ở tổ hợp; PRI là chỉ số nhất quán thay thế dựa trên mức giảm sai số. Lưu giá trị, lý do và các dòng còn lại sau lựa chọn (Ragin, 2017, tr. 52–54).
Nếu dùng fsQCA 3.0 theo manual: trong Compute, hàm calibrate(x,n1,n2,n3) nhập theo thứ tự full-in, crossover, full-out. Ví dụ giả định: calibrate(SUPPORT,6,4,2). Tạo bảng bằng Analyze > Truth Table Algorithm. Đối chiếu phiên bản bạn dùng trước thao tác (Ragin, 2017, tr. 14–15, 51–52).
Nhập và kiểm tra dữ liệu
Kiểm tra ID, số trường hợp, kiểu biến, missing, item nghịch và cách tính điểm đầu vào. Nếu xuất từ PLS-SEM, giữ tên cột nối được với mô hình gốc.
Tạo các tập đã hiệu chuẩn
Nhập ba mốc cho từng tập theo nhật ký. Giữ cột gốc; xuất bảng thành viên và xem trường hợp ở hai đầu, quanh điểm giao. Dừng nếu miền giá trị hoặc hướng tập sai.
Kiểm tra điều kiện cần
Dùng outcome và các điều kiện/phủ định có căn cứ. Giữ consistency, coverage và đồ thị/trường hợp mâu thuẫn; không đưa kết quả cần vào bảng như thể là cấu hình đủ.
Tạo truth table
Chọn outcome và các điều kiện đã định. Kiểm tra danh sách tổ hợp, tần số, consistency và PRI; ghi số dòng không có trường hợp và các dòng mâu thuẫn.
Chốt tiêu chí giữ dòng
Biện minh ngưỡng theo thiết kế, số trường hợp, phân bố và kiến thức nội dung. Lưu truth table đầy đủ và bản dùng phân tích, không chỉ chụp nghiệm cuối.
Rút gọn và lưu giả định
Phân biệt complex, parsimonious và intermediate. Với intermediate, lưu kỳ vọng hướng có căn cứ cho từng điều kiện; kiểm tra các giả định dùng để đơn giản hóa.
Trở lại các trường hợp
Đọc consistency, raw/unique coverage và đồ thị từng cấu hình. Truy ID các trường hợp điển hình hoặc trái kỳ vọng để kiểm tra ý nghĩa của nghiệm.
Phân tích phủ định và độ nhạy
Phân tích ~Y riêng khi câu hỏi nghiên cứu yêu cầu. Thay các mốc hoặc ngưỡng bằng phương án có biện minh, lưu mọi thay đổi; chỉ dùng holdout khi thiết kế và cỡ mẫu cho phép.
7. Các loại nghiệm và giả định phản thực
Dòng không có trường hợp quan sát không đồng nghĩa dòng đã được chứng minh cho kết quả thấp. Nó là logical remainder. Nghiệm complex không dùng các remainder để đơn giản hóa; parsimonious cho phép đơn giản hóa bằng các remainder phù hợp thuật toán, kể cả giả định khó bảo vệ về nội dung. Intermediate giới hạn giả định theo kỳ vọng hướng được biện minh (Ragin, 2008, chương 8–9).
Nghiệm gọn hơn chưa chắc đúng hơn. Người đọc cần biết điều kiện nào đã bị lược bỏ nhờ giả định về tình huống chưa quan sát. Không chọn kỳ vọng hướng sau khi xem nghiệm chỉ để đạt cấu hình mong muốn. Nếu phần mềm xuất nhiều mô hình nghiệm, lưu các lựa chọn và giải thích vì sao sử dụng một mô hình cụ thể (Ragin, 2008, chương 9).
Nếu trình bày điều kiện cốt lõi và ngoại vi, phải nêu quy tắc so sánh các nghiệm cùng đặc tả và giữ output làm căn cứ. Không suy core/peripheral từ kích thước vòng tròn, độ lớn beta hay riêng raw coverage. Khi hình nguồn chỉ cho có mặt/vắng mặt và không đủ thông tin phân biệt vai trò, giữ nguyên giới hạn đó.
| Loại nghiệm | Cần lưu để giải thích |
|---|---|
| Complex | Các dòng quan sát được giữ và cấu hình chưa dùng remainder để rút gọn |
| Parsimonious | Giả định đơn giản hóa và việc chúng có thể vượt tri thức nội dung |
| Intermediate | Kỳ vọng hướng và các giả định phản thực được chấp nhận |
| Nhiều nghiệm cùng tồn tại | Các lựa chọn được xuất và căn cứ sử dụng, không chỉ bản thuận tiện nhất |
8. Đọc hai bảng cấu hình fIIP và fIWP được cung cấp
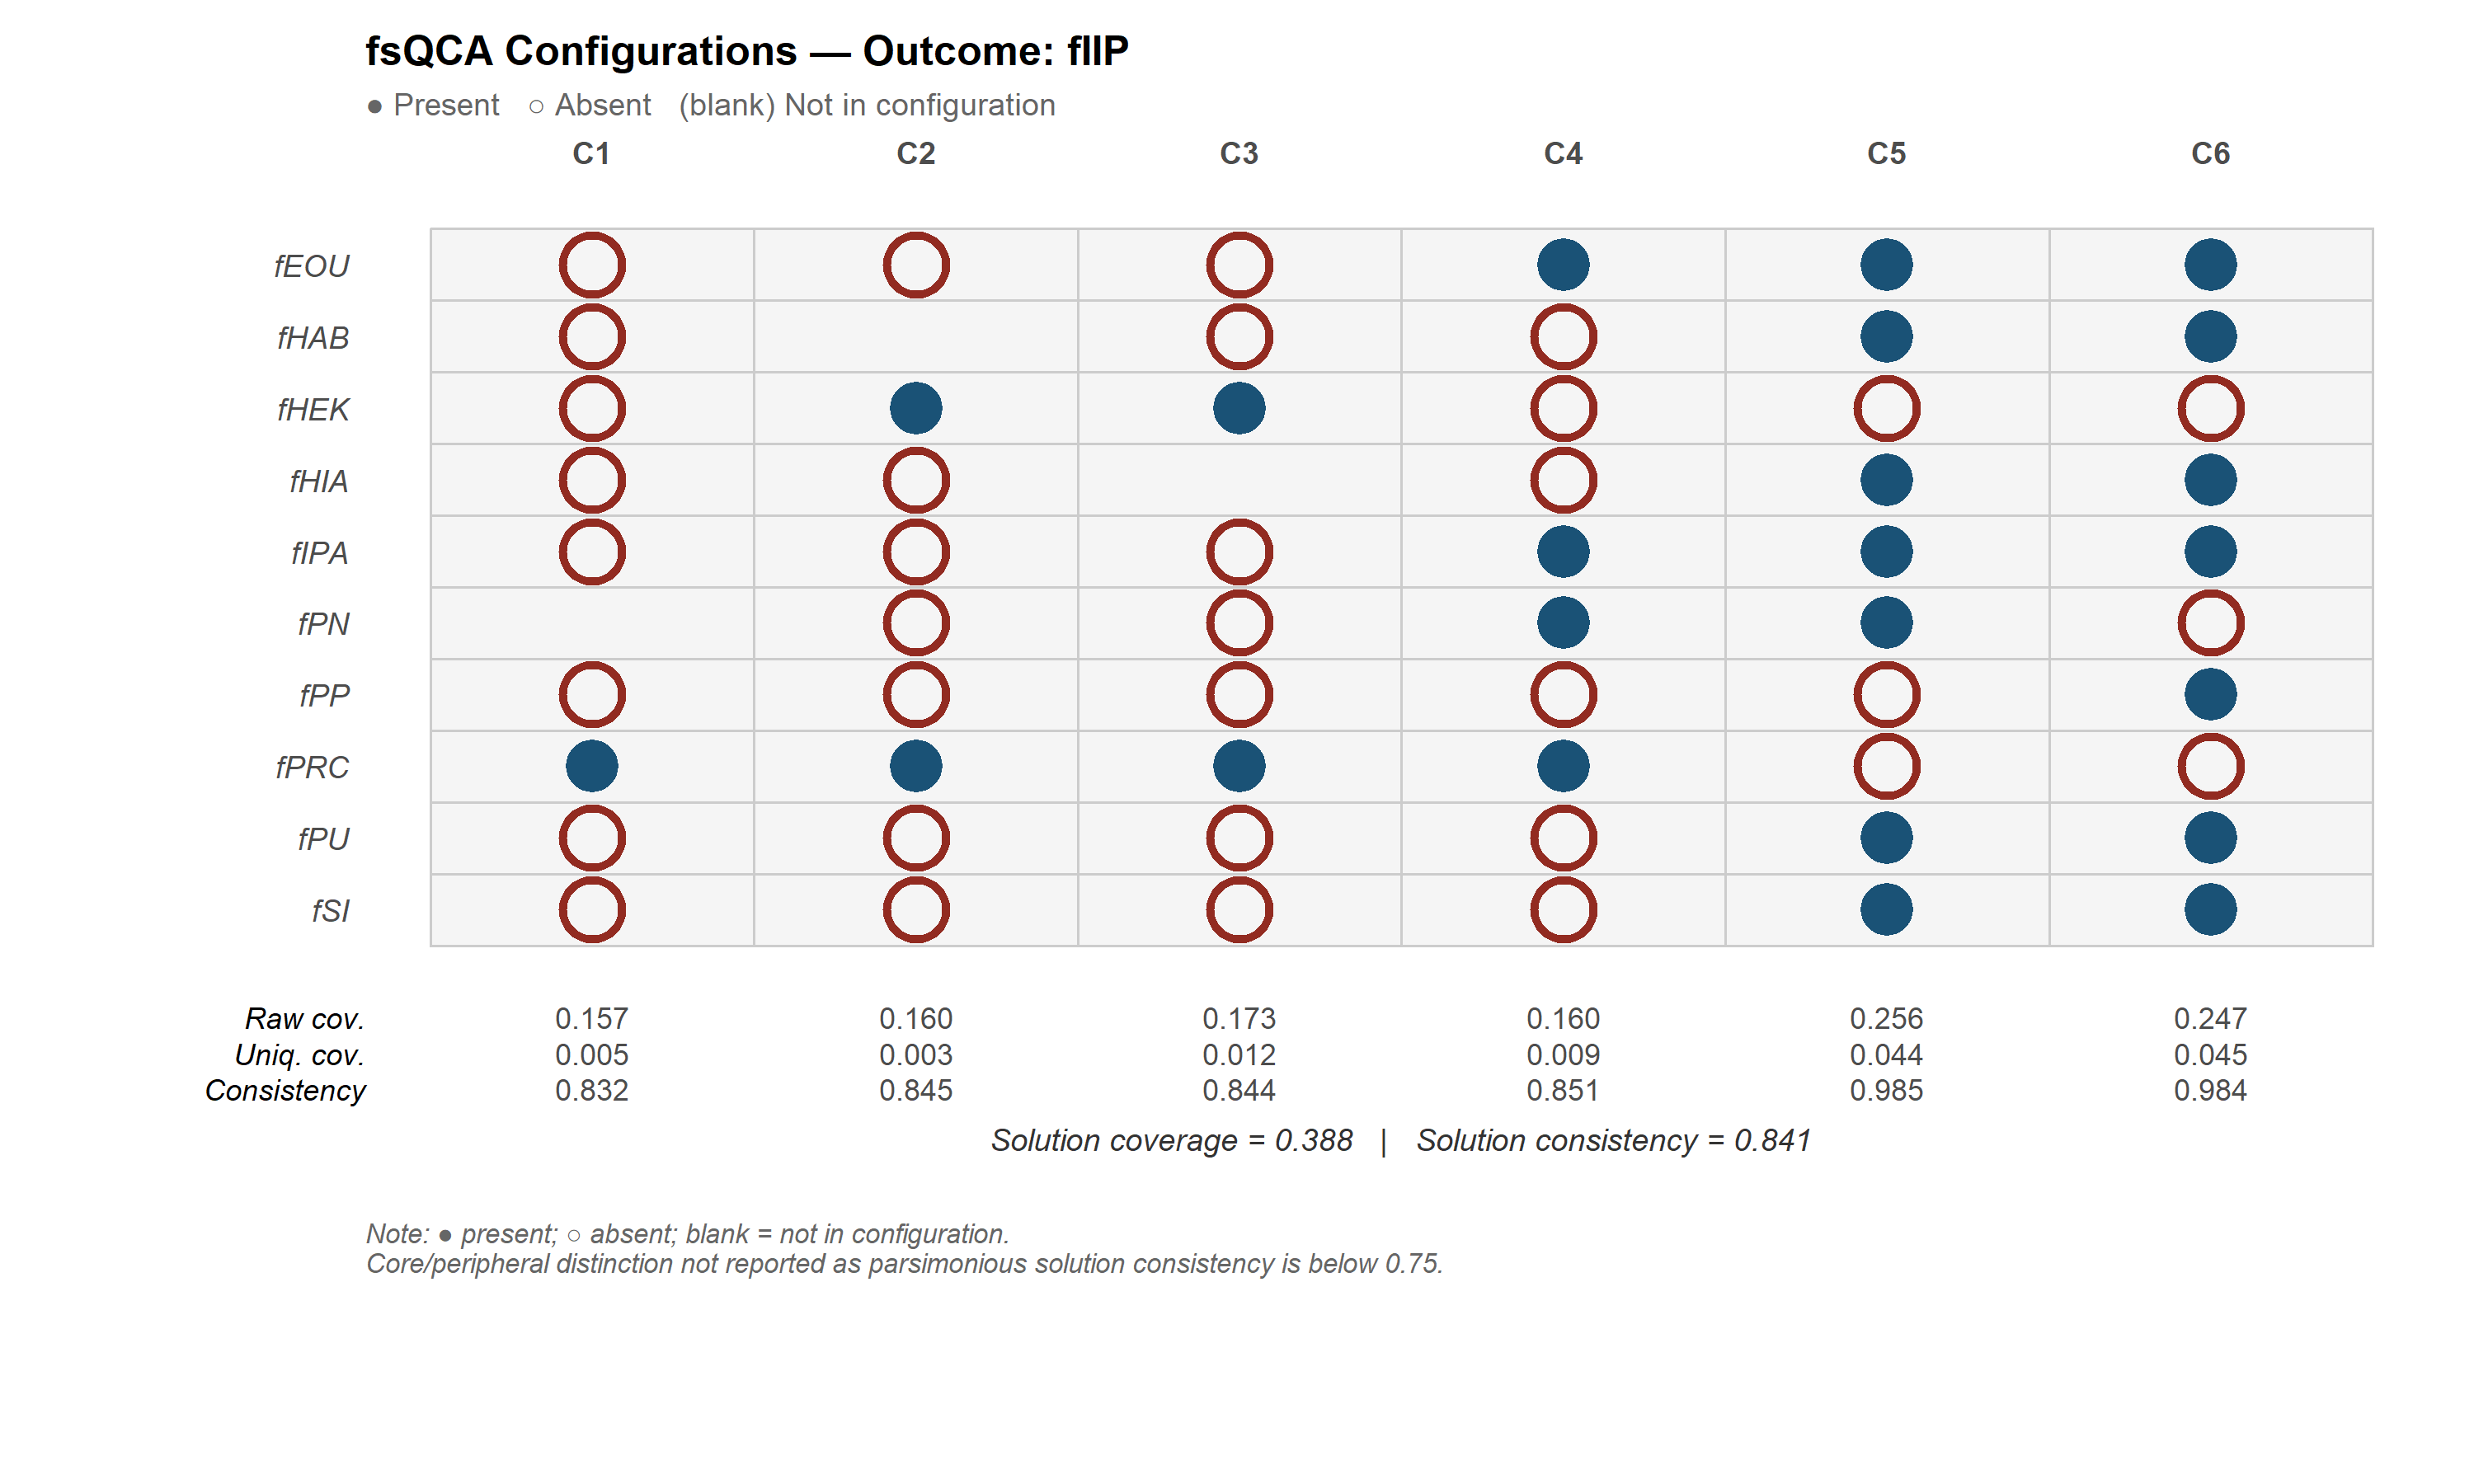
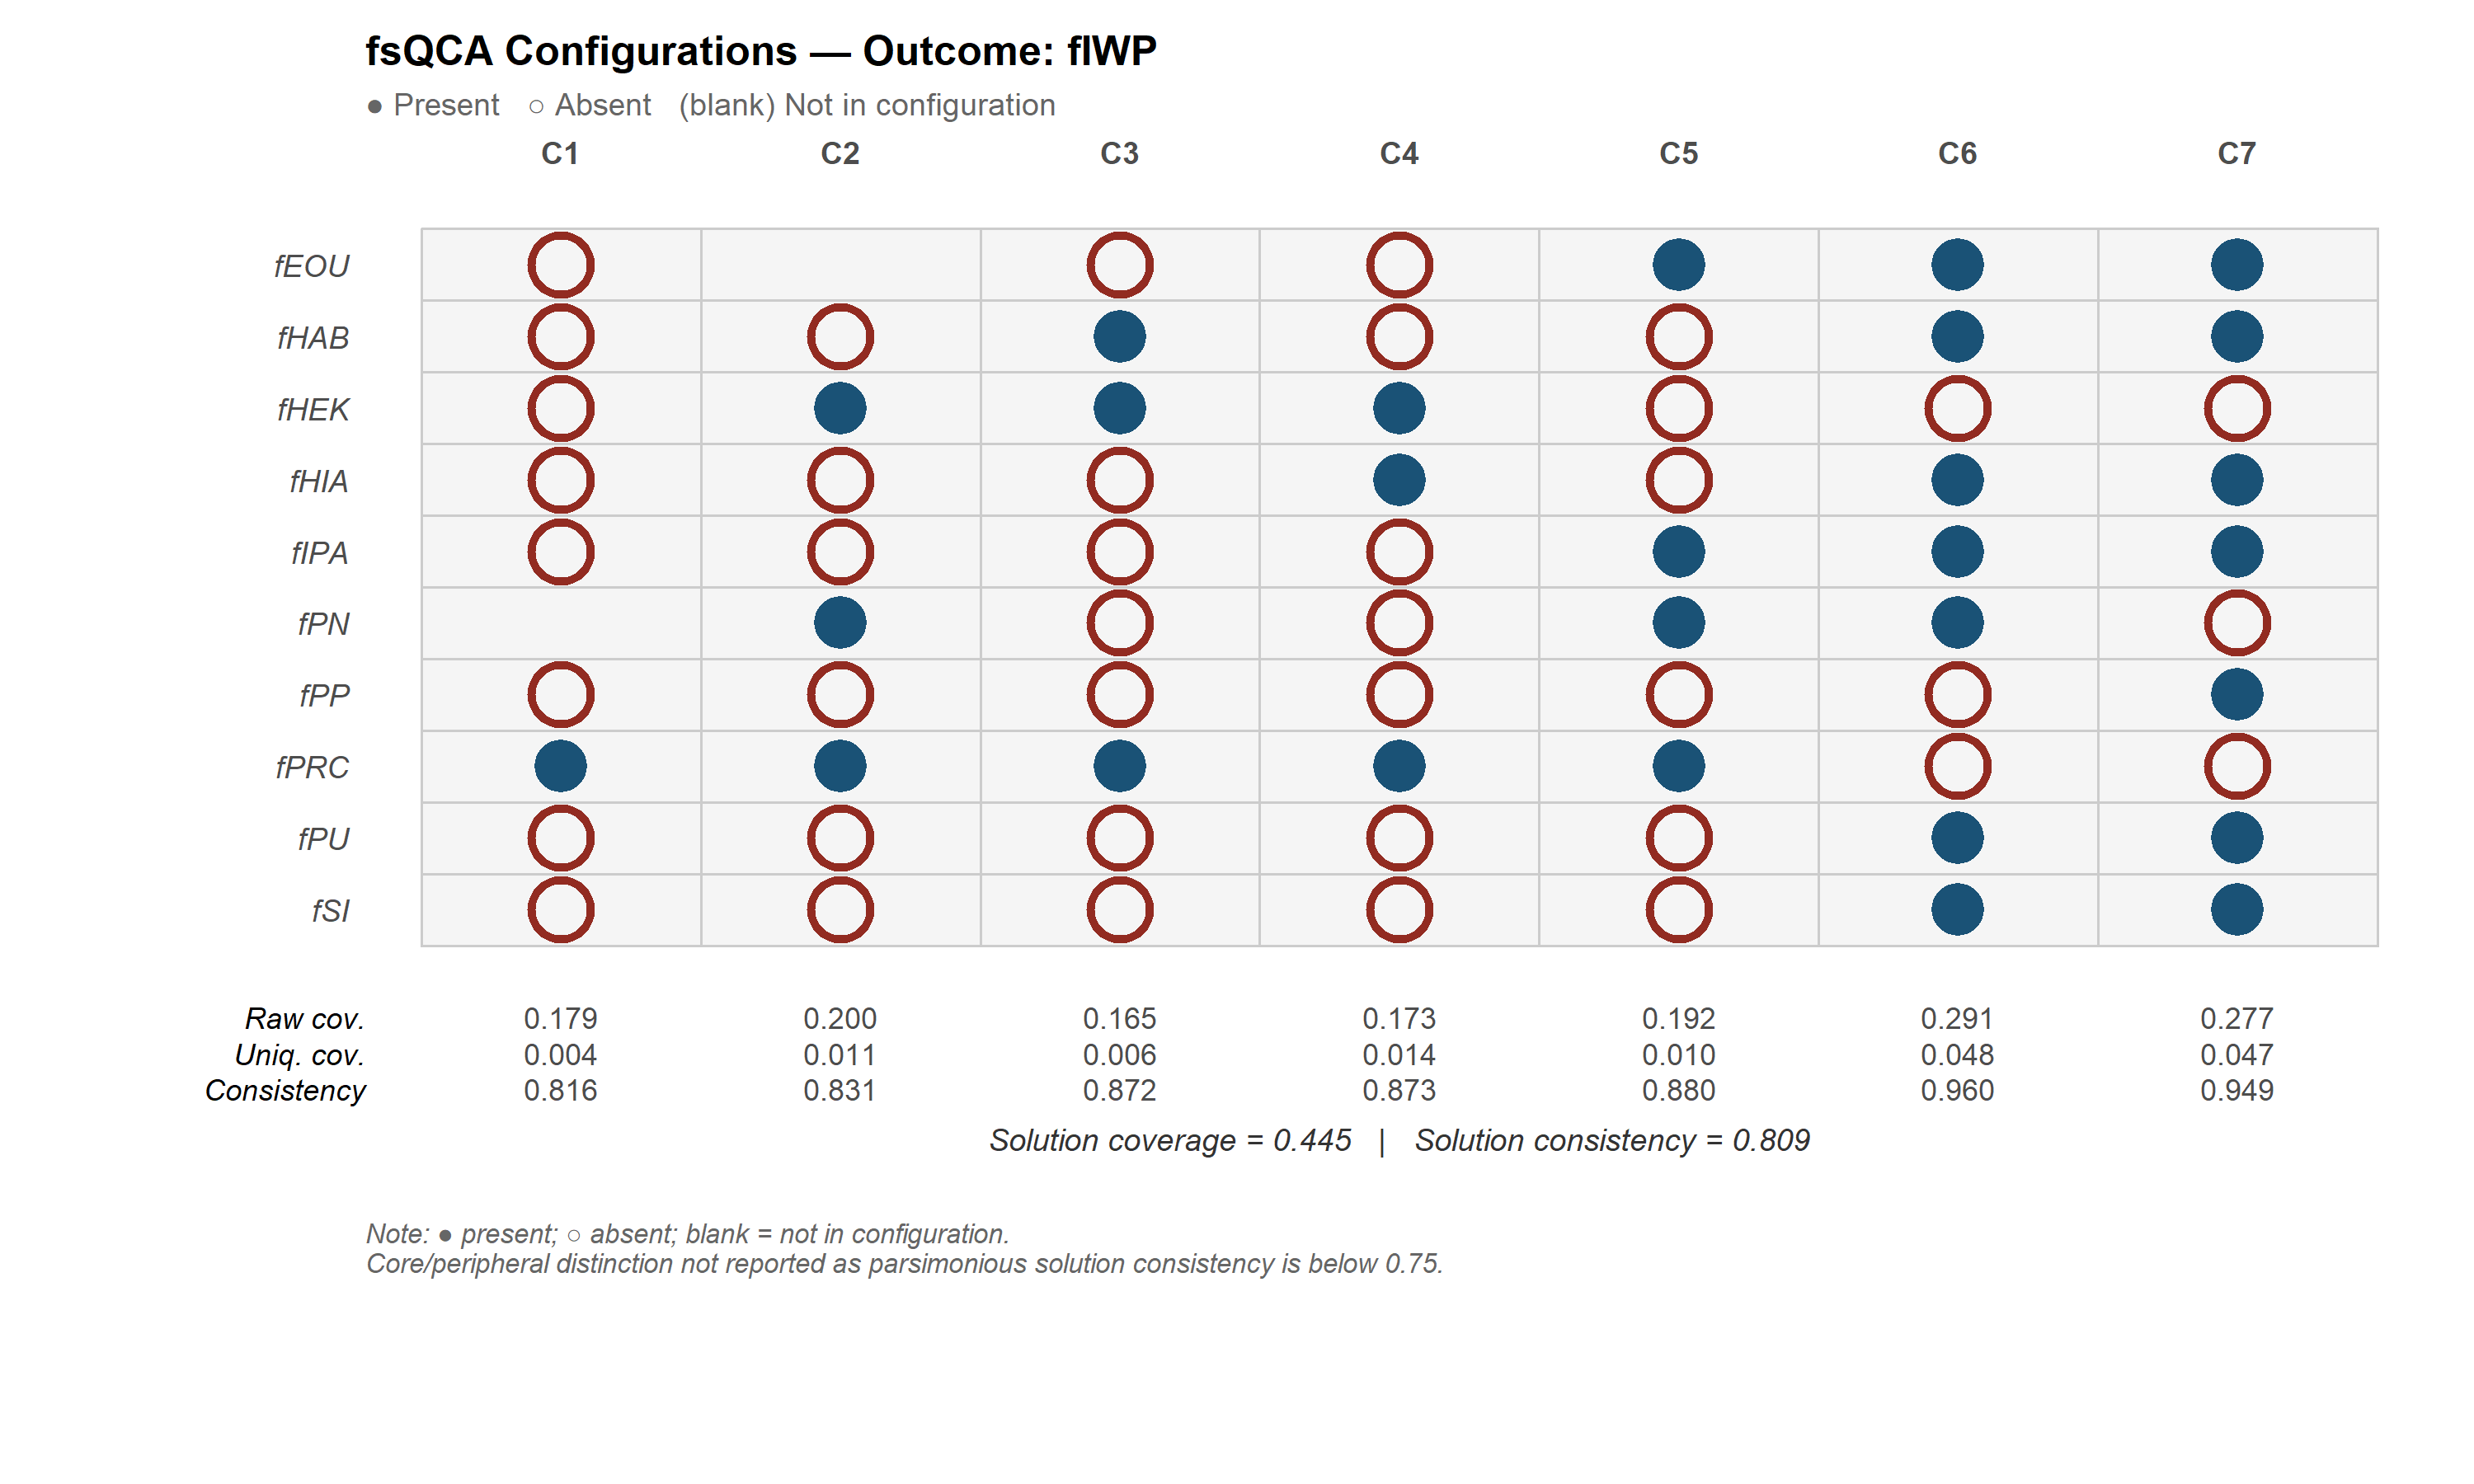
Hai hình dưới đây do Lê Minh cung cấp, lần lượt có sáu cấu hình cho fIIP và bảy cấu hình cho fIWP. Chúng được dùng để luyện đọc bảng, không chứng nhận bộ dữ liệu nền. Mỗi cột là một cấu hình; dấu tròn đặc biểu thị điều kiện có mặt, tròn rỗng là phủ định, ô trống là điều kiện không tham gia cấu hình đó. Ô trống không phải missing; tròn rỗng không có nghĩa hệ số hồi quy âm.
Với hình fIIP, cấu hình C1 có raw coverage 0,157, unique coverage 0,005 và consistency 0,832. Raw coverage phản ánh phần thành viên kết quả được C1 bao phủ, kể cả phần chồng với cấu hình khác; unique coverage là phần riêng trong mô hình nghiệm đang xét. Vì có chồng lấn, không cộng raw coverage của các cột để tính solution coverage (Ragin, 2008, tr. 64–67).
Solution coverage của fIIP là 0,388, solution consistency là 0,841. Với fIWP, hai giá trị lần lượt là 0,445 và 0,809. Không viết thành 38,8% hay 44,5% phương sai được giải thích. Cũng không kết luận nghiệm fIWP tốt hơn chỉ vì coverage cao hơn: hai outcome khác nhau và tính nhất quán cũng khác nhau. Cần hồ sơ hiệu chuẩn, truth table và trường hợp trước khi đánh giá độ phù hợp nội dung.
Ghi chú trong hình cho biết tác giả không phân biệt core/peripheral ở ví dụ này. Không biến con số 0,75 trong ghi chú hình thành quy tắc chung cho mọi phân tích. Khi đưa hình vào luận văn, nên kèm bảng mã giải nghĩa fEOU, fHAB và các tập còn lại từ bảng hỏi gốc; ở đây không tự đoán nội hàm các chữ viết tắt.
Mẫu báo cáo tiếng Việt
Mẫu có chỗ trống để thay bằng kết quả thật: Các tập [tên và định nghĩa] được hiệu chuẩn bằng phương pháp [ ], với các mốc [full-out/crossover/full-in] có căn cứ [ ]. Phân tích điều kiện cần được báo cáo riêng. Truth table dùng frequency [ ], consistency [ ] và PRI [ ], theo lý do [ ]. Nghiệm [loại] gồm [ ] cấu hình; kỳ vọng hướng và giả định đơn giản hóa là [ ]. Solution consistency bằng [ ], coverage bằng [ ]. Kiểm tra [mốc/ngưỡng/trường hợp/phủ định outcome] cho thấy [ổn định hoặc nhạy ở đâu]. Kết quả được diễn giải theo quan hệ tập hợp trong phạm vi nghiên cứu.
9. Đánh giá độ nhạy và điều kiện phải dừng kết luận
Lập một bảng đối chiếu đặc tả gốc với từng phương án thay thế có lý do. Theo dõi các điều kiện xuất hiện, cấu hình biến mất, consistency và coverage thay đổi, số trường hợp điển hình và các trường hợp mâu thuẫn. Nghiệm không cần giữ nguyên từng ký tự mới có giá trị; nhưng nếu kết luận chính đảo chiều chỉ vì thay mốc nhỏ có căn cứ, cần báo rõ tính nhạy thay vì chọn bản thuận ý.
Dừng khẳng định mạnh khi chưa có lý do hiệu chuẩn, outcome và phủ định cùng nhận quan hệ đủ khó giải thích, quá nhiều tổ hợp không có cơ sở thực nghiệm hoặc không thể truy các điểm bất thường về ID. Đó là tín hiệu xem lại thiết kế và nội dung, không phải lý do âm thầm xóa trường hợp.
Pappas và Woodside (2021) đề xuất quan tâm đến trường hợp trái chiều và kiểm tra dự báo. Nếu có mẫu kiểm tra độc lập hoặc holdout phù hợp, giữ nguyên quy tắc được xây từ mẫu phát triển khi đánh giá. Không tự gọi phân tích mẫu gộp là kiểm chứng ngoài mẫu. Kết quả nhất quán vẫn cần ranh giới suy luận và bằng chứng bối cảnh.
- Định nghĩa tập, cách tính điểm và căn cứ ba mốc rõ ràng.
- Giữ dữ liệu gốc, thành viên hiệu chuẩn và ID trong hồ sơ có kiểm soát truy cập.
- Báo điều kiện cần riêng với cấu hình đủ.
- Giữ truth table đầy đủ, ngưỡng và lý do loại/giữ dòng.
- Nêu loại nghiệm, kỳ vọng hướng và giả định đơn giản hóa.
- Báo từng cấu hình cùng solution consistency/coverage.
- Không cộng raw coverage, không gọi coverage là R².
- Phân tích ~Y riêng và kiểm tra độ nhạy theo câu hỏi nghiên cứu.
- Lưu cả kết quả không thuận với kỳ vọng; không công khai dữ liệu nhận diện.
Kết luận
Chuyên đề fsQCA thuyết phục phải cho phép người khác đi từ định nghĩa tập đến các điểm thành viên, bảng chân trị và nghiệm cuối. Bảng cấu hình là nơi trình bày kết quả; lý do chọn mốc, giả định phản thực và hiểu biết trường hợp mới giúp người đọc đánh giá ý nghĩa của kết quả ấy.
Tài liệu tham khảo
- Ragin, C. C. (2008). Redesigning social inquiry: Fuzzy sets and beyond. University of Chicago Press. Chương 2–5, 7–9. https://press.uchicago.edu/ucp/books/book/chicago/R/bo5973952.html
- Pappas, I. O., & Woodside, A. G. (2021). Fuzzy-set Qualitative Comparative Analysis (fsQCA): Guidelines for research practice in Information Systems and marketing. International Journal of Information Management, 58, 102310. https://doi.org/10.1016/j.ijinfomgt.2021.102310
- Ragin, C. C. (2017). User’s guide to Fuzzy-Set / Qualitative Comparative Analysis (fsQCA 3.0). University of California, Irvine. https://sites.socsci.uci.edu/~cragin/fsQCA/download/fsQCAManual.pdf
Ghi chú học thuật: Các bảng và phép tính nhỏ được biên soạn để minh họa, tách khỏi hình fIIP/fIWP do chủ sở hữu cung cấp. Công thức và logic tập hợp được đối chiếu sách Ragin (2008). Các ngưỡng cần được biện minh theo thiết kế và tri thức trường hợp, không xem như tiêu chuẩn bất biến.