
EFA dữ liệu Likert bằng SPSS, R và FACTOR: quy trình có thể tái lập
SPSS thuận tiện cho EFA trên ma trận Pearson, nhưng dữ liệu Likert ít mức hoặc lệch mạnh có thể cần polychoric và parallel analysis ordinal. Bài này đưa ba phần mềm vào cùng một quy trình ra quyết định.
Người đọc sẽ biết khi nào dùng SPSS, R hoặc FACTOR; cách kiểm tra dữ liệu, chọn correlation matrix, xác định số nhân tố, trích và xoay, xử lý cảnh báo, so nghiệm độ nhạy và viết báo cáo có thể tái lập.
1. Mục tiêu và dữ liệu đầu vào
Quy trình áp dụng cho item Likert dùng để khám phá cấu trúc thang đo. Bạn cần một tệp dữ liệu hình chữ nhật, mỗi hàng là một người trả lời, mỗi cột là một item; codebook phải nêu item nghịch, giá trị thiếu và phạm vi hợp lệ.
EFA không thay thế lý thuyết. Trước khi mở phần mềm, lập bảng item, cấu trúc dự kiến và phần miền nội dung mà mỗi item đại diện. Phần mềm chỉ phân tích quan hệ giữa các cột, không biết câu hỏi nào quan trọng về mặt nội dung (Fabrigar & Wegener, 2012; Finch et al., 2016).
- Có codebook và quy tắc đảo mã.
- Mỗi item có nhãn nội dung ngắn.
- Đã xác định item là ordinal hay có thể xem gần liên tục.
- Có kế hoạch giữ mẫu CFA hoặc thu mẫu xác nhận.
- Không gộp các công cụ thuộc miền hoàn toàn khác chỉ vì nằm trong cùng tệp.
2. Bản đồ quyết định phần mềm
Không có phần mềm tốt nhất cho mọi trường hợp. SPSS phù hợp với quy trình Pearson, PAF và xoay oblique. R phù hợp khi cần tự động hóa và so nhiều đặc tả. FACTOR cung cấp polychoric và parallel analysis trong một công cụ chuyên cho EFA (Lorenzo-Seva & Ferrando, 2006).
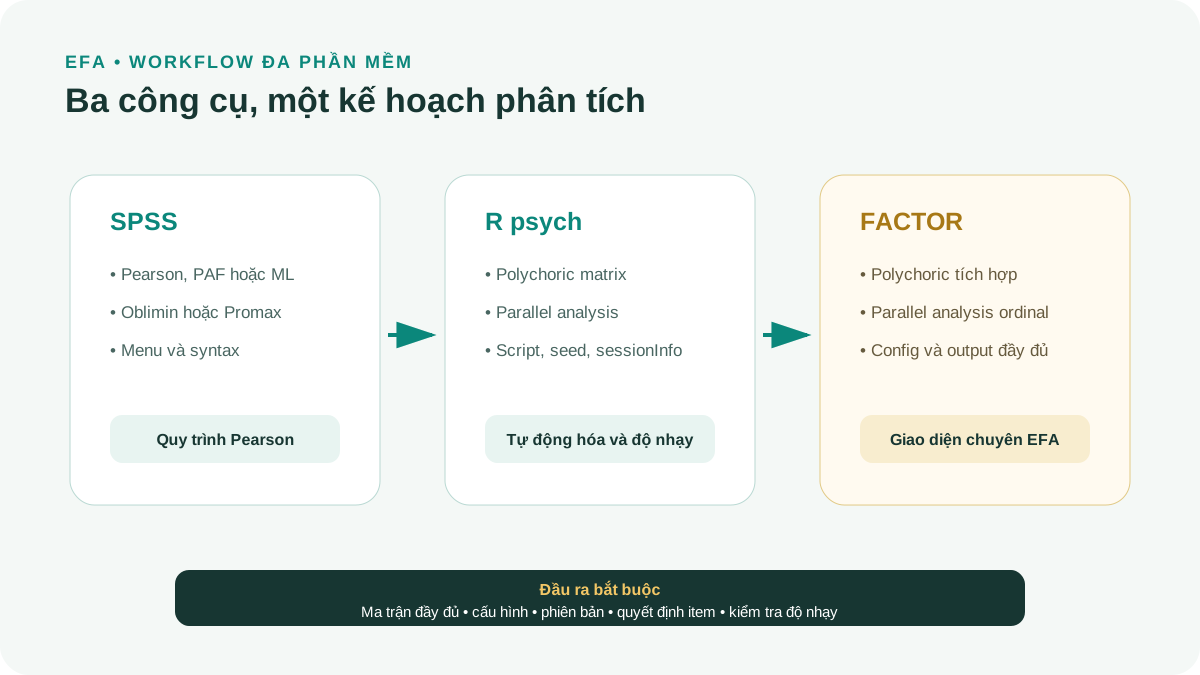
| Nhu cầu | SPSS | R psych | FACTOR |
|---|---|---|---|
| EFA Pearson bằng menu | Rất phù hợp | Thực hiện được | Thực hiện được |
| Polychoric | Không có trong hộp thoại FACTOR mặc định | Có | Có |
| Parallel analysis ordinal | Cần bổ sung quy trình | Có | Có |
| Lưu script tái lập | Syntax | Script R | Tệp cấu hình và output |
| Người mới ít dùng code | Dễ | Cần học lệnh | Giao diện thân thiện |
3. Bước 1: làm sạch và kiểm tra mã hóa
Lập bảng tần suất cho từng item. Tìm giá trị ngoài phạm vi, biến không có phương sai, item nghịch chưa đảo, ô đáp án rất thưa và missing được mã bằng số như 99. Một item chưa đảo có thể tạo tải âm hoặc nhân tố giả.
Nếu có dữ liệu thiếu, nêu cơ chế xử lý trước EFA. Listwise deletion làm giảm N và có thể thay đổi thành phần mẫu. Không thay missing bằng trung bình từng item một cách mặc định vì phương sai và correlation có thể bị thu hẹp.
- Tần suất mọi item nằm đúng phạm vi.
- Item nghịch đã đảo bằng công thức có lưu vết.
- Mã missing không còn được xem như đáp án.
- Ghi số người còn lại sau xử lý.
- Kiểm tra cặp item có wording gần như trùng nhau.
4. Bước 2: chọn Pearson hoặc polychoric
Pearson thường là lựa chọn có thể bảo vệ khi item có ít nhất năm mức, phân bố không quá lệch và các cặp đáp án không quá thưa (Rhemtulla et al., 2012). Polychoric mô hình hóa hai biến liên tục tiềm ẩn bị phân loại thành các mức thứ bậc. Nó đáng cân nhắc khi item có ít mức hoặc phân bố tập trung mạnh (Flora & Curran, 2004; Watkins, 2018).
Polychoric không tự động tốt hơn. Khi N nhỏ và nhiều ô của bảng chéo bằng 0, estimate có thể không ổn định hoặc ma trận không positive definite. Vì vậy, kiểm tra độ nhạy giữa Pearson và polychoric thường hữu ích hơn việc áp dụng một khẩu hiệu cho toàn bộ dữ liệu Likert.
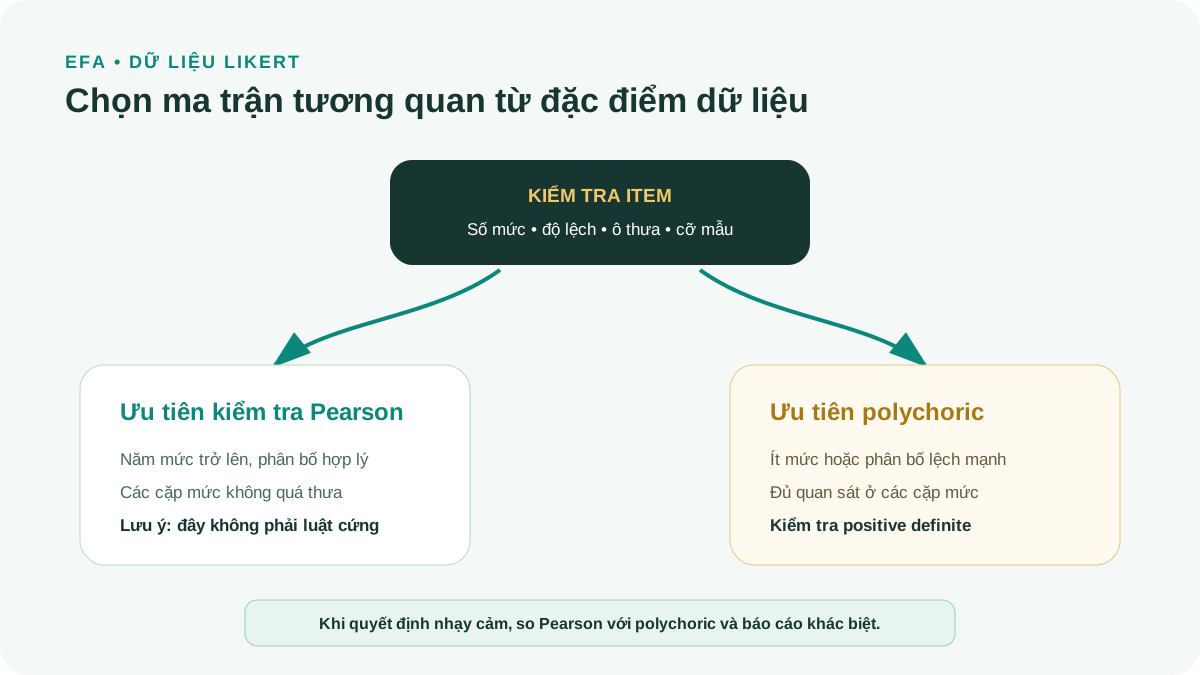
| Dấu hiệu | Ưu tiên kiểm tra | Cảnh báo |
|---|---|---|
| 5-7 mức, phân bố tương đối đều | Pearson | Vẫn kiểm tra độ nhạy nếu quyết định quan trọng |
| 2-4 mức hoặc lệch mạnh | Polychoric | Cần đủ quan sát ở các cặp mức |
| Nhiều ô trống | Gộp mức có căn cứ hoặc tăng mẫu | Không gộp chỉ để ép thuật toán chạy |
| Nghiệm hai ma trận khác nhau | Báo cáo cả hai | Không chọn nghiệm thuận lợi mà không giải thích |
5. Bước 3: chọn số nhân tố bằng parallel analysis
Eigenvalue lớn hơn 1 không nên là căn cứ duy nhất. Parallel analysis so eigenvalue quan sát với phân bố eigenvalue từ dữ liệu ngẫu nhiên. MAP và scree plot cung cấp bằng chứng bổ sung; số nhân tố cuối còn phải có ý nghĩa và đủ item chất lượng (O'Connor, 2000; Watkins, 2018).
Với ordinal data, dùng parallel analysis phù hợp ma trận polychoric. Garrido và cộng sự (2013) cho thấy đặc điểm ordinal ảnh hưởng kết quả giữ nhân tố. Ghi phương pháp tạo dữ liệu tham chiếu, số lần lặp và percentile nếu phần mềm cho phép.
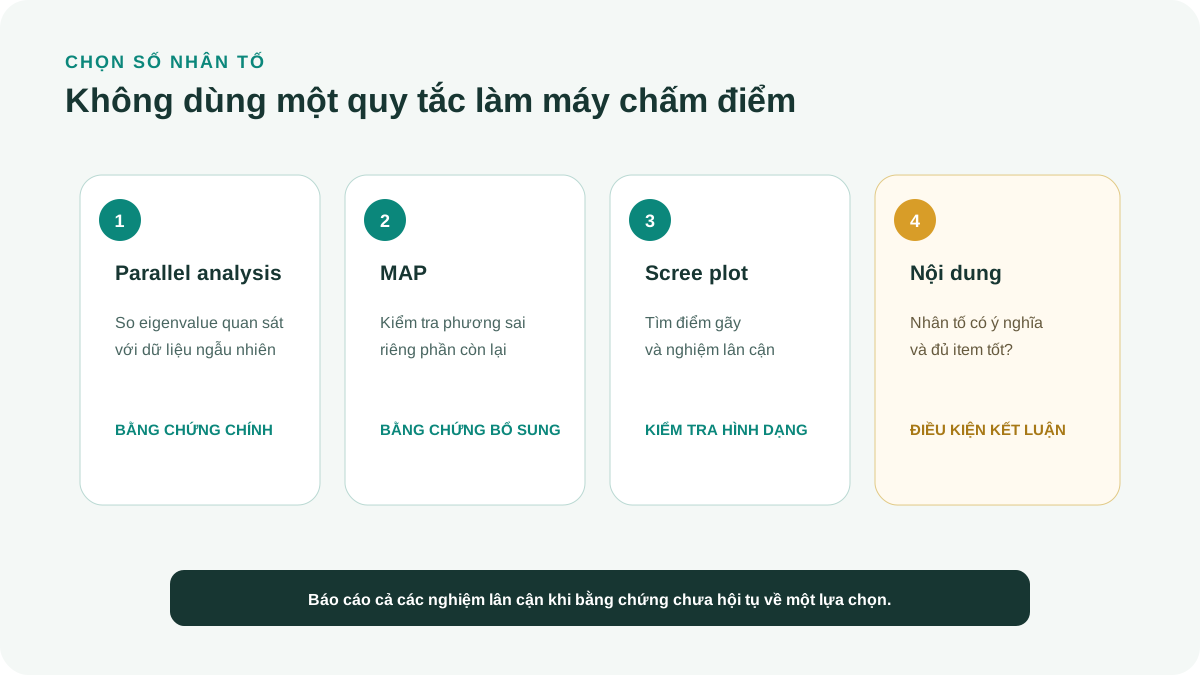
So các nghiệm lân cận là hợp lệ khi được trình bày minh bạch. Việc thử nhiều nghiệm rồi chỉ báo cáo nghiệm đẹp nhất tạo ra lựa chọn thuận lợi sau dữ liệu.
6. Bước 4A: chạy EFA trong SPSS
IBM xác nhận hộp thoại Factor cung cấp PAF, ML và các rotation oblique, nhưng mặc định lệnh FACTOR là PCA với Varimax nếu không chỉ định khác (IBM, n.d.). Vì vậy, không bấm OK liên tục theo mặc định.
Mở Factor
Chọn Analyze > Dimension Reduction > Factor và đưa các item cùng miền đo vào Variables.
Chọn Descriptives
Yêu cầu KMO and Bartlett, anti-image và reproduced correlations.
Chọn Extraction
Đổi mặc định Principal Components thành Principal Axis Factoring; bật scree plot.
Nhập số nhân tố
Dùng Fixed number of factors theo kết quả parallel analysis và lý thuyết.
Chọn Rotation
Dùng Direct Oblimin hoặc Promax khi các nhân tố có thể tương quan.
Đọc đủ output
Xem communalities, pattern, structure, factor correlations và residuals.
Lưu syntax
Bấm Paste trước khi Run để lưu đặc tả có thể tái lập.
7. Bước 4B: chạy EFA ordinal trong R
Một skeleton tối thiểu gồm đọc dữ liệu, chọn item, kiểm tra tần suất, tạo polychoric matrix, chạy parallel analysis và fa với số nhân tố đã chọn. Đặt seed nếu quy trình có mô phỏng. Lưu sessionInfo để người khác biết phiên bản R và package.
Các tên hàm có thể thay đổi theo phiên bản. Tài liệu package psych cung cấp polychoric, fa.parallel và fa; hãy đọc help của phiên bản đang dùng thay vì chép code không kiểm tra (Revelle, 2026).
Mẫu báo cáo tiếng Việt
items <- dat[c('q1','q2','q3','q4','q5','q6')] poly <- psych::polychoric(items)$rho set.seed(20261023) psych::fa.parallel(poly, n.obs = nrow(items), fa = 'fa') fit <- psych::fa(poly, nfactors = 2, n.obs = nrow(items), fm = 'minres', rotate = 'oblimin') print(fit$loadings, cutoff = 0) fit$Phi
8. Bước 4C: chạy trong FACTOR
Nhập tệp dữ liệu và khai báo item là ordinal. Chọn polychoric correlations, parallel analysis và một common factor estimator. Dùng oblique rotation nếu các cấu trúc có thể liên hệ. Xuất toàn bộ output và tệp cấu hình thay vì chỉ chụp bảng tải.
FACTOR được xây dựng để đưa các thủ tục như polychoric và parallel analysis vào EFA thực hành (Lorenzo-Seva & Ferrando, 2006). Giao diện có thể thay đổi giữa các phiên bản nên tên menu phải được đối chiếu với manual hiện hành.
- Đúng định dạng decimal và missing.
- Đúng số mức của từng item.
- Parallel analysis dùng loại dữ liệu phù hợp.
- Estimator và rotation được ghi lại.
- Output không có cảnh báo ma trận hoặc Heywood.
9. Bước 5: đọc output theo cùng một thứ tự
Đọc số nhân tố và khả năng hội tụ trước. Sau đó xem communality, pattern matrix, factor correlations và residuals. Với oblique rotation, structure matrix không thay thế pattern matrix vì nó còn phản ánh tương quan giữa các nhân tố (Finch et al., 2016).
Đặt tên nhân tố từ phần nội dung chung của nhiều item tải mạnh. Không đặt tên từ một item nổi bật. Nếu một nhân tố chủ yếu gồm item nghịch hoặc câu có wording giống nhau, xem xét method effect.
| Bảng | Câu hỏi | Dấu hiệu cần điều tra |
|---|---|---|
| Parallel analysis | Giữ bao nhiêu nhân tố? | Nghiệm sát biên hoặc khác lý thuyết |
| Communalities | Item được giải thích bao nhiêu? | Nhiều item rất thấp |
| Pattern matrix | Item gắn riêng với nhân tố nào? | Tải thấp hoặc cross-loading |
| Factor correlations | Các nhân tố phân biệt đến đâu? | Tương quan quá cao |
| Residuals | Mô hình tái tạo correlation tốt không? | Nhiều residual lớn |
10. Bước 6: xử lý cảnh báo và nghiệm bất thường
| Cảnh báo | Khả năng | Hành động |
|---|---|---|
| Correlation matrix not positive definite | Item trùng, polychoric bất ổn hoặc ô thưa | Xem eigenvalues, cặp item và tần suất |
| Heywood case | Communality lớn hơn 1 hoặc uniqueness âm | Xem số nhân tố, item, estimator và N |
| Không hội tụ | Mô hình quá phức tạp hoặc dữ liệu yếu | Giảm độ phức tạp có căn cứ, không chỉ tăng iterations |
| Nhân tố có 1-2 item | Underidentification nội dung | Viết thêm item hoặc xem lại số nhân tố |
| Nghiệm đổi dấu | Factor sign indeterminacy | Không xem đổi dấu toàn bộ là thay đổi ý nghĩa |
11. Bước 7: kiểm tra độ nhạy giữa các đặc tả
Lập trước một primary analysis và một sensitivity analysis. Ví dụ, primary dùng polychoric, MINRES và oblimin; sensitivity dùng Pearson, PAF và Promax. So số nhân tố, item membership, tải chính và tương quan nhân tố.
Nếu hai nghiệm giống về cấu trúc, kết luận ổn định hơn. Nếu khác, tìm nguyên nhân từ item lệch, ô thưa hoặc lựa chọn estimator. Không dùng độ nhạy để thử vô hạn cho đến khi có kết quả mong muốn.
Primary analysis được chọn trước từ loại dữ liệu. Sensitivity analysis kiểm tra mức phụ thuộc vào giả định. Decision rule nói rõ khác biệt nào sẽ làm thay đổi kết luận.
12. Ví dụ giả định: ba phần mềm, một quyết định
Các số dưới đây được tạo để hướng dẫn. Bộ 15 item Likert bốn mức có N = 360. Bốn item lệch mạnh. Parallel analysis Pearson đề xuất bốn nhân tố, còn polychoric đề xuất ba; scree và bản đồ nội dung ủng hộ ba.
SPSS với Pearson, PAF và Promax cho Q09 tải 0,41 lên F2 và 0,38 lên F3. R và FACTOR với polychoric cho Q09 tải 0,52 lên F2 và 0,20 lên F3. Nhóm đọc lại câu hỏi, nhận thấy đáp án hiếm làm Pearson suy giảm correlation. Primary ordinal giữ Q09; sensitivity result được báo cáo thay vì che đi.
| Đặc tả | Số nhân tố | Q09 | Quyết định |
|---|---|---|---|
| SPSS Pearson, PAF, Promax | 4 theo PA Pearson; so thêm 3 | 0,41 / 0,38 | Nghiệm nhạy với ma trận |
| R polychoric, MINRES, oblimin | 3 | 0,52 / 0,20 | Giữ trong primary |
| FACTOR polychoric | 3 | Gần nghiệm R | Củng cố khả năng tái lập |
13. Tám lỗi thường gặp
| Lỗi | Hậu quả | Cách sửa |
|---|---|---|
| Dùng SPSS mặc định | PCA và Varimax ngoài ý định | Chỉ định PAF/ML và rotation |
| Chỉ dùng KMO/Bartlett | Không quyết định được số nhân tố | Thêm PA, MAP, scree và lý thuyết |
| Gọi mọi Likert là continuous | Bỏ qua ordinal và skew | Kiểm tra số mức, phân bố, ô thưa |
| Dùng polychoric không kiểm tra | Ma trận bất ổn | Xem cảnh báo và độ nhạy |
| Ẩn loading nhỏ | Mất dấu cross-loading | Giữ ma trận đầy đủ trong hồ sơ |
| Chỉ chụp màn hình | Không tái lập | Lưu syntax, script, config và version |
| Xóa nhiều item cùng lượt | Không biết item nào làm nghiệm đổi | Một item mỗi vòng |
| CFA ngay trên cùng mẫu | Fit quá lạc quan | Giữ mẫu xác nhận |
14. Mẫu báo cáo APA 7 và bảng kiểm
Mẫu báo cáo tiếng Việt
EFA được thực hiện trên [n] quan sát và [p] item [số mức]. Primary analysis dùng ma trận [Pearson/polychoric], [estimator/extraction] và xoay [ ]. Số nhân tố được chọn bằng parallel analysis [chi tiết] kết hợp scree plot và nội dung. Sensitivity analysis dùng [đặc tả] cho kết quả [giống/khác]. Nghiệm cuối có pattern loading [khoảng], communality [khoảng] và tương quan nhân tố [khoảng]. Phân tích được chạy bằng [phần mềm, phiên bản], script và output được lưu tại [ ].
- Nêu cách mã hóa và xử lý missing.
- Nêu số mức và phân bố item.
- Nêu Pearson hoặc polychoric.
- Nêu phần mềm và phiên bản.
- Nêu parallel analysis và cấu hình.
- Nêu estimator hoặc extraction.
- Nêu rotation.
- Báo cáo pattern matrix đầy đủ.
- Báo cáo factor correlations.
- Nêu cảnh báo và cách xử lý.
- Phân biệt primary và sensitivity analysis.
- Ghi từng item bị loại hoặc viết lại.
- Không coi cutoff là luật tuyệt đối.
- Lưu syntax, seed và session information.
- Dùng CFA hoặc mẫu độc lập để xác nhận.
Kết luận
Khác biệt quan trọng không nằm ở logo phần mềm mà ở ma trận tương quan, cách giữ nhân tố và khả năng tái lập. SPSS, R và FACTOR có thể bổ sung cho nhau nếu cùng phục vụ một kế hoạch phân tích được xác định trước.
Với dữ liệu Likert, hãy để loại dữ liệu quyết định primary analysis và dùng sensitivity analysis để kiểm tra kết luận. Không chọn phần mềm hoặc nghiệm chỉ vì nó tạo ma trận tải dễ nhìn hơn.
Tài liệu tham khảo
- Fabrigar, L. R., & Wegener, D. T. (2012). Exploratory factor analysis. Oxford University Press. https://doi.org/10.1093/acprof:osobl/9780199734177.001.0001
- Finch, W. H., Immekus, J. C., & French, B. F. (2016). Applied psychometrics using SPSS and AMOS. Information Age Publishing. https://www.infoagepub.com/products/Applied-Psychometrics-using-SPSS-and-AMOS
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466-491. https://doi.org/10.1037/1082-989X.9.4.466
- Garrido, L. E., Abad, F. J., & Ponsoda, V. (2013). A new look at Horn's parallel analysis with ordinal variables. Psychological Methods, 18(4), 454-474. https://doi.org/10.1037/a0030005
- IBM. (n.d.). Factor analysis extraction. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-extraction
- Lorenzo-Seva, U., & Ferrando, P. J. (2006). FACTOR: A computer program to fit the exploratory factor analysis model. Behavior Research Methods, 38, 88-91. https://doi.org/10.3758/BF03192753
- O'Connor, B. P. (2000). SPSS and SAS programs for determining the number of components using parallel analysis and Velicer's MAP test. Behavior Research Methods, Instruments, & Computers, 32(3), 396-402. https://doi.org/10.3758/BF03200807
- Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research. https://cran.r-project.org/package=psych
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354-373. https://doi.org/10.1037/a0029315
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219-246. https://doi.org/10.1177/0095798418771807
Ghi chú học thuật: Tên menu và mặc định có thể thay đổi theo phiên bản. Đối chiếu manual phần mềm đang dùng và lưu toàn bộ cấu hình để tái lập kết quả.