
GoF, R², f² và dự báo trong SmartPLS 4: đánh giá mô hình theo cách dùng hiện nay
GoF từng được dùng như một con số tổng hợp cho PLS-SEM, nhưng không thể phân biệt đáng tin cậy mô hình đúng với mô hình sai. Báo cáo hiện nay cần tách sức giải thích trong mẫu khỏi năng lực dự báo ngoài mẫu.
Không dùng GoF để kết luận mô hình PLS-SEM phù hợp. Hãy đánh giá mô hình đo lường trước, sau đó đọc hệ số đường dẫn, khoảng tin cậy, R², f², PLSpredict và CVPAT theo đúng câu hỏi mà từng chỉ số trả lời.
1. GoF được xây dựng để làm gì?
GoF được phát triển như một chỉ số tổng hợp giữa chất lượng mô hình đo lường và sức giải thích của mô hình cấu trúc. Công thức thường gặp là căn bậc hai của tích giữa communality trung bình và R² trung bình. Trong cách trình bày ban đầu, chỉ số này được kỳ vọng cho một cái nhìn toàn cục về mô hình PLS path modeling (Tenenhaus và cộng sự, 2005).
Vấn đề nằm ở khả năng chẩn đoán. Mô phỏng của Henseler và Sarstedt (2013) cho thấy GoF và GoF tương đối không phù hợp để xác nhận mô hình vì chúng không phân biệt ổn định mô hình được đặc tả đúng với mô hình bị đặc tả sai. Tài liệu SmartPLS hiện cũng khuyến nghị không dùng GoF như thước đo phù hợp tổng quát (SmartPLS, n.d.-a).
Các mốc 0,10; 0,25 và 0,36 từng được gắn nhãn nhỏ, trung bình và lớn. Những mốc này không sửa được hạn chế chẩn đoán của chỉ số. Một GoF cao vẫn có thể đi cùng mô hình đo lường có vấn đề hoặc đường dẫn cấu trúc bị đặc tả sai.
Không viết: “GoF = 0,42, vì vậy mô hình phù hợp tốt”. Giá trị này không phải bằng chứng đủ để chấp nhận mô hình PLS-SEM.
2. Thay GoF bằng một chuỗi bằng chứng
Không có một chỉ số duy nhất thay thế GoF. Mỗi lớp đánh giá trả lời một câu hỏi riêng. Mô hình đo lường cho biết các chỉ báo đại diện cho khái niệm ra sao; mô hình cấu trúc cho biết quan hệ ước lượng và sức giải thích trong mẫu; đánh giá dự báo cho biết mô hình hoạt động thế nào trên dữ liệu giữ lại.
Mục tiêu nghiên cứu quyết định trọng tâm báo cáo. Nghiên cứu giải thích vẫn cần xem dự báo để nhận diện mô hình có vẻ tốt trong mẫu nhưng tổng quát kém. Nghiên cứu định hướng dự báo không được bỏ qua tính hợp lệ của phép đo và cơ sở lý thuyết.
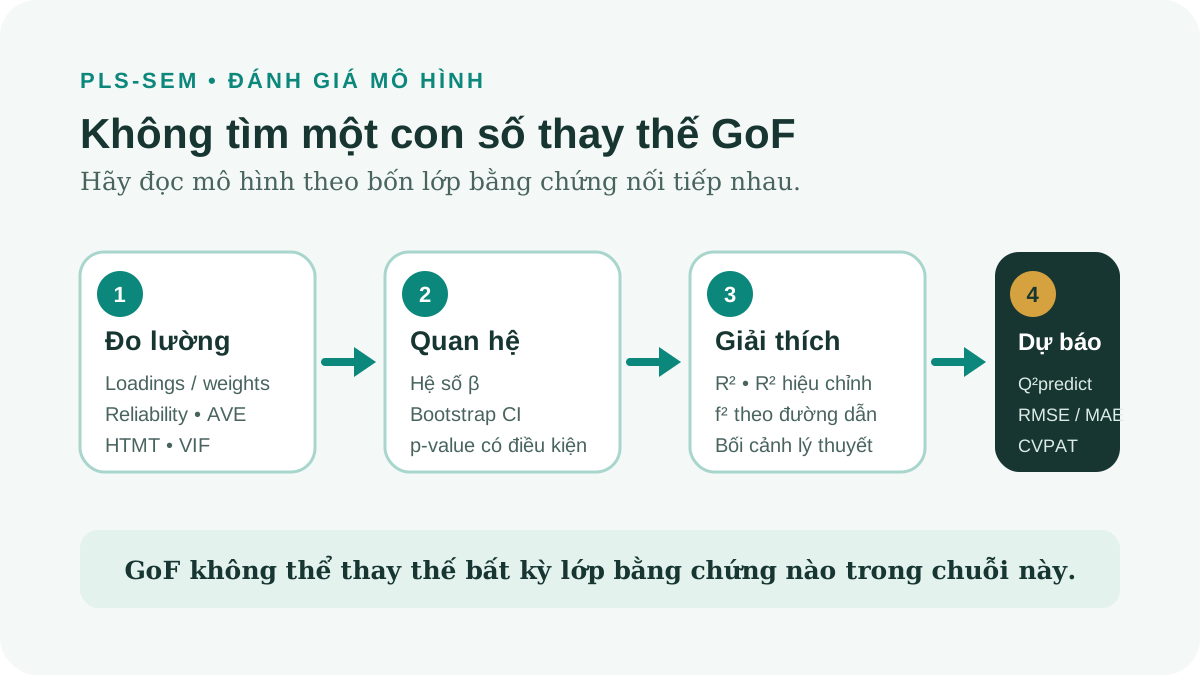
| Lớp đánh giá | Câu hỏi | Đầu ra chính |
|---|---|---|
| Mô hình đo lường | Chỉ báo đo đúng khái niệm không? | Outer loadings hoặc weights, reliability, AVE, HTMT, VIF |
| Quan hệ cấu trúc | Hướng và độ bất định của quan hệ là gì? | β, bootstrap CI và p-value |
| Giải thích trong mẫu | Mô hình giải thích bao nhiêu phương sai? | R² và R² hiệu chỉnh |
| Đóng góp riêng | Bỏ X thì R² của Y giảm bao nhiêu? | f² theo từng đường dẫn |
| Dự báo ngoài mẫu | Mô hình dự báo dữ liệu giữ lại tốt đến đâu? | Q²predict, RMSE hoặc MAE, benchmark LM |
| Kiểm định năng lực dự báo | Sai số của PLS-SEM có thấp hơn benchmark không? | CVPAT và chênh lệch loss |
3. Điều kiện tiên quyết trước khi đọc R² và dự báo
Chỉ đánh giá mô hình cấu trúc sau khi mô hình đo lường đã được xem xét theo đúng loại cấu trúc. Với thang phản ánh, người đọc cần kiểm tra tải ngoài, độ tin cậy, giá trị hội tụ và giá trị phân biệt. Với cấu trúc tạo thành, outer weights, đa cộng tuyến và tính bao quát nội dung cần được ưu tiên.
Đặc tả mô hình phải được giữ nhất quán giữa PLS-SEM Algorithm, bootstrapping và PLSpredict. Nếu thay chỉ báo, loại quan sát hoặc sửa đường dẫn giữa các lần chạy, các bảng không còn thuộc cùng một mô hình. Hãy lưu phiên bản dữ liệu, mô hình và cài đặt trước khi so sánh kết quả.
- Đã xác định mô hình đo lường phản ánh hay tạo thành.
- Đã hoàn tất kiểm tra độ tin cậy và giá trị đo lường phù hợp.
- Đã rà VIF và các cảnh báo ước lượng.
- Dữ liệu, mô hình và cài đặt được giữ nhất quán giữa các thủ tục.
- Mục tiêu giải thích, dự báo hoặc kết hợp đã được nêu trước.
4. Đọc R², R² hiệu chỉnh và f² đúng đơn vị
R² cho biết tỷ lệ phương sai của từng biến nội sinh được giải thích trong mẫu bởi tập biến dự báo. R² hiệu chỉnh tính đến số biến dự báo và cỡ mẫu. Khi so hai mô hình có số biến dự báo khác nhau, R² hiệu chỉnh giúp hạn chế việc đánh giá cao một mô hình chỉ vì nó chứa thêm biến.
f² đo phần suy giảm của R² khi loại một biến dự báo khỏi phương trình: f² = (R² đầy đủ - R² loại biến)/(1 - R² đầy đủ). Các giá trị 0,02; 0,15 và 0,35 thường được dùng như điểm neo cho tác động nhỏ, trung bình và lớn (Cohen, 1988). Đây là hướng dẫn tham khảo. Ý nghĩa thực tiễn còn phụ thuộc lĩnh vực, độ tin cậy của phép đo và câu hỏi nghiên cứu.
Hệ số đường dẫn, khoảng tin cậy và f² không thay thế nhau. Một đường dẫn có p nhỏ nhưng f² rất thấp có thể ổn định về mặt thống kê nhưng đóng góp giải thích nhỏ. Ngược lại, f² tương đối lớn đi cùng khoảng tin cậy rộng vẫn cần được diễn giải thận trọng.
| Biến bị loại | R² đầy đủ | R² sau khi loại | f² | Cách đọc |
|---|---|---|---|---|
| Niềm tin | 0,520 | 0,470 | 0,104 | Đóng góp nhỏ theo điểm neo của Cohen |
| Chất lượng dịch vụ | 0,520 | 0,505 | 0,031 | Đóng góp nhỏ |
| Giá cảm nhận | 0,520 | 0,519 | 0,002 | Đóng góp rất thấp trong mô hình này |
Với Niềm tin, f² = (0,520 - 0,470)/(1 - 0,520) = 0,104. Ví dụ này được tạo để minh họa công thức, không phải kết quả của một nghiên cứu thực tế.
5. Phân biệt Q² blindfolding với Q²predict
Q² Stone–Geisser từ blindfolding là thước đo predictive relevance dựa trên thủ tục bỏ điểm và tái tạo trong cùng mẫu. Nó không phải đánh giá dự báo ngoài mẫu theo nghĩa huấn luyện mô hình trên một phần dữ liệu rồi dự báo phần giữ lại.
SmartPLS 4 đã ngừng hỗ trợ blindfolding và khuyến nghị PLSpredict cùng CVPAT cho đánh giá dự báo ngoài mẫu (SmartPLS, n.d.-b). Vì vậy, người dùng không nên tìm nút Blindfolding trong SmartPLS 4 hoặc chuyển giá trị Q² từ tài liệu cũ thành bằng chứng dự báo dữ liệu mới.
Q²predict dương cho biết sai số của PLS-SEM thấp hơn benchmark dự báo bằng giá trị trung bình đối với chỉ báo đó. Kết luận này vẫn chưa đủ. Cần so sánh RMSE hoặc MAE của PLS-SEM với benchmark mô hình tuyến tính trên từng chỉ báo nội sinh (Shmueli và cộng sự, 2019; SmartPLS, n.d.-c).
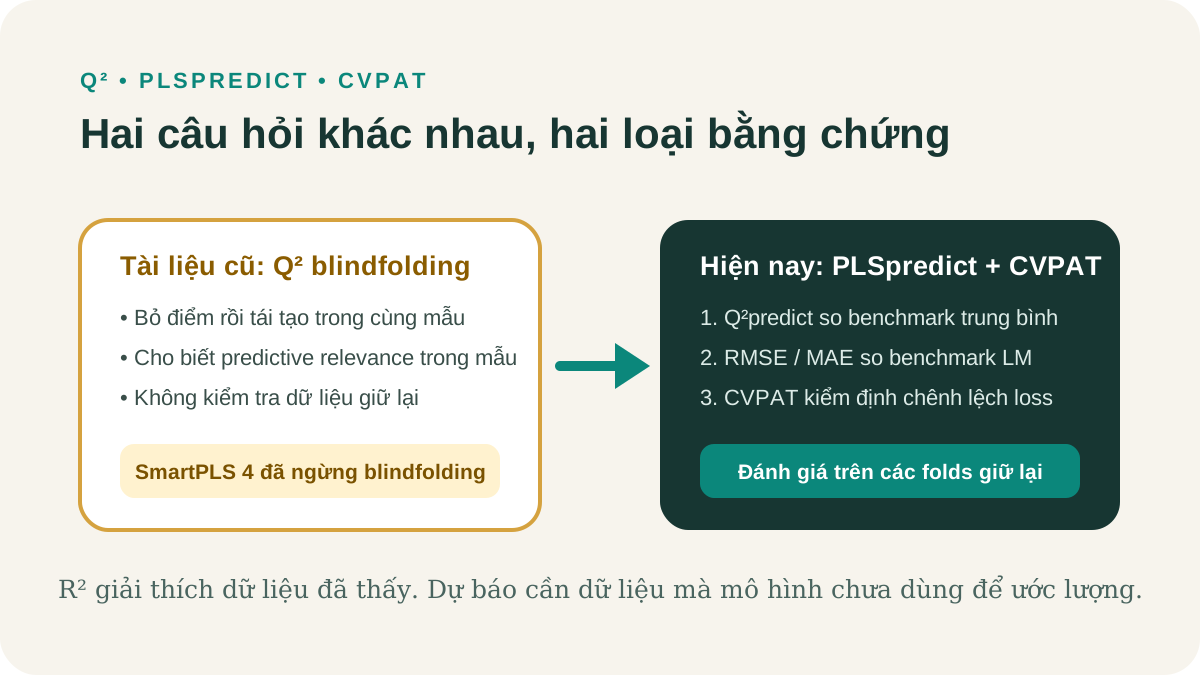
| Kết quả | Dữ liệu dùng để đánh giá | Câu hỏi được trả lời |
|---|---|---|
| Q² blindfolding | Tái sử dụng mẫu hiện có | Mô hình có predictive relevance trong mẫu không? |
| Q²predict | Các folds giữ lại | PLS-SEM có tốt hơn benchmark trung bình không? |
| RMSE hoặc MAE so với LM | Các folds giữ lại | Mô hình lý thuyết có tốt hơn benchmark tuyến tính không? |
| CVPAT | Sai số cross-validated | Chênh lệch loss có ủng hộ năng lực dự báo tốt hơn benchmark không? |
6. CVPAT bổ sung điều gì cho PLSpredict?
PLSpredict cung cấp sai số dự báo để so sánh mô tả. CVPAT kiểm định chênh lệch loss cross-validated giữa PLS-SEM và benchmark. Thủ tục này được phát triển để so sánh năng lực dự báo của các mô hình hoặc benchmark trên dữ liệu giữ lại (Liengaard và cộng sự, 2021).
Trong báo cáo SmartPLS, kết luận có lợi cho PLS-SEM đòi hỏi loss của PLS-SEM thấp hơn benchmark. Nếu chênh lệch được tính theo loss PLS trừ loss benchmark, giá trị âm mới thể hiện sai số thấp hơn. Người dùng phải đọc đúng chiều chênh lệch hiển thị trong phiên bản phần mềm, không dựa riêng vào p-value.
Một p-value nhỏ không cho biết chênh lệch có ý nghĩa thực tiễn. Hãy báo loại benchmark, hàm loss, số folds, số lần lặp, chênh lệch loss và kết quả kiểm định. Tài liệu SmartPLS hiện đặt CVPAT trong báo cáo PLSpredict (SmartPLS, n.d.-d).
7. Quy trình thực hành trong SmartPLS 4
Tên mục có thể thay đổi nhẹ giữa các bản cập nhật. Quy trình dưới đây tập trung vào logic kiểm tra. Hãy ghi phiên bản SmartPLS, random seed và cài đặt cross-validation để người khác có thể chạy lại.
Chạy PLS-SEM Algorithm
Mở Calculate, chọn PLS-SEM Algorithm. Trong Quality criteria, ghi R-square và R-square adjusted cho từng biến nội sinh.
Đọc f-square
Mở bảng f-square. Đối chiếu đúng biến dự báo ở hàng và biến nội sinh ở cột; không nhầm f² với hệ số đường dẫn.
Chạy bootstrapping
Báo hệ số đường dẫn, khoảng tin cậy và p-value. Ghép kết quả này với f² để phân biệt độ bất định và đóng góp giải thích.
Chạy PLSpredict/CVPAT
Mở Calculate, chọn PLSpredict/CVPAT. Ghi số folds, số lần lặp và random seed. Mười folds và mười lần lặp là mặc định được SmartPLS mô tả, nhưng mỗi fold phải đủ quan sát để ước lượng.
Đọc Q²predict
Kiểm tra từng chỉ báo nội sinh. Q²predict dương nghĩa là PLS-SEM tốt hơn benchmark trung bình tại chỉ báo đó.
So sánh RMSE hoặc MAE
Chọn thước đo sai số có căn cứ và so PLS-SEM với LM trên từng chỉ báo. Không chọn thước đo sau khi nhìn kết quả để tạo kết luận thuận lợi.
Đọc CVPAT
Xác định benchmark và chiều của chênh lệch loss. Kết luận tốt hơn chỉ khi PLS-SEM có loss thấp hơn và kiểm định ủng hộ chênh lệch đó.
Màu trong giao diện chỉ hỗ trợ nhận diện. Bài viết khoa học phải nêu giá trị, benchmark, cài đặt, nguồn tiêu chí và giới hạn của kết luận.
8. Ví dụ giả định: từ giải thích trong mẫu đến dự báo ngoài mẫu
Giả sử mô hình dự báo Lòng trung thành từ Sự hài lòng, Niềm tin và Chi phí chuyển đổi. R² của Lòng trung thành bằng 0,610 và R² hiệu chỉnh bằng 0,602. Khi loại Niềm tin, R² giảm còn 0,550. f² của Niềm tin bằng (0,610 - 0,550)/(1 - 0,610) = 0,154.
Với chỉ báo LOY1, Q²predict = 0,180. RMSE của PLS-SEM bằng 0,720, thấp hơn RMSE của LM bằng 0,760. Kết quả này cho thấy dự báo thuận lợi đối với LOY1 so với hai benchmark được xem xét. Chưa thể suy rộng sang toàn bộ biến Lòng trung thành trước khi kiểm tra các chỉ báo còn lại.
Giả sử CVPAT cho chênh lệch loss PLS trừ LM bằng -0,014 với p = 0,031. Khi chiều chênh lệch được xác nhận như trên, kết quả ủng hộ loss thấp hơn của PLS-SEM so với LM. Số liệu trong mục này hoàn toàn giả định và chỉ dùng để minh họa cách đọc.
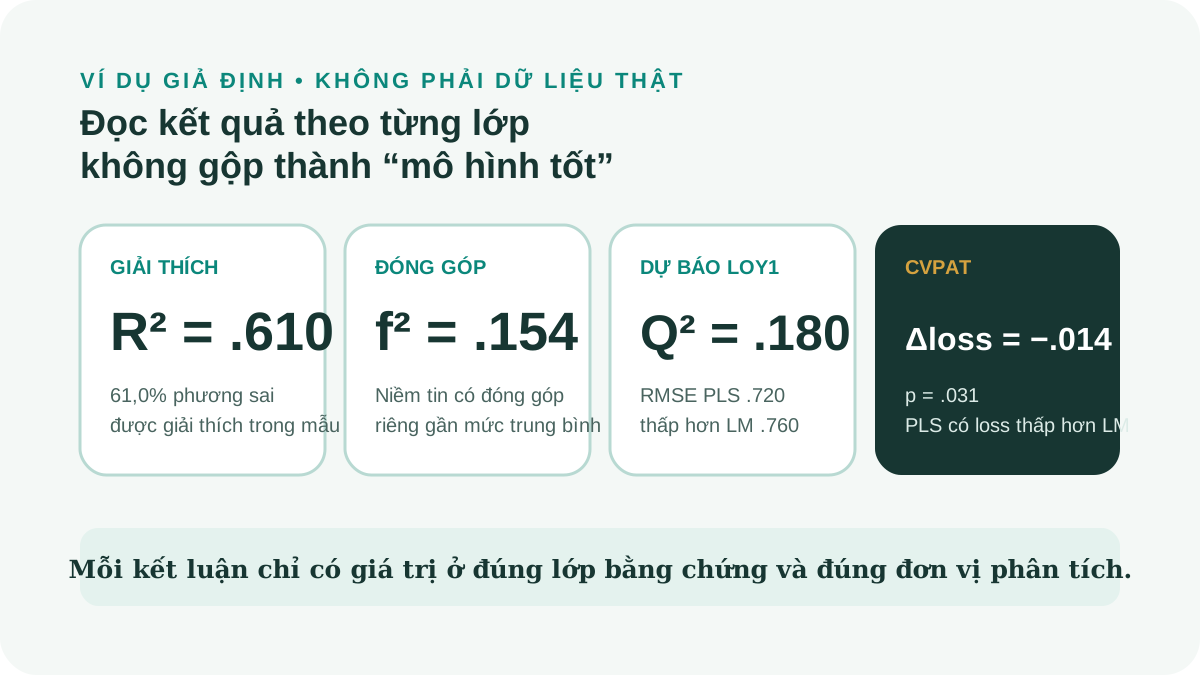
| Lớp | Kết quả | Kết luận giới hạn |
|---|---|---|
| Giải thích | R² = 0,610; R² hiệu chỉnh = 0,602 | Mô hình giải thích 61,0% phương sai trong mẫu |
| Đóng góp | f² Niềm tin = 0,154 | Đóng góp gần mức trung bình theo điểm neo của Cohen |
| Benchmark trung bình | Q²predict LOY1 = 0,180 | PLS-SEM tốt hơn benchmark trung bình ở LOY1 |
| Benchmark LM | RMSE PLS = 0,720; RMSE LM = 0,760 | PLS-SEM có sai số thấp hơn ở LOY1 |
| CVPAT | Loss difference = -0,014; p = 0,031 | Có bằng chứng loss PLS thấp hơn LM theo chiều chênh lệch đã nêu |
9. Lỗi diễn giải thường gặp
| Cách viết yếu | Vấn đề | Cách sửa |
|---|---|---|
| GoF lớn nên mô hình phù hợp | GoF không chẩn đoán ổn định đặc tả sai | Không dùng GoF làm căn cứ chấp nhận mô hình |
| R² cao nên mô hình dự báo tốt | R² là kết quả trong mẫu | Chạy PLSpredict và CVPAT |
| Q² dương nên mô hình dự báo mạnh | Có thể đang nói Q² blindfolding hoặc chỉ so benchmark trung bình | Nêu rõ Q²predict và so RMSE hoặc MAE với LM |
| p < 0,05 nên tác động lớn | Ý nghĩa thống kê không phải kích thước tác động | Báo β, CI và f² |
| CVPAT có ý nghĩa nên mô hình tốt | Chưa đọc chiều chênh lệch loss | Xác nhận loss PLS thấp hơn benchmark |
| Một chỉ báo dự báo tốt nên toàn thang tốt | Kết luận vượt quá đơn vị phân tích | Đối chiếu toàn bộ chỉ báo nội sinh |
10. Mẫu báo cáo APA 7 và bảng kiểm
Mẫu dưới đây sử dụng số giả định ở phần thực hành. Khi áp dụng, thay toàn bộ giá trị bằng kết quả gốc và giữ số chữ số thập phân nhất quán.
Mẫu báo cáo tiếng Việt
GoF không được dùng làm tiêu chuẩn phù hợp tổng thể vì chỉ số này không phân biệt đáng tin cậy mô hình được đặc tả đúng với mô hình bị đặc tả sai. Mô hình giải thích 61,0% phương sai của Lòng trung thành (R² = .610; R² hiệu chỉnh = .602). Niềm tin có hệ số β = [ ], khoảng tin cậy bootstrap 95% [ ; ], p = [ ] và f² = .154. PLSpredict được chạy với [k] folds, [r] lần lặp và random seed [ ]. Với LOY1, Q²predict = .180; RMSE của PLS-SEM (.720) thấp hơn LM (.760). CVPAT cho chênh lệch loss PLS trừ LM bằng -.014, p = .031, qua đó ủng hộ loss thấp hơn của PLS-SEM theo benchmark và hàm loss đã nêu.
- Không dùng GoF để kết luận mô hình phù hợp.
- Báo R² và R² hiệu chỉnh cho từng biến nội sinh.
- Gắn f² với đúng đường dẫn và đọc cùng β cùng khoảng tin cậy.
- Phân biệt Q² blindfolding với Q²predict.
- Nêu folds, repetitions, random seed và thước đo sai số.
- So sánh từng chỉ báo với benchmark trung bình và LM.
- Đọc đúng chiều của chênh lệch loss trong CVPAT.
- Tách kết luận giải thích trong mẫu khỏi dự báo ngoài mẫu.
Kết luận
GoF thuộc về lịch sử phát triển của PLS path modeling, nhưng không nên được dùng để đóng dấu một mô hình là phù hợp. Việc cập nhật không dừng ở chỗ xóa một chỉ số khỏi bảng.
Một báo cáo hiện nay cần đi theo chuỗi bằng chứng: chất lượng đo lường, hệ số cùng khoảng tin cậy, R², f², rồi PLSpredict và CVPAT. Chuỗi này buộc người phân tích trả lời đúng câu hỏi thay vì tìm một con số duy nhất.
Tài liệu tham khảo
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Henseler, J., & Sarstedt, M. (2013). Goodness-of-fit indices for partial least squares path modeling. Computational Statistics, 28(2), 565-580. https://doi.org/10.1007/s00180-012-0317-1
- Liengaard, B. D., Sharma, P. N., Hult, G. T. M., Jensen, M. B., Sarstedt, M., Hair, J. F., & Ringle, C. M. (2021). Prediction: Coveted, yet forsaken? Introducing a cross-validated predictive ability test in partial least squares path modeling. Decision Sciences, 52(2), 362-392. https://doi.org/10.1111/deci.12445
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322-2347. https://doi.org/10.1108/EJM-02-2019-0189
- SmartPLS. (n.d.-a). Goodness of fit (GoF) index in PLS-SEM: Why it is limited. https://smartpls.com/documentation/algorithms-and-techniques/validity-and-model-fit/goodness-of-fit/
- SmartPLS. (n.d.-b). Blindfolding and Stone-Geisser's Q² in PLS-SEM. https://smartpls.com/documentation/algorithms-and-techniques/resampling-and-inference/blindfolding/
- SmartPLS. (n.d.-c). PLSpredict: Assessing predictive power in PLS-SEM. https://smartpls.com/documentation/algorithms-and-techniques/prediction-and-segmentation/predict/
- SmartPLS. (n.d.-d). Cross-validated predictive ability test (CVPAT) in PLS-SEM. https://smartpls.com/documentation/algorithms-and-techniques/resampling-and-inference/cvpat/
- Tenenhaus, M., Esposito Vinzi, V., Chatelin, Y.-M., & Lauro, C. (2005). PLS path modeling. Computational Statistics & Data Analysis, 48(1), 159-205. https://doi.org/10.1016/j.csda.2004.03.005
Ghi chú học thuật: Các số liệu trong ví dụ là giả định. Giao diện và tên lệnh được mô tả theo SmartPLS 4; người đọc cần ghi phiên bản phần mềm và đối chiếu tài liệu chính thức nếu menu thay đổi.