
Điều tiết trong SEM bậc cao: chọn tương tác, điểm số hay đa nhóm
Một khái niệm bậc cao có thể liên hệ với kết quả theo cách khác nhau ở những điều kiện làm việc khác nhau. Khó khăn nằm ở việc giữ đúng khái niệm đang đo khi thêm tương tác hoặc so sánh nhóm. Bài này dùng các hình AMOS/SmartPLS gốc để chỉ rõ những quyết định phải bảo vệ.
Bậc cao thuộc lớp đo lường; điều tiết thuộc câu hỏi về quan hệ cấu trúc. Lưu điểm số là một cách xây phân tích có điều kiện, không tự biến toàn bộ sai số đo thành đã được giải quyết. Chia điểm liên tục thành hai nhóm cũng làm thay đổi câu hỏi nghiên cứu.
1. Xác định khái niệm bậc cao trước khi thêm điều tiết
Gọi H là khái niệm bậc cao, L₁, L₂, … là các thành phần bậc thấp, M là biến điều tiết và Y là kết quả. Cần xác định H giải thích các thành phần hay được hình thành từ chúng. Lựa chọn này ảnh hưởng cách đặc tả, đánh giá đo lường và cách tạo điểm đại diện; không thể quyết định chỉ từ việc sơ đồ có hai tầng (SmartPLS, n.d.-a).
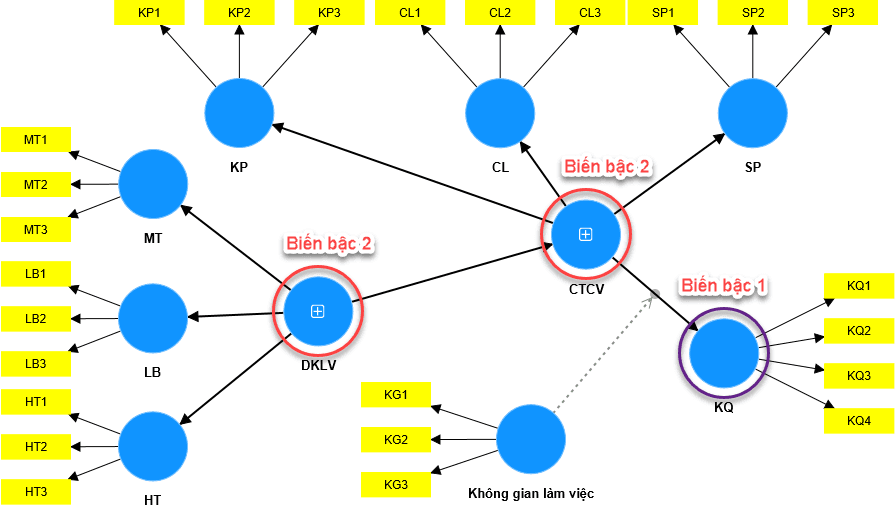
Giả thuyết điều tiết cần gọi tên một quan hệ cụ thể, chẳng hạn H → Y thay đổi theo M. Nếu từng Lᵢ cũng liên hệ trực tiếp với Y, tác động của H và các thành phần không còn là những phát biểu thay thế nhau. Đặc tả phải dựa trên lý thuyết và nhận dạng, trước khi chọn bộ ước lượng.
2. Ba chiến lược và câu hỏi mà chúng trả lời
| Chiến lược | Đối tượng phân tích | Giới hạn cần báo cáo |
|---|---|---|
| Tương tác trong mô hình tiềm ẩn | Giữ mô hình đo lường và dùng đặc tả tương tác thích hợp. | Cần phương pháp, nhận dạng và phần mềm hỗ trợ; độ phức tạp bậc cao không tự được giải quyết bằng một biến tích. |
| Phân tích dựa trên điểm số | Dùng điểm đại diện H và M theo quy tắc đã xác định. | Tham số gắn với điểm ước lượng; cần xem sai số đo và độ bất định từ bước tạo điểm. |
| Phân tích đa nhóm | So sánh đường ở các nhóm có ý nghĩa từ thiết kế. | Cần phép đo so sánh được và kiểm định đúng đường hoặc tập đường được ràng buộc. |
Không có quy tắc “bậc cao thì phải chạy MGA”. Nếu M là định lượng, mô hình tương tác vẫn có thể trả lời trực tiếp câu hỏi thay đổi độ dốc theo M (Hayes, 2022). MGA phù hợp với giả thuyết về nhóm, không phải một cách mặc định né việc ước lượng tương tác.
Cũng cần phân biệt thuật toán với tên ứng dụng. SmartPLS có các chức năng PLS-SEM và CB-SEM; kết quả từ hai bộ ước lượng không được xem như cùng một mô hình chỉ vì vẽ cùng các biến. Hãy ghi rõ phương pháp dùng trong từng hình và từng phân tích.
3. Hai công việc khác nhau cùng được gọi là two-stage
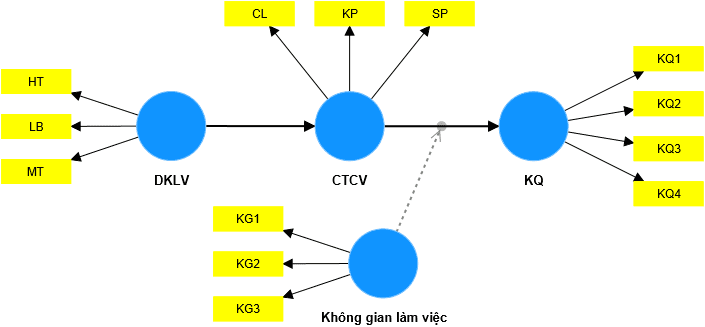
Trong mô hình bậc cao PLS-SEM, two-stage có thể dùng kết quả các thành phần bậc thấp làm đầu vào để biểu diễn khái niệm bậc cao. Trong phân tích điều tiết, two-stage dùng các điểm thích hợp để xây tương tác. Hai công việc có mục tiêu khác nhau; phải nêu rõ điểm nào được lấy ở mô hình nào và được dùng ở bước kế tiếp ra sao (SmartPLS, n.d.-a, n.d.-c).
Xác lập phép đo
Ghi loại HOC/LOC, chỉ báo, chiều thang và điều kiện nhận dạng. Kiểm tra riêng các thành phần và quan hệ của chúng với khái niệm bậc cao.
Xác lập nguồn điểm
Nếu dùng two-stage cho HOC, ghi mô hình giai đoạn đầu, cách tính điểm, định thang và cách đưa điểm thành phần vào giai đoạn tiếp theo.
Xác lập tương tác
Đảm bảo điểm của biến dự báo và M cùng hàng dữ liệu, cùng quy ước định thang. Giữ các thành phần bậc thấp của phương trình cấu trúc khi thêm tích.
Xác lập suy luận
Lưu thiết lập tái lấy mẫu và nêu bước nào được ước lượng lại trong mỗi mẫu. Nếu chỉ phân tích một bảng điểm cố định, không mặc định đã tính cả bất định của quá trình tạo điểm.
Kiểm tra và báo cáo
Đọc hệ số tương tác, khoảng tin cậy, độ dốc có điều kiện và cảnh báo. Trình bày đầy đủ chuỗi tạo điểm để người khác hiểu tham số đang được ước lượng.
Tải và độ tin cậy không được dùng máy móc cho mọi quan hệ bậc cao. Khi các thành phần hình thành H, việc bỏ một thành phần có thể đổi nội dung khái niệm. Khi H giải thích các thành phần, cách đánh giá theo logic phản ánh lại khác. Không chọn loại đo lường dựa vào bộ chỉ số dễ đạt hơn (SmartPLS, n.d.-a).
4. Đọc tương tác và đồ thị trong ví dụ PLS-SEM
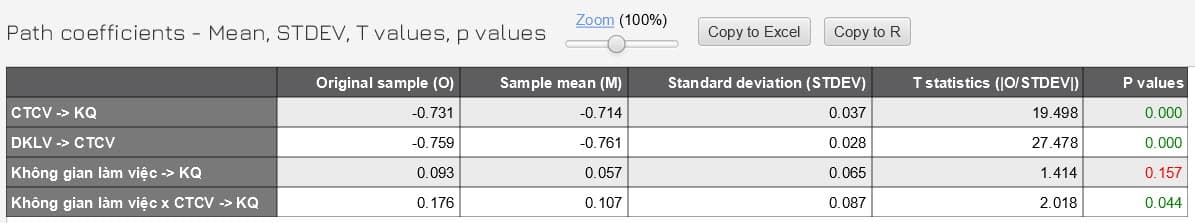
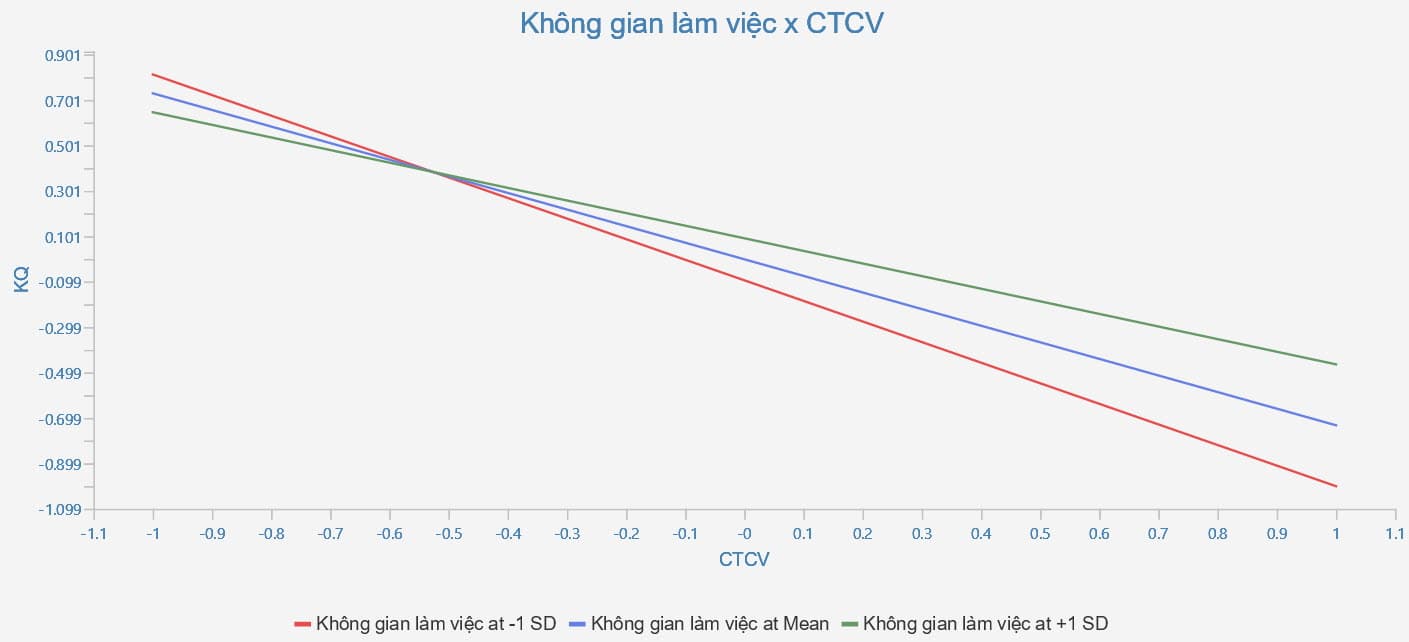
Trong mô hình tương tác tuyến tính dựa trên điểm H, có thể viết Y = b₀ + b₁H + b₂M + b₃HM + ε. Khi đó độ dốc theo H là b₁ + b₃M. Dấu của b₃ phụ thuộc chiều điểm và cách định thang; cần đọc cùng biểu đồ dự đoán, phạm vi M và khoảng tin cậy phù hợp (Hayes, 2022).
Các hình gốc được giữ để minh họa đầu ra, nhưng không có tệp dữ liệu và thiết lập đầy đủ đi kèm trong bài để tái ước lượng. Vì vậy, không suy ra một mô hình được ưu tiên chỉ vì một bảng có p nhỏ hơn bảng khác. Khác biệt có thể nằm ở phép đo, điểm số, tập quan sát hoặc đặc tả.
5. Xuất điểm nhân tố không tương đương giữ nguyên mô hình tiềm ẩn
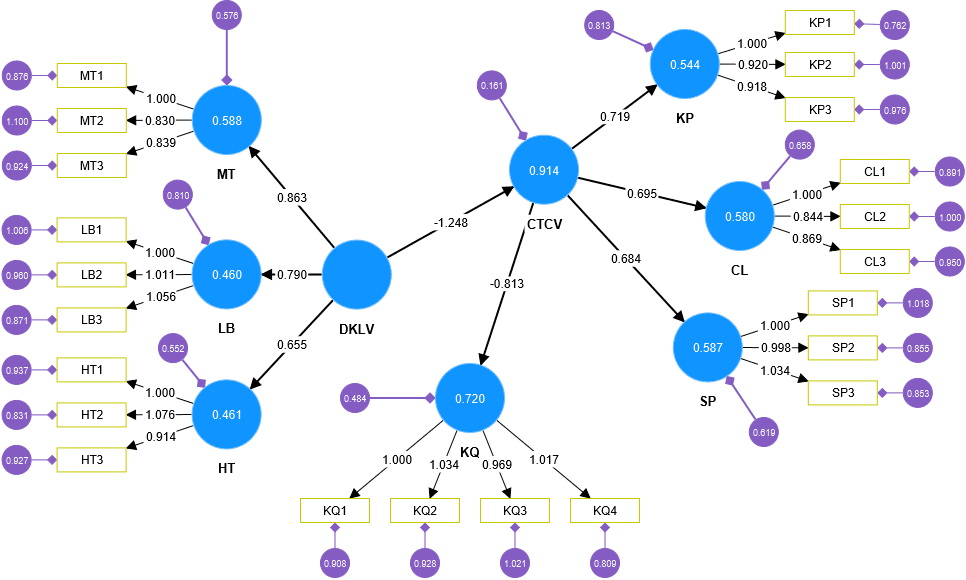
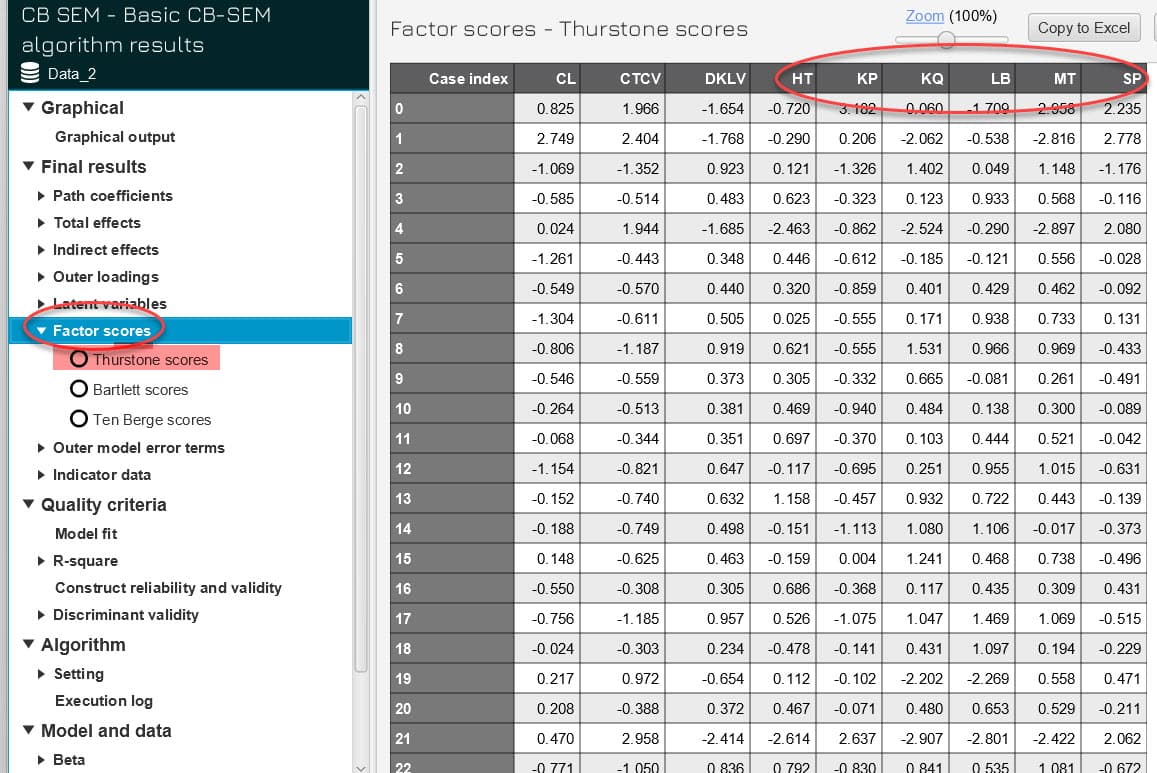
Một bảng factor scores cung cấp điểm cho từng quan sát theo mô hình và phương pháp tính đã chọn. Ảnh có các lựa chọn Thurstone, Bartlett và Ten Berge; không nên gọi tất cả là điểm trung bình. Nếu đem các cột này sang một hồi quy, mô hình tiếp theo đang phân tích các điểm đại diện đã xuất ra.
Trong cách làm đó, việc coi bảng điểm là đầu vào cố định không tự truyền mọi bất định từ mô hình đo lường vào sai số chuẩn giai đoạn sau. Đây là giới hạn phải xem xét khi chọn phương pháp, nhất là khi độ tin cậy thấp hoặc điểm số thay đổi theo đặc tả. Phân tích tương tác tiềm ẩn đòi hỏi một mô hình riêng, như sự phân biệt được trình bày bởi Maslowsky và cộng sự (2015).
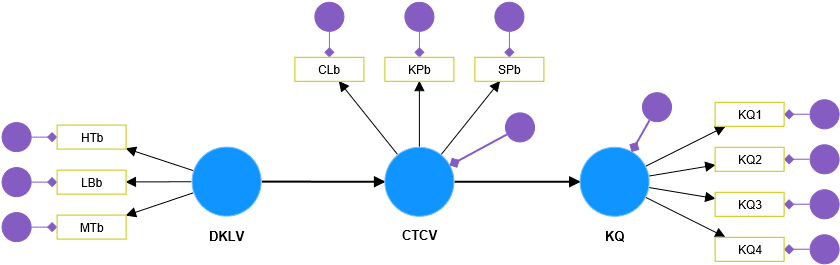
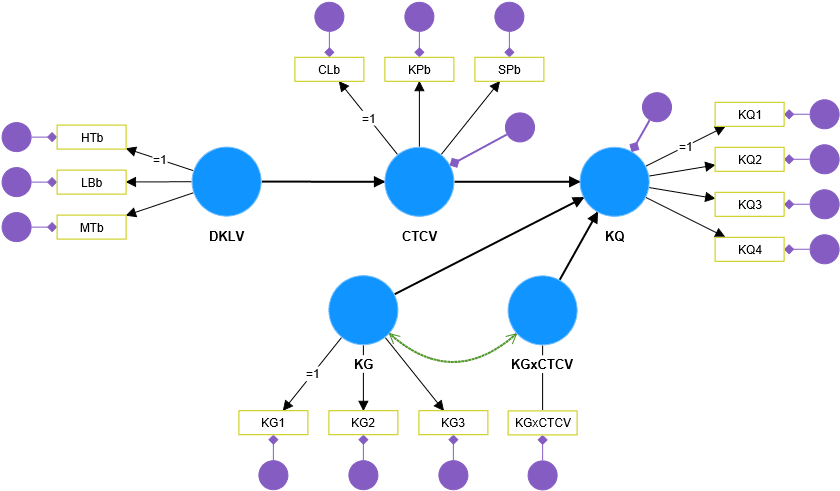
6. p lớn và sai số chuẩn lớn cần được đọc cùng nhau
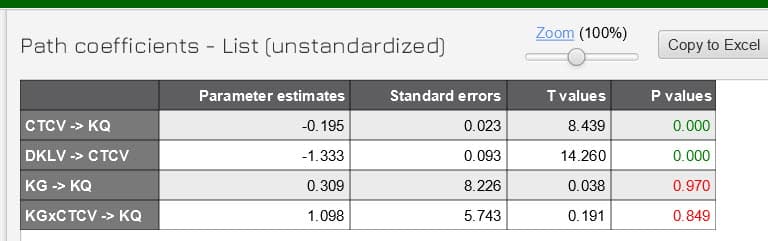
Ở dòng tương tác trong ảnh, ước lượng điểm 1,098 đi cùng SE 5,743 và p = 0,849. Kết quả này chưa cung cấp bằng chứng rõ về tương tác trong đặc tả đã chạy. Một ước lượng điểm dương không chứng minh tác động làm mạnh quan hệ; p lớn cũng chưa chứng minh không có tác động.
Ảnh không có khoảng tin cậy và cảnh báo hội tụ. Không nên chẩn đoán chắc chắn nguyên nhân chỉ từ bảng này. Bước tiếp theo là xem nhận dạng, sự biến thiên của điểm, sự phụ thuộc giữa các biến, quy mô và phân bố mẫu, cùng toàn bộ mô hình đo lường. Chỉ báo cáo mức chính xác thực tế mà phân tích đạt được (Hayes, 2022; Kline, 2023).
7. Vì sao không mặc định chia điểm Likert ở mốc 4?
Trong ví dụ gốc, điểm không gian làm việc từng được chia thành ≤ 4 và > 4 để tạo hai nhóm. Nếu giả thuyết là độ dốc thay đổi theo mức không gian làm việc, chia như vậy biến câu hỏi thành so sánh hai nhóm do một ngưỡng tạo ra. Hai người ở 3,9 và 4,1 bị tách nhóm, trong khi hai người ở 1 và 4 có thể cùng nhóm.
Việc nhị phân hóa biến định lượng có thể mất thông tin và dẫn tới suy luận sai lệch; một điểm cắt tiện dùng chưa phải lý do khoa học (MacCallum et al., 2002). Đây cũng không phải cùng quyết định với việc coi một item Likert là chỉ báo thứ bậc trong mô hình đo lường.
Nếu ngưỡng xuất phát từ một tiêu chuẩn có ý nghĩa độc lập và giả thuyết thực sự nói về nhóm, có thể biện minh cách phân nhóm trước khi xem kết quả. Khi đó phải báo số quan sát, phân bố điểm, cơ sở ngưỡng và độ nhạy với các đặc tả hợp lý. Nếu mục tiêu vẫn là điều tiết định lượng, ưu tiên đặc tả giữ thông tin phù hợp thay vì chọn ngưỡng cho p thuận lợi (Hayes, 2022).
8. Đa nhóm: tách bất biến đo lường khỏi ràng buộc cấu trúc
Trong CB-SEM, kiểm tra mô hình đo lường giữa nhóm trước khi diễn giải khác biệt cấu trúc. Với mô hình bậc cao, xem cả phép đo của thành phần và các quan hệ bậc cao có liên quan. Mức bất biến cần bảo vệ phụ thuộc đại lượng so sánh; so sánh trung bình cần xem thêm intercept, không dừng ở việc cùng có một sơ đồ (Kline, 2023).
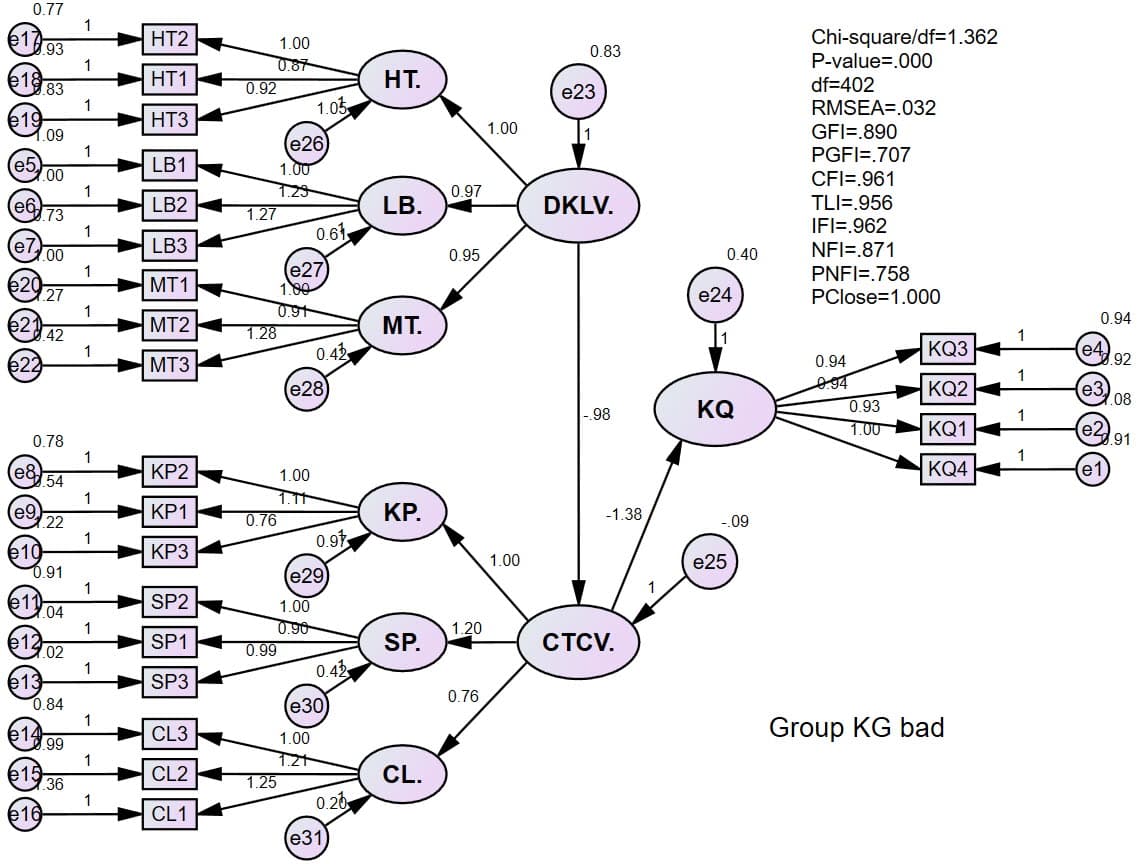
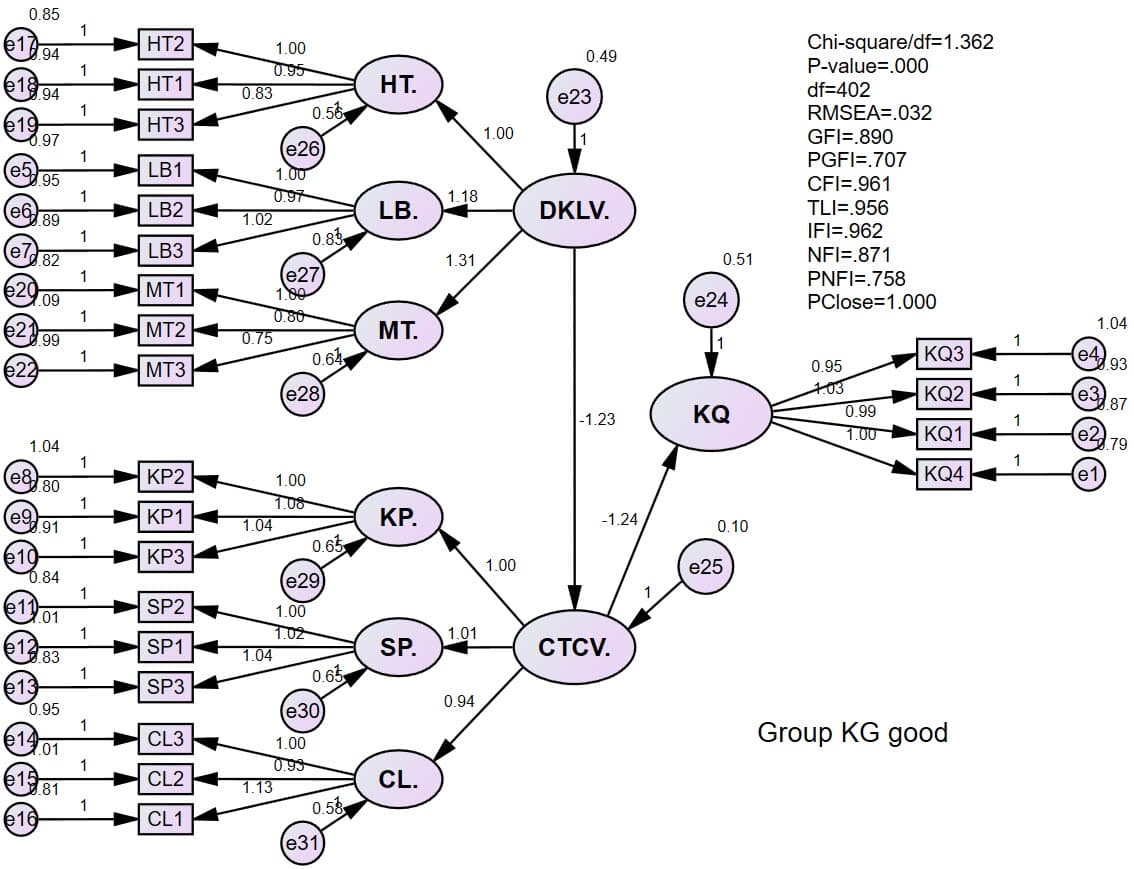
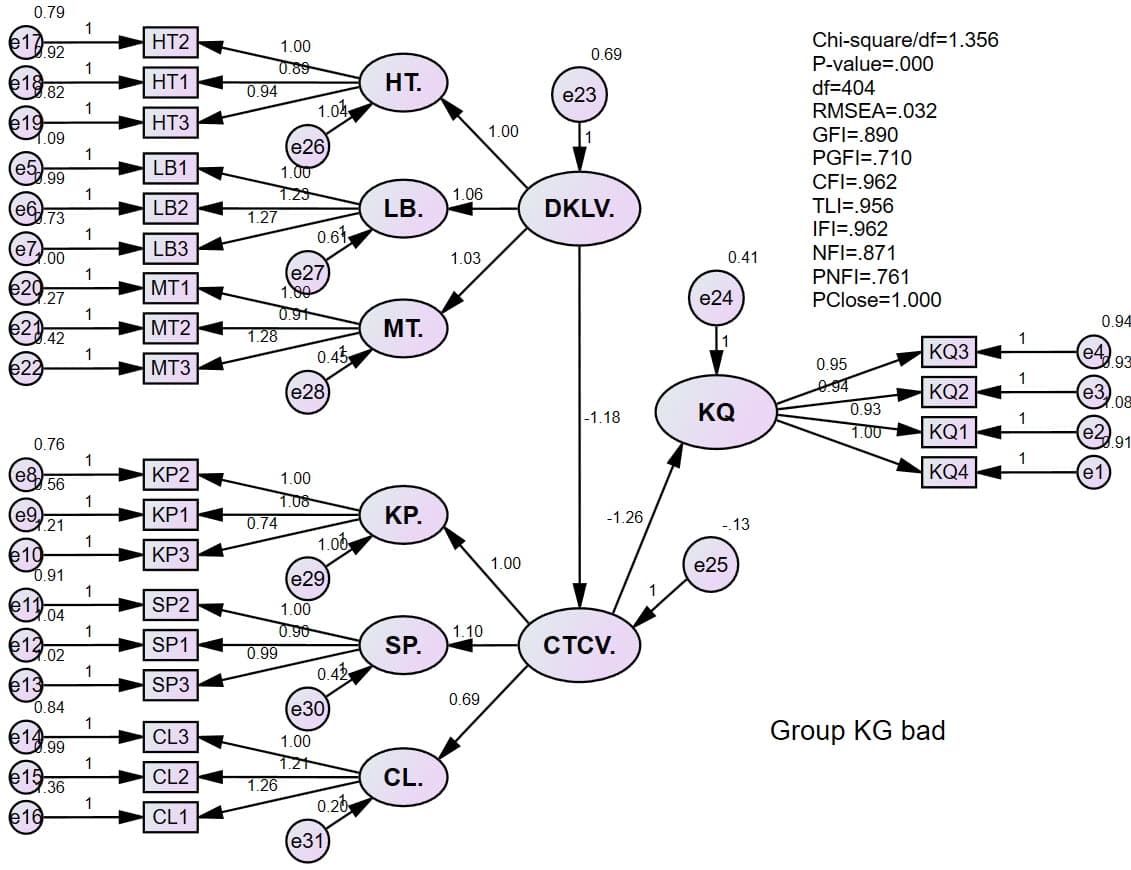
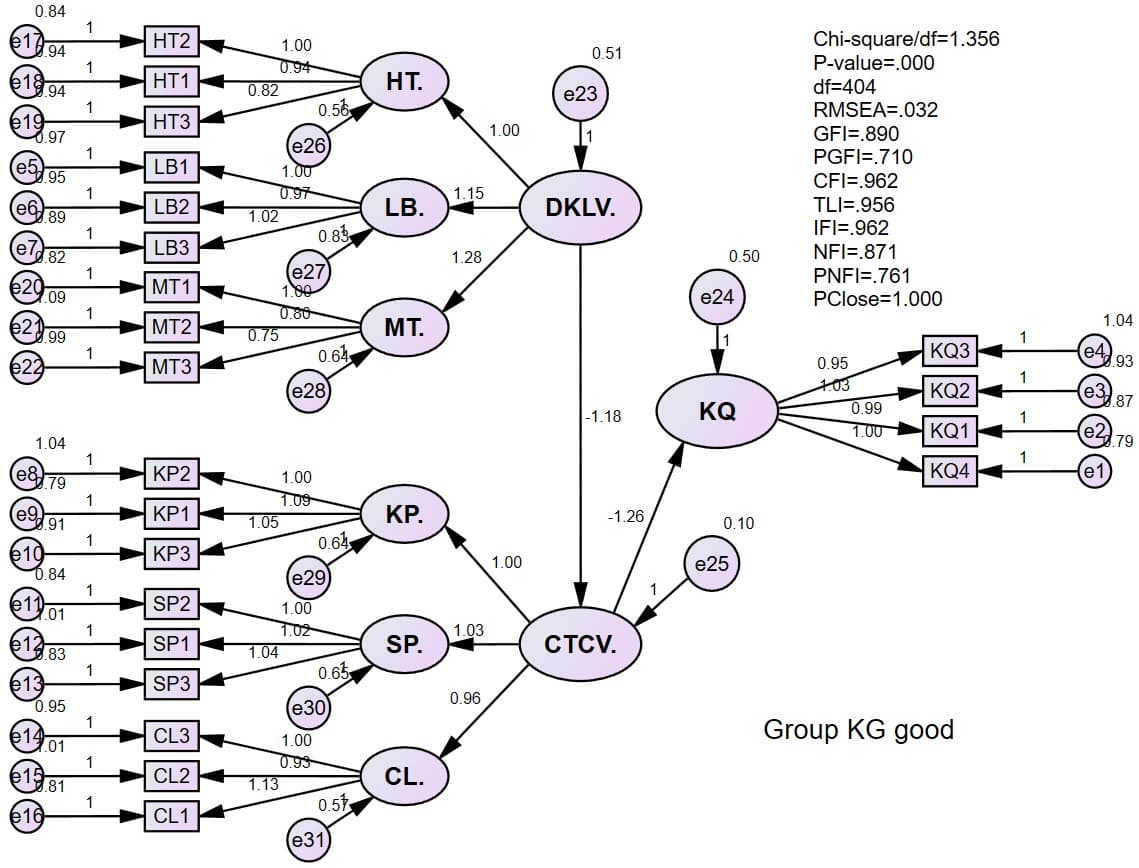
Trong PLS-SEM, dùng thủ tục bất biến cho composite phù hợp, chẳng hạn MICOM, trước các so sánh nhóm tương ứng. MICOM không phải tên khác của kiểm định bất biến CFA trong AMOS. Cũng không được xem việc chạy MICOM là đã kiểm định chênh lệch của mọi đường cấu trúc (SmartPLS, n.d.-b).
9. Kiểm định chung không trả lời thay cho từng đường
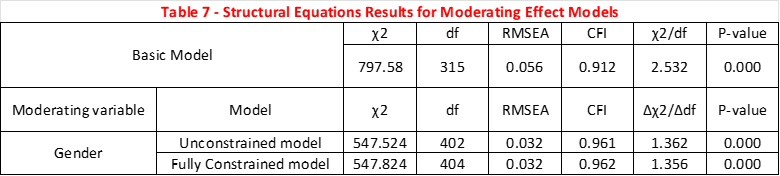
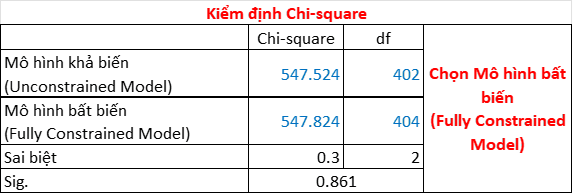
Bảng ở Hình 14 ghi biến điều tiết là Gender, trong khi phần phân nhóm phía trên bàn về không gian làm việc (KG). Chưa có file mô hình và dữ liệu để xác định hai hình có thuộc cùng một phân tích hay không. Vì vậy, không gán kết quả trong bộ ảnh này cho riêng KG hoặc giới tính; cần đối chiếu hồ sơ gốc trước khi dùng làm bằng chứng cho một giả thuyết cụ thể.
Ảnh cuối ghi χ² = 547,524 với df = 402 và χ² = 547,824 với df = 404. Nếu đây là hai mô hình ML thông thường, lồng nhau, dùng cùng dữ liệu và cùng nền đo lường, phép tính minh họa từ các số trên cho Δχ² = 0,300 và Δdf = 2, tương ứng p xấp xỉ 0,861. Các điều kiện này chưa thể xác minh chỉ bằng ảnh; đây không phải tái phân tích dữ liệu gốc.
Trong những điều kiện đó, kết quả chỉ cho biết chưa có bằng chứng rõ để bác bỏ tập hai ràng buộc đang kiểm tra. Nó không xác nhận mọi hệ số giữa nhóm đều giống hệt, không chứng minh tương đương thực tiễn và không tự tạo kết luận riêng cho CTCV → KQ. Muốn kiểm tra đường này, cần một so sánh nhắm đúng đường hoặc một tương phản trực tiếp, với phép đo và thang hệ số có thể so sánh (Kline, 2023).
Không lấy p của CTCV → KQ ở từng nhóm rồi so bên có ý nghĩa với bên không có ý nghĩa. Cần xét hiệu giữa hai hệ số và độ bất định của hiệu đó. Khi dùng estimator robust hoặc bootstrap, lựa chọn thủ tục suy luận thích hợp thay vì trừ cơ học hai thống kê đã hiệu chỉnh.
10. Mẫu báo cáo và checklist
Khái niệm bậc cao H được đặc tả là [loại quan hệ với LOC], theo [căn cứ lý thuyết]. Điều tiết được kiểm tra bằng [tương tác tiềm ẩn / điểm số / đa nhóm]. Điểm dùng ở từng giai đoạn được tạo từ [mô hình, phương pháp, định thang]. Chúng tôi kiểm định [tham số hoặc tập ràng buộc], báo [hệ số/chênh lệch, CI, p], và đánh giá [phép đo, nghiệm, độ nhạy]. Kết luận còn chịu giới hạn bởi [tạo điểm, quy mô nhóm, thiết kế và phạm vi dữ liệu].
- Nêu loại bậc cao và vai trò từng thành phần.
- Phân biệt two-stage của phép đo bậc cao với two-stage của điều tiết.
- Ghi rõ điểm trung bình, điểm PLS hay factor scores.
- Không chia biến định lượng chỉ vì khó ước lượng tương tác.
- Kiểm tra phép đo ở cấp độ phù hợp trước so sánh nhóm.
- Nêu chính xác đường nào được ràng buộc và kiểm định.
- Diễn giải p cùng CI, độ lớn và tính ổn định của ước lượng.
Giữ đúng khái niệm qua các giai đoạn là điều kiện để kết quả điều tiết có ý nghĩa. Nếu cách tạo điểm hoặc chia nhóm đã đổi đối tượng phân tích, báo cáo phải nói rõ sự thay đổi đó.
Đọc tiếp
Tương tác và diễn giải trong AMOS; Thực hành mô hình bậc hai; MICOM và so sánh đa nhóm.
Tài liệu tham khảo
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). The Guilford Press. https://www.afhayes.com/introduction-to-mediation-moderation-and-conditional-process-analysis.html
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). The Guilford Press. https://www.guilford.com/books/Principles-and-Practice-of-Structural-Equation-Modeling/Rex-Kline/9781462551910
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
- Maslowsky, J., Jager, J., & Hemken, D. (2015). Estimating and interpreting latent variable interactions: A tutorial for applying the latent moderated structural equations method. International Journal of Behavioral Development, 39(1), 87–96. https://doi.org/10.1177/0165025414552301
- SmartPLS (n.d.-a). Higher-order models. https://smartpls.com/documentation/algorithms-and-techniques/extended-relationships/higher-order/
- SmartPLS (n.d.-b). Measurement invariance assessment (MICOM). https://smartpls.com/documentation/algorithms-and-techniques/heterogeneity-and-multigroup/micom/
- SmartPLS (n.d.-c). Moderation analysis in PLS-SEM. https://smartpls.com/documentation/algorithms-and-techniques/extended-relationships/moderation/