
Diễn giải biến điều tiết bằng đồ thị: simple slopes, Johnson-Neyman và khoảng tin cậy
Đồ thị không tạo ra bằng chứng điều tiết. Nó diễn giải một hệ số tương tác đã được ước lượng, cùng simple slopes, khoảng tin cậy và phạm vi dữ liệu thực sự quan sát.
Quy trình đúng giữ các main effects trong mô hình, kiểm định X nhân M trước, chọn giá trị moderator có ý nghĩa, tính dự báo từ cùng phương trình và chỉ diễn giải simple slopes hoặc vùng Johnson-Neyman trong miền dữ liệu được hỗ trợ.
Điều tiết làm thay đổi độ dốc X → Y
- Biến dự báo X
Quan hệ chính cần nghiên cứu
- Kết quả Y
Biến được giải thích
- Biến điều tiết W
Điều kiện của quan hệ X → Y
Sơ đồ khái niệm. Đọc tương tác cùng độ dốc có điều kiện và khoảng tin cậy.
Nguồn: Lê Minh biên soạn · Minh họa khái niệm, không phải đầu ra phần mềm.1. Mục tiêu học tập và điều kiện đầu vào
Sau chuyên đề này, bạn cần đọc được hệ số tương tác, tính hiệu ứng có điều kiện của X lên Y, chọn mức M để vẽ, lập bảng predicted values, đọc simple slopes và quyết định khi nào vùng Johnson-Neyman có ý nghĩa.
Điều kiện đầu vào là mô hình chứa X, M và tích X nhân M, được ước lượng với coding cùng thang đo đã công khai. Nếu hệ số tương tác, sai số chuẩn hoặc ma trận covariance của hệ số chưa có, đồ thị chỉ là minh họa mô tả và không đủ cho suy luận (Aiken và West, 1991; Hayes, 2022).
- Mô hình chứa X, M và X nhân M.
- Main effects được giữ trong mô hình.
- Coding và điểm 0 của X, M đã được nêu.
- Dữ liệu hỗ trợ các mức M định vẽ.
- Có hệ số, SE hoặc covariance cần cho CI.
- Các covariate được cố định theo quy tắc công khai.
2. Từ phương trình tương tác đến hiệu ứng có điều kiện
Với mô hình tuyến tính Y = b0 + b1X + b2M + b3XM, hiệu ứng có điều kiện của X lên Y tại một giá trị M = m là b1 + b3m. Hệ số b3 kiểm định slope của X có thay đổi theo M hay không. Vì vậy, dấu của b3 cho biết hướng thay đổi của slope, không tự nó cho biết X có ý nghĩa ở mọi mức M (Hayes, 2022).
Main effect b1 là hiệu ứng của X khi M bằng 0. Main effect b2 là hiệu ứng của M khi X bằng 0. Nếu 0 nằm ngoài phạm vi hoặc không có ý nghĩa, các main effects khó diễn giải dù hệ số tương tác vẫn được ước lượng đúng.
Brambor, Clark và Golder (2006) nhấn mạnh rằng mô hình tương tác phải giữ các thành phần bậc thấp liên quan. Bỏ X hoặc M chỉ vì p lớn làm thay đổi ràng buộc của mô hình và thường khiến b3 khó diễn giải.
Mỗi đường trong đồ thị phải xuất phát từ cùng một mô hình đã ước lượng. Không vẽ đường xu hướng riêng cho từng nhóm rồi gọi đó là moderation nếu chưa kiểm định hệ số tương tác.
3. Centering, scaling và ý nghĩa của điểm 0
Mean-centering M thay điểm 0 thành mức trung bình mẫu, giúp b1 dễ diễn giải hơn. Centering không loại tương tác và không làm thay đổi b3 hoặc các giá trị dự báo của cùng một mô hình tuyến tính khi các thành phần được biến đổi nhất quán (Aiken và West, 1991).
Centering có thể giảm nonessential multicollinearity giữa tích số và các thành phần, nhưng không sửa dữ liệu đo kém hoặc phạm vi M quá hẹp. Standardizing thay đổi đơn vị của hệ số, nên báo cáo phải nói rõ đồ thị dùng điểm gốc, z-score hay điểm đã center.
Với moderator nhị phân mã 0 và 1, b1 là slope của X ở nhóm tham chiếu M = 0, còn b3 là chênh lệch slope giữa hai nhóm. Không áp quy tắc trung bình cộng trừ một độ lệch chuẩn cho biến nhóm.
| Dạng M | Điểm 0 | b1 | Cách vẽ |
|---|---|---|---|
| Liên tục, thang gốc | Giá trị 0 thật | Slope của X tại M = 0 | Các giá trị có nghĩa trong phạm vi |
| Liên tục, mean-centered | Trung bình mẫu | Slope của X tại M trung bình | Percentile hoặc mean cộng trừ SD hợp lệ |
| Liên tục, z-score | Trung bình mẫu | Slope theo một SD của M | M = -1, 0, 1 nếu có dữ liệu hỗ trợ |
| Nhị phân 0/1 | Nhóm tham chiếu | Slope của nhóm 0 | Một đường cho mỗi nhóm |
| Danh nghĩa K nhóm | Nhóm tham chiếu | Slope của nhóm tham chiếu | K đường từ K - 1 dummy và tương tác |
4. Chọn mức moderator để vẽ
Mean cộng trừ một độ lệch chuẩn là quy ước, không phải yêu cầu. Nếu M lệch mạnh hoặc giới hạn phạm vi, các điểm này có thể hiếm hoặc nằm ngoài dữ liệu. Có thể dùng percentile 16, 50 và 84, các mốc có ý nghĩa chuyên môn hoặc giá trị nhóm thực tế.
Mỗi mức được vẽ phải đi kèm số quan sát hoặc ít nhất phạm vi hỗ trợ. Không kéo đường đến vùng X và M gần như không đồng thời xuất hiện. Extrapolation tạo hình đẹp nhưng không có bằng chứng dữ liệu.
Nếu M là ordinal ít mức, nên vẽ các mức quan sát hoặc nhóm có ý nghĩa thay vì giả định khoảng cách bằng nhau mà không giải thích. Nếu M liên tục nhưng được chia nhóm chỉ để vẽ, kiểm định chính vẫn phải dùng biến liên tục trừ khi giả thuyết thực sự là phân nhóm.
| Tình huống | Giá trị nên cân nhắc | Điều phải kiểm tra |
|---|---|---|
| Phân phối gần đối xứng | Mean, mean cộng trừ 1 SD | Ba điểm nằm trong phạm vi |
| Phân phối lệch | Percentile 16, 50, 84 | Số quan sát quanh mỗi điểm |
| Có ngưỡng chuyên môn | Mốc thấp, chuẩn, cao có ý nghĩa | Ngưỡng được xác định trước |
| Moderator nhị phân | 0 và 1 | Nhóm tham chiếu và cỡ nhóm |
| Moderator nhiều nhóm | Từng nhóm | Coding dummy và dữ liệu mỗi nhóm |
5. Tính predicted values và giữ covariate nhất quán
Để vẽ đường tại M = m, thay m và một dãy X vào phương trình ước lượng. Nếu mô hình có covariate, phải cố định chúng ở giá trị nêu rõ hoặc dùng marginal predictions trung bình trên phân phối mẫu. Hai cách trả lời câu hỏi khác nhau và có thể cho mức Y dự báo khác.
Trục Y nên dùng đơn vị có thể hiểu. Với hồi quy tuyến tính, predicted Y nằm trên thang kết quả. Với mô hình có link phi tuyến, cần phân biệt dự báo trên link scale với probability hoặc response scale.
Khoảng tin cậy của đường không được tính chỉ từ SE của b1 hoặc b3. Nó cần toàn bộ variance và covariance của tổ hợp tuyến tính. Phần mềm hoặc code probing interaction nên được dùng để tránh bỏ covariance (Bauer và Curran, 2005).
Bước 1
Ghi phương trình, coding và hệ số chưa chuẩn hóa từ mô hình cuối.
Bước 2
Chọn các mức M nằm trong support và ghi lý do.
Bước 3
Chọn dãy X trong phạm vi quan sát chung của các mức M.
Bước 4
Cố định hoặc lấy trung bình covariate theo quy tắc đã công khai.
Bước 5
Tính predicted Y và CI từ toàn bộ covariance matrix của hệ số.
Bước 6
Vẽ đường, ribbon CI và chú giải coding rõ ràng.
Bước 7
Đối chiếu điểm trên đồ thị với một số phép tính tay.
Bước 8
Lưu dữ liệu dùng để vẽ cùng code hoặc bảng tính.
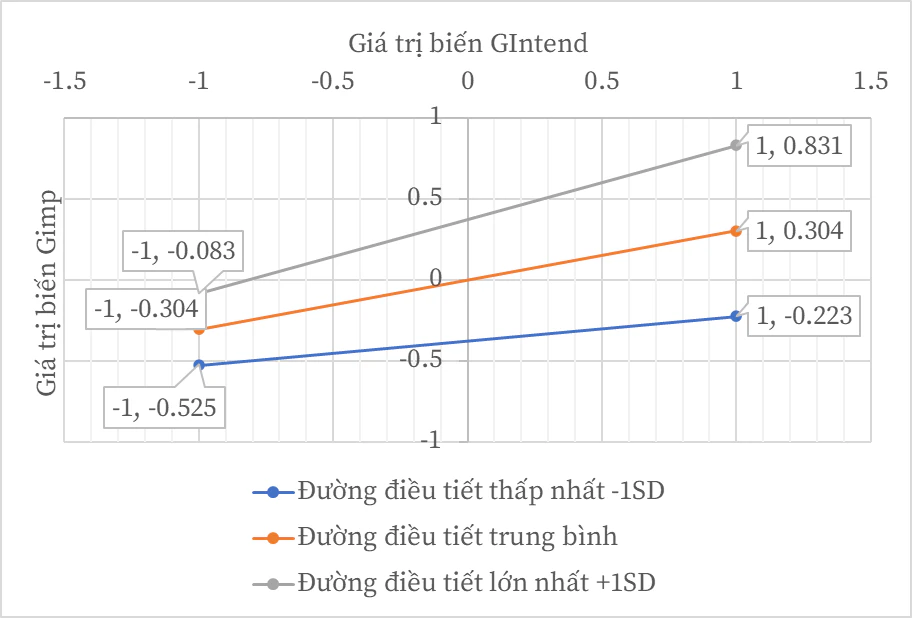
6. Simple slopes trả lời câu hỏi nào?
Simple slope là hiệu ứng của X lên Y tại một giá trị cụ thể của M. Cần báo estimate, SE hoặc CI và giá trị M được probing. Việc một slope có p nhỏ còn slope kia có p lớn không tự động chứng minh hai slope khác nhau. Bằng chứng về khác biệt nằm ở b3 hoặc một contrast trực tiếp.
Bauer và Curran (2005) cho thấy probing giúp diễn giải hình dạng tương tác sau kiểm định hệ số tích. Chọn ba slope chỉ là cách tóm tắt. Nếu slope thay đổi phi tuyến theo M hoặc mô hình có tương tác bậc cao hơn, cần công thức và đồ thị phù hợp.
Với moderator phân loại, simple slopes là slope của từng nhóm. Với moderator liên tục, mỗi slope là một điểm trên hàm b1 + b3m. Không nên gọi slope tại mean cộng trừ SD là hiệu ứng thấp và cao của mọi cá nhân.
Không kết luận moderation chỉ vì một simple slope có p < 0,05 còn slope khác có p > 0,05. Phải kiểm định trực tiếp hệ số tương tác hoặc chênh lệch slope.
7. Vùng Johnson-Neyman và giới hạn diễn giải
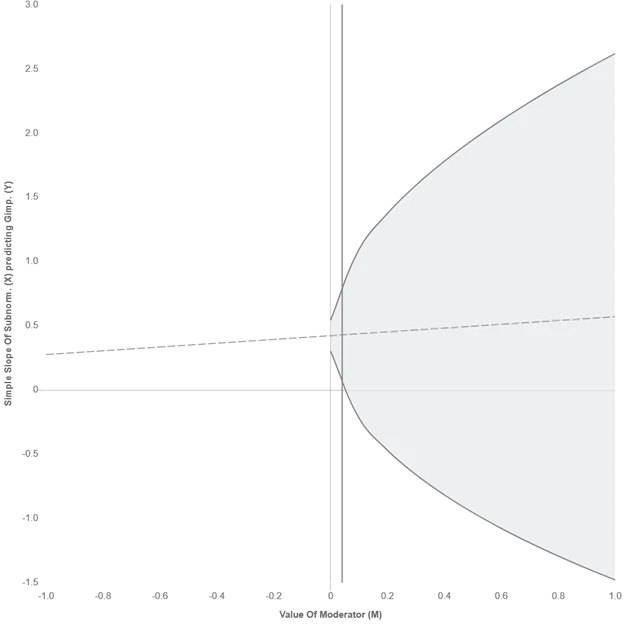
Kỹ thuật Johnson-Neyman tìm các giá trị M mà hiệu ứng có điều kiện của X chuyển giữa có và không có ý nghĩa theo alpha đã chọn. Nó dùng estimate cùng variance-covariance của hệ số thay vì chỉ probing tại ba điểm (Bauer và Curran, 2005; Preacher, Curran và Bauer, 2006).
Ranh giới Johnson-Neyman không phải ngưỡng tự nhiên của con người hoặc tổ chức. Nó phụ thuộc mẫu, mô hình, alpha, estimator và sai số chuẩn. Không nên biến một giá trị như 3,42 thành mốc chính sách chính xác nếu dữ liệu và thang đo không hỗ trợ độ chính xác đó.
Chỉ diễn giải vùng nằm trong phạm vi M có quan sát đủ. Nếu ranh giới nằm ngoài support, kết luận thực tế là hiệu ứng không đổi trạng thái ý nghĩa trong miền dữ liệu. Với moderator phân loại, Johnson-Neyman không phù hợp.
| Công cụ | Đầu ra | Điểm mạnh | Giới hạn |
|---|---|---|---|
| Simple slopes | Hiệu ứng tại vài mức M | Dễ diễn giải và báo cáo | Phụ thuộc điểm được chọn |
| Johnson-Neyman | Vùng M theo trạng thái suy luận | Dùng toàn bộ continuum | Có thể tạo cảm giác chính xác giả |
| Đồ thị dự báo | Mức Y theo X và M | Thể hiện hình dạng | Không thay kiểm định |
| Contrast slope | Chênh lệch hai slope | Kiểm định trực tiếp câu hỏi nhóm | Cần coding và covariance đúng |
8. Ví dụ số giả định: từ hệ số đến ba đường dự báo
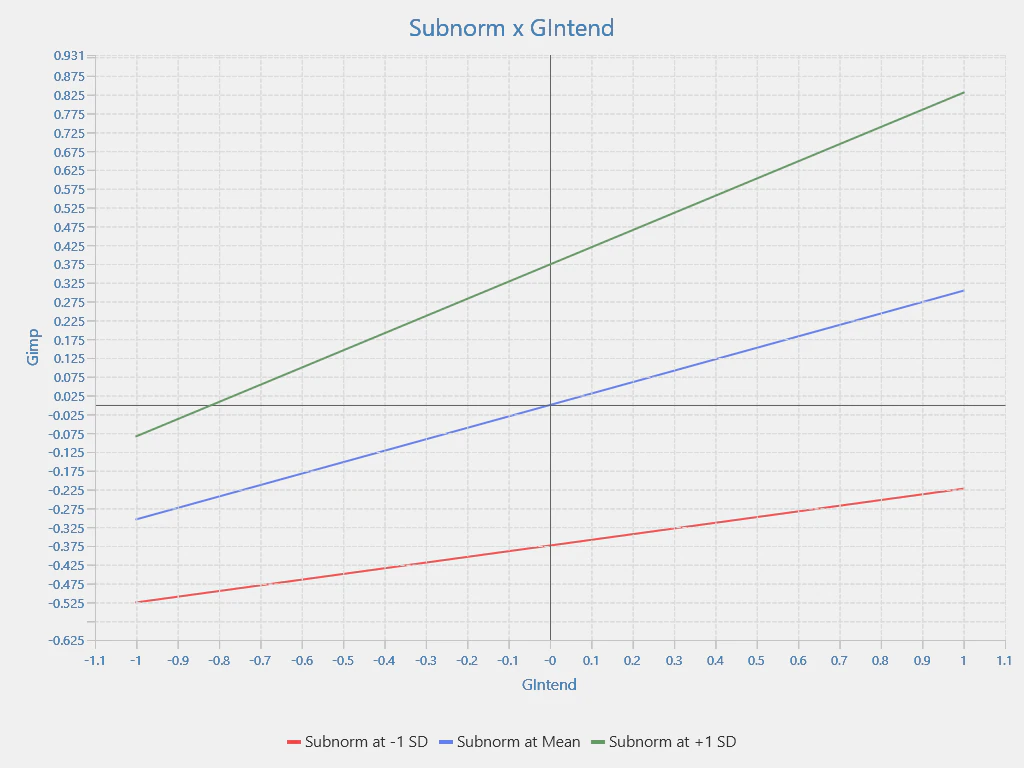
Ví dụ này là số liệu dựng để minh họa. Mô hình mean-centered cho Y = 10,00 + 0,40X + 0,25M + 0,20XM. Hệ số tương tác b3 = 0,20, SE = 0,06, CI 95% [0,08; 0,32]. Khi M tăng một đơn vị, slope của X tăng 0,20.
Tại M = -1, simple slope là 0,40 + 0,20(-1) = 0,20. Tại M = 0, slope là 0,40. Tại M = 1, slope là 0,60. Giả sử phần mềm probing cho SE lần lượt là 0,08; 0,07 và 0,09, các CI 95% tương ứng là [0,04; 0,36], [0,26; 0,54] và [0,42; 0,78].
Ba slope đều dương trong ví dụ, nhưng mức dốc tăng theo M. Đồ thị nên vẽ cùng miền X được quan sát ở ba mức M và dùng ribbon CI. Không được suy ra rằng mọi cá nhân M cao đều có Y cao hơn, vì moderation mô tả độ dốc có điều kiện chứ không chỉ mức trung bình.
| M | Công thức | Slope X đến Y | SE giả định | CI 95% giả định |
|---|---|---|---|---|
| -1 | 0,40 - 0,20 | 0,20 | 0,08 | [0,04; 0,36] |
| 0 | 0,40 | 0,40 | 0,07 | [0,26; 0,54] |
| 1 | 0,40 + 0,20 | 0,60 | 0,09 | [0,42; 0,78] |
9. Thiết kế đồ thị có thể kiểm tra
Trục phải ghi tên biến, đơn vị và phạm vi. Chú giải phải nói đường nào tương ứng với mức M nào và các mức đó được chọn bằng quy tắc gì. Dùng màu có độ tương phản và thêm kiểu đường để đồ thị vẫn đọc được khi in đen trắng.
Ribbon hoặc error bar cần ghi rõ là CI của predicted mean hay prediction interval cho quan sát mới. Hai loại khoảng không giống nhau. Trong bài moderation, CI của predicted mean hoặc conditional effect thường phù hợp với câu hỏi suy luận hơn.
Không cắt trục Y chỉ để làm các đường trông khác biệt mạnh. Nếu cắt trục giúp đọc chi tiết, phải ghi rõ và cân nhắc thêm biểu đồ phụ với phạm vi đầy đủ. Dữ liệu thô hoặc partial residuals có thể được thêm khi không làm lộ thông tin nhạy cảm.
- Trục X và Y có đơn vị.
- Mức M và coding được ghi rõ.
- Miền X không vượt support.
- Có CI với loại khoảng được chú thích.
- Màu và kiểu đường phân biệt được.
- Không dùng giao điểm bằng mắt làm kiểm định.
- Dữ liệu tạo biểu đồ được lưu.
- Số trên đồ thị khớp bảng simple slopes.
10. Các lỗi diễn giải và trình bày thường gặp
| Cách làm yếu | Vấn đề | Cách xử lý |
|---|---|---|
| Hai đường cắt nhau nên có moderation | Giao cắt trực quan không phải kiểm định | Báo b3 và CI |
| Một slope có ý nghĩa, slope kia không | Không kiểm định chênh lệch | Dùng interaction hoặc contrast |
| Luôn dùng mean cộng trừ 1 SD | Có thể ngoài support hoặc khó hiểu | Chọn mức M có căn cứ |
| Bỏ main effects khi p lớn | Áp ràng buộc sai cho mô hình | Giữ thành phần bậc thấp |
| Chia M liên tục thành cao và thấp | Mất thông tin và power | Giữ M liên tục cho kiểm định chính |
| Vẽ đường ngoài phạm vi dữ liệu | Ngoại suy không được hỗ trợ | Giới hạn miền X và M |
| Bỏ CI khỏi đồ thị | Che độ bất định | Vẽ ribbon hoặc báo bảng CI |
| Gọi ranh giới J-N là cutoff thật | Tạo chính xác giả | Báo độ bất định và support |
11. Mẫu báo cáo APA 7 và bảng kiểm hoàn tất
Mẫu dưới đây dùng số giả định ở mục 8. Thay toàn bộ hệ số, mức M và cách cố định covariate bằng kết quả thật.
Mẫu báo cáo tiếng Việt
Mô hình bao gồm X, M đã mean-center và tích X nhân M. Hệ số tương tác chưa chuẩn hóa là b = .20, SE = .06, CI 95% [.08, .32], cho thấy slope của X tăng khi M tăng. Simple slopes của X tại M = -1, 0 và 1 lần lượt là b = .20, CI 95% [.04, .36]; b = .40, CI 95% [.26, .54]; và b = .60, CI 95% [.42, .78]. Đồ thị trình bày predicted Y trong miền X quan sát chung của ba mức M; các covariate được cố định tại [quy tắc]. Phân tích Johnson-Neyman [được/không được] dùng vì [lý do và support].
- Đã báo hệ số interaction, SE và CI.
- Đã giữ X và M trong mô hình.
- Đã nêu centering hoặc standardizing.
- Đã giải thích điểm 0 của X và M.
- Mức moderator nằm trong dữ liệu.
- Đã báo estimate và CI của simple slopes.
- Không suy luận khác biệt từ hai p-value riêng.
- Johnson-Neyman chỉ dùng cho M liên tục phù hợp.
- Ranh giới J-N được giới hạn trong support.
- Covariate được cố định bằng quy tắc rõ ràng.
- Đồ thị có CI và đơn vị trục.
- Dữ liệu và code tạo hình được lưu để tái lập.
Kết luận
Đồ thị moderation tốt là bản dịch trực quan của mô hình tương tác, không phải bằng chứng độc lập. Hệ số X nhân M trả lời câu hỏi slope có thay đổi; simple slopes và Johnson-Neyman giải thích sự thay đổi diễn ra ở đâu.
Trình bày đáng tin cậy giữ đúng coding, không ngoại suy, công khai độ bất định và phân biệt ranh giới thống kê với ngưỡng có ý nghĩa thực tiễn.
Tài liệu tham khảo
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications. https://us.sagepub.com/en-us/nam/multiple-regression/book3045
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373-400. https://doi.org/10.1207/s15327906mbr4003_5
- Brambor, T., Clark, W. R., & Golder, M. (2006). Understanding interaction models: Improving empirical analyses. Political Analysis, 14(1), 63-82. https://doi.org/10.1093/pan/mpi014
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press. https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030
- Preacher, K. J., Curran, P. J., & Bauer, D. J. (2006). Computational tools for probing interactions in multiple linear regression, multilevel modeling, and latent curve analysis. Journal of Educational and Behavioral Statistics, 31(4), 437-448. https://doi.org/10.3102/10769986031004437
Ghi chú học thuật: Các số trong ví dụ được tạo để minh họa phép tính. Đồ thị và vùng Johnson-Neyman không khắc phục sai đặc tả, nội sinh, sai số đo hoặc dữ liệu nằm ngoài phạm vi quan sát.