
Quy trình báo cáo PLS-SEM minh bạch và có thể kiểm tra
Một bảng hệ số đường dẫn không tạo thành báo cáo PLS-SEM hoàn chỉnh. Người đọc cần thấy chuỗi quyết định từ câu hỏi nghiên cứu, phép đo và dữ liệu đến suy luận, dự báo ngoài mẫu và kiểm tra độ bền.
Báo cáo PLS-SEM tốt đi theo sáu lớp bằng chứng: lựa chọn phương pháp, dữ liệu, đặc tả, mô hình đo lường, mô hình cấu trúc, dự báo và độ bền. Mỗi kết quả phải gắn với cài đặt, đơn vị diễn giải và giới hạn áp dụng.
1. Sáu lớp bằng chứng của một báo cáo có thể kiểm tra
Một báo cáo PLS-SEM có thể kiểm tra phải cho người đọc biết tác giả đã quyết định điều gì, dựa trên căn cứ nào và kết quả thay đổi ra sao khi điều kiện phân tích thay đổi. Danh sách chỉ số dài không bù được cho đặc tả mơ hồ hoặc cài đặt không được công bố.
Hair và cộng sự (2019) đề xuất báo cáo có hệ thống từ lý do dùng PLS-SEM đến đánh giá mô hình đo lường và cấu trúc. Benitez và cộng sự (2020) nhấn mạnh thêm mối liên hệ giữa loại khái niệm, đặc tả mô hình và mục tiêu xác nhận hoặc giải thích. Thực hành hiện nay cần bổ sung đánh giá dự báo ngoài mẫu bằng PLSpredict và CVPAT (Shmueli và cộng sự, 2019; Liengaard và cộng sự, 2021).
Sáu lớp trong bài là kiến trúc báo cáo, không phải sáu tiêu chuẩn chấp nhận độc lập. Một kết quả thuận lợi ở lớp dự báo không sửa được phép đo sai. Một mô hình đo lường đạt yêu cầu cũng không chứng minh quan hệ cấu trúc mang tính nhân quả.
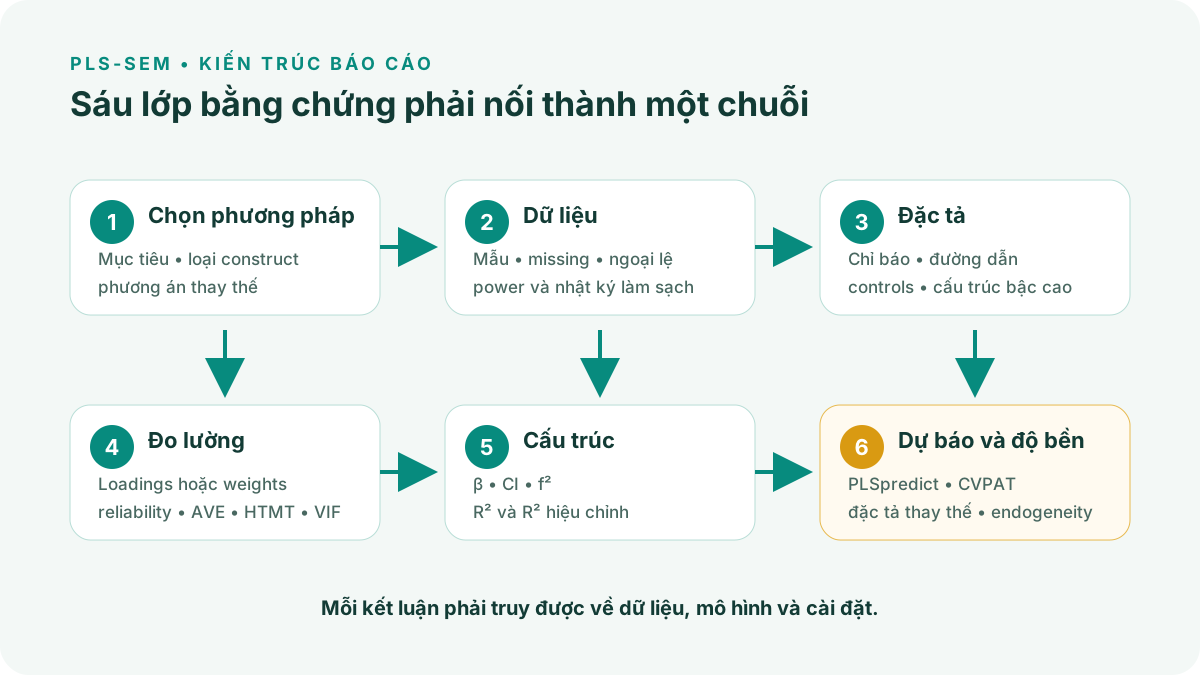
| Lớp | Câu hỏi phải trả lời | Bằng chứng chính |
|---|---|---|
| 1. Lựa chọn phương pháp | Vì sao PLS-SEM phù hợp với câu hỏi và loại cấu trúc? | Mục tiêu, loại construct, phương án thay thế |
| 2. Dữ liệu | Mẫu được tạo và làm sạch thế nào? | Khung mẫu, missing, ngoại lệ, power |
| 3. Đặc tả | Mũi tên và chỉ báo dựa trên lý thuyết nào? | Sơ đồ, giả thuyết, controls, cấu trúc bậc cao |
| 4. Đo lường | Phép đo có đủ độ tin cậy và giá trị? | Loadings hoặc weights, reliability, AVE, HTMT, VIF |
| 5. Cấu trúc | Quan hệ có độ lớn và độ bất định ra sao? | β, bootstrap CI, f², R² hiệu chỉnh |
| 6. Dự báo và độ bền | Kết luận có tổng quát và ổn định không? | PLSpredict, CVPAT, đặc tả thay thế, endogeneity |
2. Lập hồ sơ phương pháp trước khi mở bảng kết quả
Phần phương pháp phải được viết trước khi chọn kết quả thuận lợi. Hãy lưu một hồ sơ gồm phiên bản dữ liệu, mô hình, phần mềm và cài đặt. Hồ sơ này ngăn tình trạng bảng đo lường, bootstrapping và dự báo thuộc các phiên bản mô hình khác nhau.
Lý do chọn PLS-SEM phải xuất phát từ mục tiêu nghiên cứu và đặc điểm mô hình. Cỡ mẫu nhỏ hoặc dữ liệu lệch không tự động quyết định PLS-SEM. Cỡ mẫu nên được biện minh bằng power hoặc phương pháp dựa trên nghịch đảo căn bậc hai khi điều kiện phù hợp, thay vì chỉ dùng quy tắc 10 lần (Kock & Hadaya, 2018).
Ngôn ngữ nhân quả phải phù hợp với thiết kế. Dữ liệu cắt ngang và lấy mẫu thuận tiện thường chỉ hỗ trợ diễn giải quan hệ có điều kiện. Kiểm tra endogeneity giúp nhận diện một số nguồn sai lệch, nhưng không biến thiết kế quan sát thành thực nghiệm (Hult và cộng sự, 2018).
| Nhóm | Thông tin phải lưu | Ví dụ cách ghi |
|---|---|---|
| Dữ liệu | Tệp gốc, tệp phân tích, tiêu chí loại, mã missing | data_raw_01; data_analysis_03; log làm sạch |
| Mô hình | Phiên bản sơ đồ, giả thuyết, controls, chỉ báo | model_v04; thay đổi có ngày và lý do |
| Phần mềm | SmartPLS, phiên bản và hệ điều hành | SmartPLS 4.x; Windows |
| Thuật toán | Weighting, iterations, stop criterion | Ghi đúng giá trị trong hộp cài đặt |
| Suy luận | Số bootstrap, seed, CI, one-tailed hoặc two-tailed | 10.000 subsamples; fixed seed; percentile CI |
| Dự báo | Folds, repetitions, seed, loss và benchmark | 10 folds; RMSE; LM benchmark |
- Mục tiêu giải thích, dự báo hoặc kết hợp đã được nêu trước.
- Loại construct và hướng quan hệ đo lường có căn cứ lý thuyết.
- Cỡ mẫu có biện minh bằng power hoặc phương pháp phù hợp.
- Mọi thay đổi dữ liệu và mô hình có nhật ký.
- Phiên bản phần mềm và cài đặt được lưu bằng văn bản hoặc ảnh.
3. Báo cáo mô hình đo lường theo đúng loại cấu trúc
Với mô hình phản ánh, báo cáo outer loadings cùng khoảng tin cậy, độ tin cậy nhất quán nội tại, AVE và giá trị phân biệt. HTMT được thiết kế để phát hiện thiếu giá trị phân biệt tốt hơn tiêu chí Fornell-Larcker trong nhiều điều kiện mô phỏng (Henseler và cộng sự, 2015). Ngưỡng chỉ là điểm tham chiếu. Quyết định giữ hoặc loại chỉ báo vẫn phải xem nội dung khái niệm và độ bất định.
Với composite hoặc mô hình tạo thành, trọng tâm chuyển sang tính bao quát nội dung, đa cộng tuyến giữa chỉ báo, outer weights và khoảng tin cậy. Loading có thể hỗ trợ đánh giá đóng góp tuyệt đối khi weight không có ý nghĩa. Không loại chỉ báo chỉ vì weight nhỏ nếu việc loại bỏ làm hẹp miền khái niệm (Benitez và cộng sự, 2020).
Mỗi cấu trúc cần một kết luận riêng. Câu viết chung như “mô hình đo lường đạt” che mất cấu trúc nào đang có vấn đề và bằng chứng nào đã được dùng.
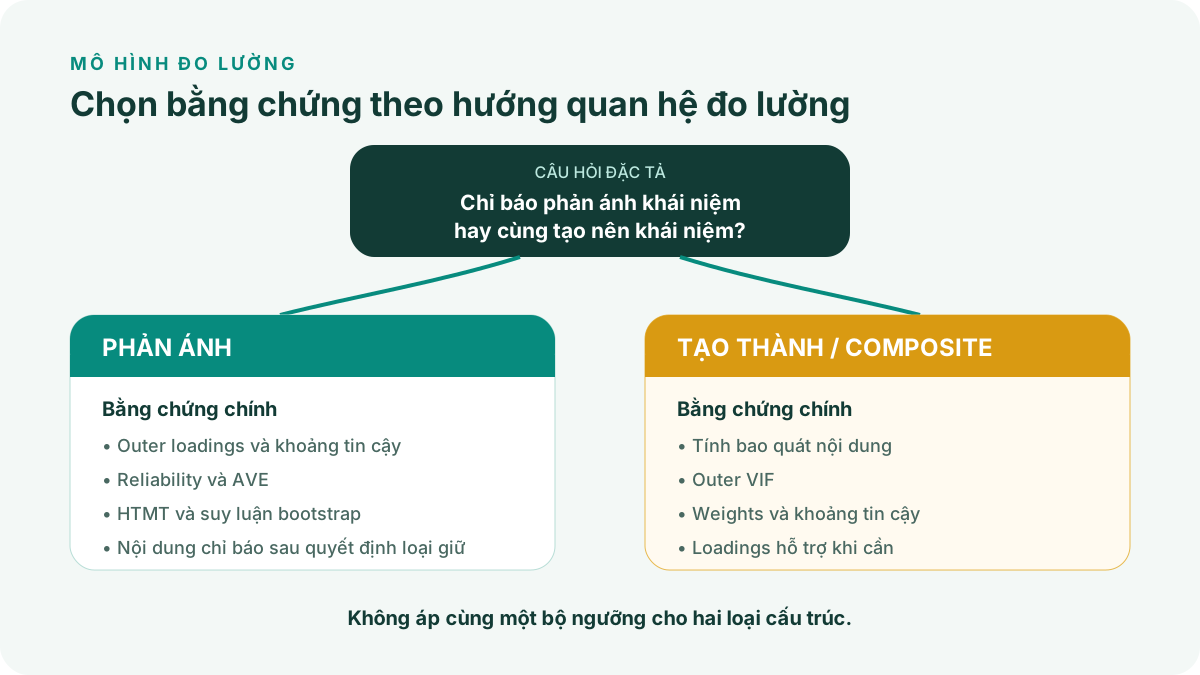
| Loại | Báo cáo chính | Câu hỏi nội dung |
|---|---|---|
| Phản ánh | Loadings và CI; alpha, rho_A hoặc CR; AVE; HTMT và CI khi phù hợp | Chỉ báo có phải biểu hiện thay thế được của cùng khái niệm? |
| Tạo thành/composite | Outer VIF; weights và CI; loadings bổ sung; tính bao quát | Mỗi chỉ báo đóng góp phần nội dung nào của khái niệm? |
| Bậc cao | Cách tiếp cận ước lượng, loại quan hệ ở từng bậc, bảng cho từng tầng | Cấu trúc bậc cao có ý nghĩa lý thuyết hay chỉ rút gọn mô hình? |
Một ngưỡng đơn lẻ không quyết định phép đo. Hãy báo giá trị, khoảng tin cậy, nội dung chỉ báo và tác động của quyết định loại giữ.
4. Đọc mô hình cấu trúc theo thứ tự có kiểm soát
Kiểm tra inner VIF trước khi diễn giải hệ số đường dẫn. Sau đó báo cáo β, khoảng tin cậy bootstrap, p-value nếu kế hoạch suy luận dùng p-value, f² và R² hoặc R² hiệu chỉnh cho từng biến nội sinh. Hệ số đường dẫn cho biết hướng và độ lớn có điều kiện; f² cho biết thay đổi sức giải thích khi bỏ một predictor; R² mô tả sức giải thích trong mẫu.
Mediation, moderation, multi-group analysis và mô hình bậc cao cần thủ tục riêng. Với mediation, báo hiệu ứng gián tiếp và khoảng tin cậy thay vì suy ra gián tiếp từ hai p-value riêng. Với moderation, nêu cách tạo tương tác, chuẩn hóa nếu có và diễn giải simple slopes hoặc dự báo tại các mức có ý nghĩa.
Các thay đổi sau khi xem kết quả phải được ghi là hậu nghiệm. Nếu thêm đường dẫn, loại chỉ báo hoặc đổi control sau khi thấy p-value, báo rõ lý do và kiểm tra độ nhạy trên đặc tả ban đầu.
| Kết quả | Trả lời câu hỏi | Không được suy ra trực tiếp |
|---|---|---|
| β và CI | Hướng, độ lớn có điều kiện và độ bất định | Quan hệ nhân quả |
| p-value | Mức tương thích với giả thuyết không theo mô hình kiểm định | Ý nghĩa thực tiễn |
| f² | Đóng góp giải thích riêng trong đặc tả hiện tại | Năng lực dự báo ngoài mẫu |
| R² hiệu chỉnh | Phương sai giải thích trong mẫu có điều chỉnh | Khả năng tổng quát sang dữ liệu mới |
Khóa mô hình cần báo cáo
Xác nhận dữ liệu, chỉ báo, đường dẫn, controls và phiên bản mô hình. Lưu sơ đồ trước khi chạy.
Kiểm tra inner VIF
Rà đa cộng tuyến ở từng phương trình nội sinh. Nếu có vấn đề, xem lại nội dung và đặc tả trước khi loại biến.
Chạy PLS-SEM Algorithm
Ghi β, R² và R² hiệu chỉnh. Kiểm tra dấu của hệ số có phù hợp cách mã hóa và giả thuyết.
Chạy bootstrapping
Dùng fixed seed để có thể chạy lại. Tài liệu SmartPLS hiện khuyến nghị 10.000 subsamples cho kết quả cuối; báo loại CI và kiểm định một hay hai phía (SmartPLS, n.d.-a).
Ghép độ bất định với độ lớn
Trình bày β và CI cùng f². Không gọi tác động lớn chỉ vì p nhỏ.
Phân tích hiệu ứng nâng cao
Báo riêng hiệu ứng gián tiếp, tương tác, khác biệt nhóm hoặc cấu trúc bậc cao cùng cài đặt tương ứng.
Ghi nhật ký quyết định
Mọi sửa đổi hậu nghiệm phải có thời điểm, lý do lý thuyết và kết quả phân tích độ nhạy.
5. Làm cho bootstrapping có thể tái lập
Kết quả bootstrap phụ thuộc cài đặt và random seed. Báo cáo chỉ ghi “đã bootstrapping” không đủ để người khác tái tạo khoảng tin cậy. Cần nêu số subsamples, seed, kiểu sign changes, loại khoảng tin cậy và kiểm định một phía hay hai phía.
SmartPLS dùng percentile CI theo mặc định và cung cấp bias-corrected and accelerated CI như một lựa chọn. Việc chọn CI phải được giữ nhất quán với kế hoạch phân tích, không đổi sau khi xem kết quả (SmartPLS, n.d.-a).
Nếu dùng kiểm định một phía, hướng giả thuyết phải được nêu trước và có cơ sở lý thuyết. Khi giả thuyết không định hướng hoặc kết quả có thể đi hai chiều, kiểm định hai phía là lựa chọn minh bạch hơn.
| Trường | Giá trị cần điền | Vì sao cần |
|---|---|---|
| Subsamples | [10.000 hoặc giá trị đã dùng] | Độ ổn định của phân phối bootstrap |
| Random seed | [giá trị cố định] | Chạy lại cho cùng kết quả |
| Confidence interval | [percentile/BCa; 95%] | Xác định cách suy luận |
| Tails | [one-tailed/two-tailed] | Phù hợp hướng giả thuyết |
| Sign changes | [cài đặt đã dùng] | Giải thích xử lý dấu giữa các mẫu |
| Phiên bản | [SmartPLS x.x.x] | Theo dõi thay đổi thuật toán và giao diện |
6. Đánh giá dự báo và độ bền của kết luận
PLSpredict tạo dự báo ngoài mẫu bằng k-fold cross-validation và so sai số của PLS-SEM với benchmark. SmartPLS mặc định dùng 10 folds; mỗi fold vẫn phải đủ quan sát để ước lượng mô hình. Báo số folds, repetitions, seed, thước đo sai số và benchmark (SmartPLS, n.d.-b; Shmueli và cộng sự, 2019).
CVPAT kiểm định chênh lệch loss cross-validated giữa PLS-SEM và benchmark hoặc giữa hai mô hình. Cần đọc cả dấu và độ lớn của chênh lệch loss trước p-value. Kết quả có ý nghĩa theo hướng loss cao hơn không phải bằng chứng ủng hộ mô hình (Liengaard và cộng sự, 2021).
Robustness nên xuất phát từ các đe dọa hợp lý: đặc tả thay thế, controls, endogeneity, heterogeneity, xử lý missing hoặc lựa chọn thước đo sai số. Mỗi phân tích phải cho biết yếu tố nào thay đổi và kết luận cốt lõi có đổi hay không (Hult và cộng sự, 2018).
| Kiểm tra | Kết quả giả định | Kết luận giới hạn |
|---|---|---|
| PLSpredict | RMSE PLS = .720; RMSE LM = .760 | PLS có sai số thấp hơn LM cho chỉ báo đang xét |
| CVPAT | Loss PLS - LM = -.014; p = .031 | Loss PLS thấp hơn benchmark theo chiều đã định nghĩa |
| Control bổ sung | β chính đổi từ .284 sang .269 | Hướng và độ lớn tương đối ổn định trong đặc tả này |
| Đặc tả thay thế | CI của hiệu ứng gián tiếp chứa 0 | Kết luận mediation không bền với đặc tả thay thế |
Toàn bộ con số trong bảng chỉ minh họa cách báo cáo. Chúng không phải kết quả của dữ liệu thật và không được dùng như ngưỡng tham khảo.
7. Đóng gói bảng, hình và tệp để người khác kiểm tra
Mỗi bảng phải có một chức năng. Bảng đo lường phản ánh không nên trộn với weights của cấu trúc tạo thành. Bảng cấu trúc cần ghép β, CI, f² và kết luận giả thuyết theo cùng một thứ tự. Bảng dự báo phải ghi đơn vị chỉ báo, loss, benchmark và cài đặt cross-validation.
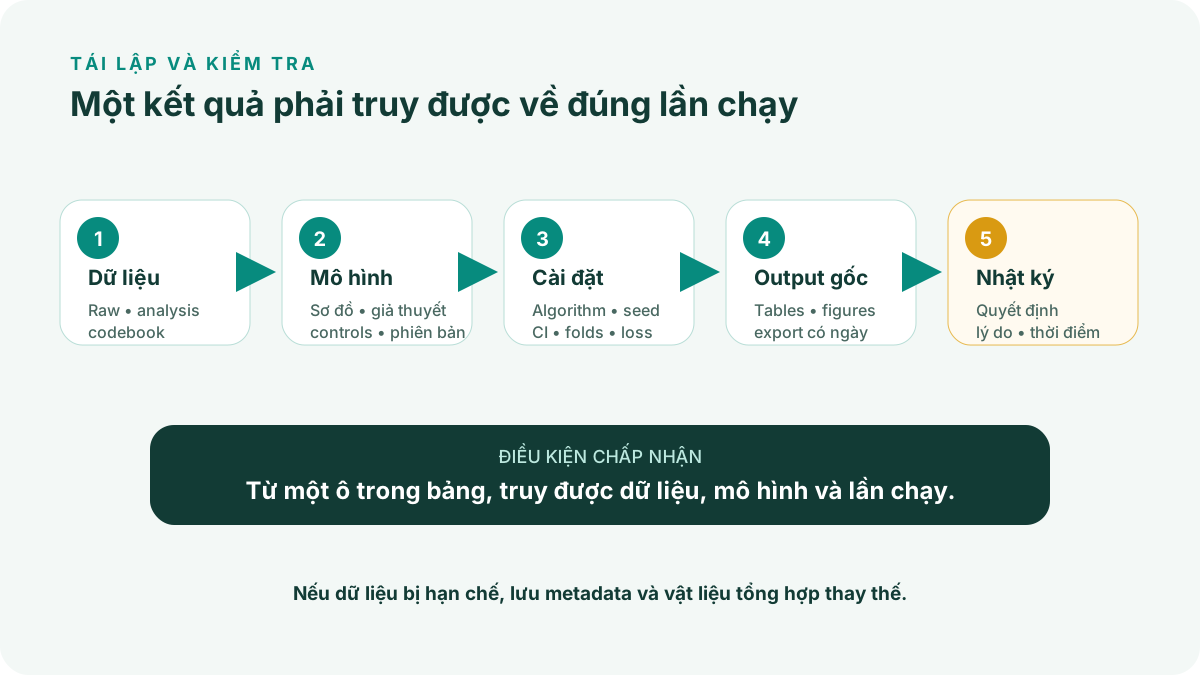
Gói tái lập tối thiểu gồm dữ liệu phân tích hoặc metadata thay thế, codebook, tệp mô hình, ảnh hoặc tệp cài đặt, bảng kết quả gốc và nhật ký quyết định. Nếu dữ liệu bị hạn chế vì bảo mật, hãy lưu quy trình tạo dữ liệu tổng hợp hoặc bảng mô tả đủ để kiểm tra logic phân tích.
Tên tệp nên phản ánh phiên bản. Không ghi đè tệp gốc. Một bảng kết quả chỉ được đưa vào bản thảo khi truy được về đúng tệp dữ liệu, mô hình và lần chạy.
- Bảng và văn bản dùng cùng số làm tròn.
- Tên cấu trúc và chỉ báo nhất quán giữa sơ đồ, output và bài viết.
- Mỗi hình có chú thích, alt text và phiên bản phần mềm khi cần.
- Tệp dữ liệu gốc được giữ nguyên; tệp phân tích có phiên bản.
- Có codebook và nhật ký làm sạch.
- Có tệp mô hình và ảnh cài đặt thuật toán.
- Có output gốc cho Algorithm, bootstrapping và PLSpredict/CVPAT.
- Các sửa đổi hậu nghiệm được đánh dấu rõ.
8. Mẫu báo cáo APA 7 và bảng kiểm trước khi nộp
Mẫu dưới đây là khung điền. Chỉ giữ những phần thực sự đã thực hiện và thay toàn bộ dấu ngoặc vuông bằng thông tin của nghiên cứu.
Mẫu báo cáo tiếng Việt
PLS-SEM được chọn vì [mục tiêu nghiên cứu và loại construct]. Phân tích sử dụng SmartPLS [phiên bản] với [cài đặt thuật toán]. Cỡ mẫu được biện minh bằng [power/phương pháp], với N = [ ]. Mô hình đo lường phản ánh được đánh giá bằng [loadings, reliability, AVE và HTMT]; cấu trúc tạo thành được đánh giá bằng [outer VIF, weights và khoảng tin cậy]. Bootstrapping sử dụng [số] subsamples, fixed seed [ ], khoảng tin cậy [loại; mức] và kiểm định [một/hai phía]. Mô hình cấu trúc được báo bằng β, khoảng tin cậy, f², R² và R² hiệu chỉnh. Đánh giá ngoài mẫu sử dụng PLSpredict với [folds, repetitions, loss, benchmark] và CVPAT [nếu dùng]. Các kiểm tra độ bền gồm [ ]; kết luận [ổn định/thay đổi] dưới [điều kiện].
- Biện minh phương pháp không dựa riêng vào cỡ mẫu nhỏ hoặc dữ liệu lệch.
- Cỡ mẫu không dựa riêng vào quy tắc 10 lần.
- Mô tả nguồn mẫu, missing, ngoại lệ và mọi trường hợp bị loại.
- Tách rõ construct phản ánh, tạo thành và bậc cao.
- Báo phiên bản SmartPLS cùng cài đặt Algorithm và bootstrapping.
- Báo β, CI, f², R² và R² hiệu chỉnh theo từng biến nội sinh.
- Đánh giá dự báo ngoài mẫu bằng PLSpredict và CVPAT khi phù hợp.
- Ghi rõ benchmark, folds, repetitions, seed và loss.
- Công bố phân tích hậu nghiệm và kết quả không thuận lợi.
- Không dùng ngôn ngữ nhân quả vượt quá thiết kế.
- Trích dẫn trong bài và danh mục tham khảo khớp hai chiều.
- Gói tái lập truy được từ bảng trong bài về lần chạy gốc.
Kết luận
Báo cáo PLS-SEM đáng tin cậy là một chuỗi quyết định có thể truy vết. Người đọc phải nhìn thấy vì sao mô hình được chọn, phép đo được đánh giá thế nào, suy luận dựa trên cài đặt nào và kết luận có bền khi chuyển sang dữ liệu giữ lại hoặc đặc tả hợp lý khác hay không.
Tài liệu tham khảo
- Benitez, J., Henseler, J., Castillo, A., & Schuberth, F. (2020). How to perform and report an impactful analysis using partial least squares: Guidelines for confirmatory and explanatory IS research. Information & Management, 57(2), 103168. https://doi.org/10.1016/j.im.2019.05.003
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2-24. https://doi.org/10.1108/EBR-11-2018-0203
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43, 115-135. https://doi.org/10.1007/s11747-014-0403-8
- Hult, G. T. M., Hair, J. F., Proksch, D., Sarstedt, M., Pinkwart, A., & Ringle, C. M. (2018). Addressing endogeneity in international marketing applications of partial least squares structural equation modeling. Journal of International Marketing, 26(3), 1-21. https://doi.org/10.1509/jim.17.0151
- Kock, N., & Hadaya, P. (2018). Minimum sample size estimation in PLS-SEM: The inverse square root and gamma-exponential methods. Information Systems Journal, 28(1), 227-261. https://doi.org/10.1111/isj.12131
- Liengaard, B. D., Sharma, P. N., Hult, G. T. M., Jensen, M. B., Sarstedt, M., Hair, J. F., & Ringle, C. M. (2021). Prediction: Coveted, yet forsaken? Introducing a cross-validated predictive ability test in partial least squares path modeling. Decision Sciences, 52(2), 362-392. https://doi.org/10.1111/deci.12445
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322-2347. https://doi.org/10.1108/EJM-02-2019-0189
- SmartPLS. (n.d.-a). Bootstrapping. https://smartpls.com/documentation/algorithms-and-techniques/resampling-and-inference/bootstrapping/
- SmartPLS. (n.d.-b). PLSpredict. https://smartpls.com/documentation/algorithms-and-techniques/prediction-and-segmentation/predict/
Ghi chú học thuật: Tên slug giữ mốc 2022 theo URL cũ. Nội dung đã được cập nhật theo nguồn phương pháp và tài liệu SmartPLS hiện hành đến ngày 30/10/2026.